001|LSTM:让远处的误差仍能教会网络记忆
论文:Sepp Hochreiter、Jürgen Schmidhuber,Long Short-Term Memory,1997,Neural Computation。作者提供的原文 PDF。本文讨论 1997 年原始结构;后来常见的遗忘门不属于这一初版。
先接住前作的问题
本系列从Day 0 的阅读路线提出的“信息怎样跨位置传递”出发。普通循环状态已有递归信息路径,未解决的是结尾误差能否有效训练很早的写入动作;本篇先处理这个优化问题。RNNLM后来采用简单循环单元做语言建模,是应用与单元的教学对照,并非 LSTM 的直接后继版本。
五个前置概念
理解本篇需要五个概念:循环状态是跨步传递的向量;BPTT 是展开时间后的反向传播;梯度消失是远程导数尺度衰减;门是可学习的乘性开关;信用分配是判断早期事件怎样影响后期误差。能区分这五项,才不会把“长短期记忆”只记成一个名称。
一、问题设定:结尾的误差怎样教会网络保存开头信息
一句话开头给出条件,结尾才要求使用它,中间都是干扰。普通循环网络 形式上可依赖全部历史,其中 是输入、 是状态;但误差需要穿过许多局部导数的乘积,尺度持续小于一会衰减,大于一又可能爆炸。问题不只是怎样表示记忆,而是末端误差怎样训练最初的保存动作。
问题因此包含两个层次。表示层面问“是否存在一组参数可以保存信息”;优化层面问“实际梯度是否能找到它”。仅证明循环结构有表达能力,无法解释为什么随机初始化后训练失败。把学习率调大也不改变远程与近期梯度的相对比例,反而可能让近期信号过强。
原论文主要研究监督序列学习。输入是人工构造的符号或实数序列,输出是需要利用早期信息的预测或分类;反馈是预测误差。这里没有 RL 中的策略、环境奖励和 Critic。将 LSTM 放入语言模型或强化学习是后来的应用方式,不能倒过来把这些应用设定当作原论文实验。
二、沿恒等存储路径推导输入门与输出门
先看原论文图1(PDF第7页):中央标为1.0的自连接是 CEC,两侧乘法节点分别控制写入与读出。图中没有现代遗忘门;箭头表示信息流,不能当作完整反向传播规则。
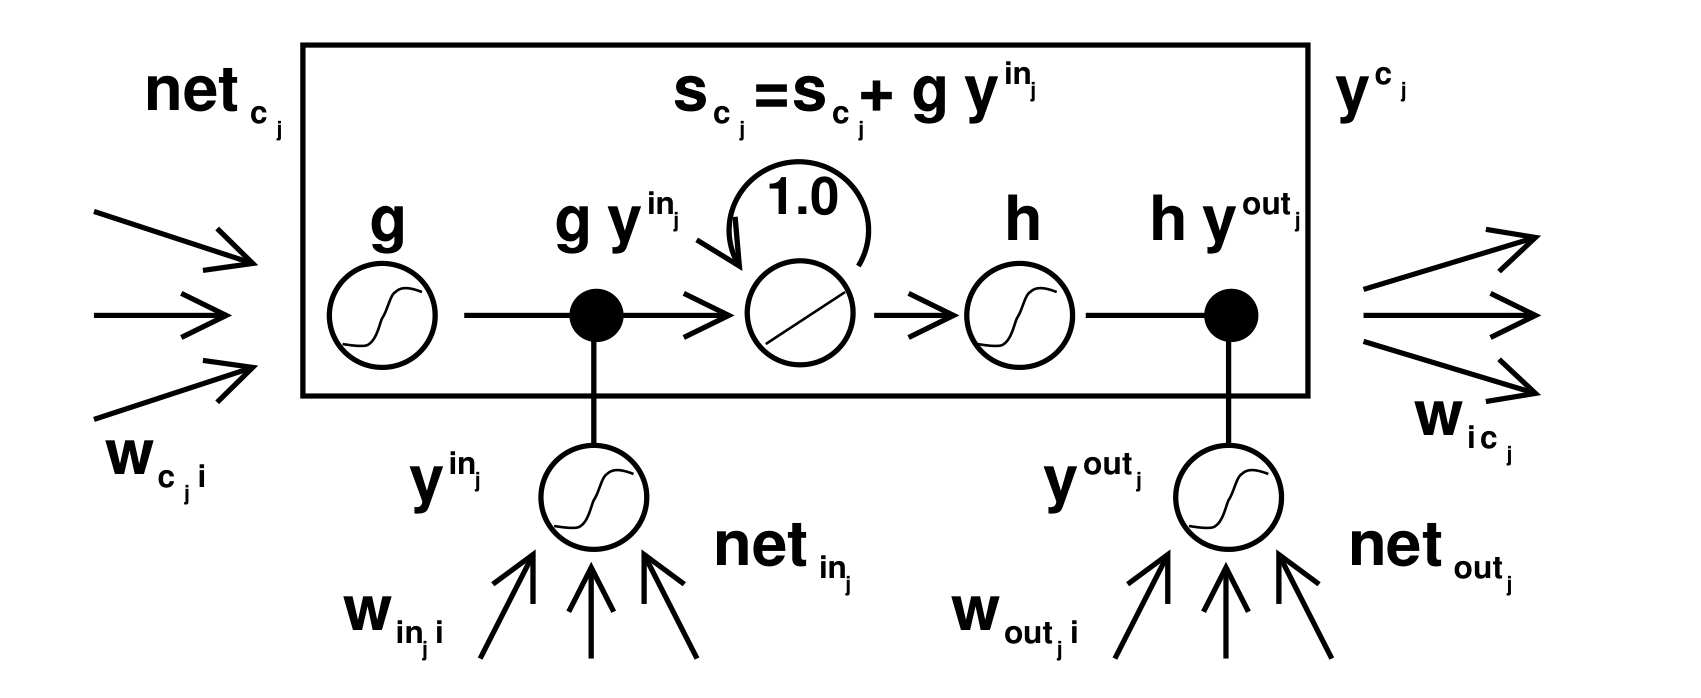
原始设计中的内部状态可以用以下教学式表达:
是内部记忆, 是输入门, 是候选写入内容, 是输出门, 是输出非线性, 表示逐元素相乘。输入门决定当前内容是否应写入;输出门决定记忆是否应影响外部计算。原始算法还有特定连接与梯度处理,上式仅突出结构思想。
若暂时只看状态到自身的直接连接,导数是 1。无新内容写入时,状态可以原样保留,这就是 constant error carousel 的关键直觉。需要特别注意,“存在导数为 1 的路径”不意味着全网络所有梯度都恒定,也不意味着门的训练永不困难。其他计算路径、损失与输入分布仍然影响实际优化。
今天教材常写的 加入了遗忘门。用它讲现代 LSTM 没有问题,但若讨论 1997 年的贡献,应说明版本差异。否则会把后来解决连续流重置和遗忘的问题,错误归给初版结构。
从一个标量递推看见梯度路径
把普通 RNN 暂时简化为 ,其中 是固定标量权重, 是输入, 分别标记早期与末端时间;固定中间输入后,末端状态对早期状态的导数为 。困难在乘积,而不是最后一次求导。LSTM 把这条反复经过非线性的路径改成加法累积:展开得到 。沿 CEC 自连接传播时,早期状态不必在每一步重新通过饱和非线性;写入仍要穿过输入门,读出仍要穿过输出门。因此“保住已写入内容的梯度”和“学会何时写入”是不同的优化子问题。原文 §3.2—§4(PDF第5—7页) 正是先分析普通恒等记忆的读写冲突,再引入两个门。
可手算的教学实验。 若一条普通循环路径每步导数为 ,100 步后只剩 。相反,令 ,第一步 ,此后输入门为零,则 。若门未完全关闭,每步泄入 ,则 :恒等路径保护梯度,并不自动保护内容免受错误写入。这个反例也解释为什么只加一条跳连不足以替代门。
构造一条序列:第一步给出一个数字,后面 99 步都是无关噪声,第 101 步要求输出第一步数字。理想门控在第一步写入,中间关闭输入,在最后打开输出。这个例子不是论文结果,而是用来区分“存储”“不被覆盖”和“按时取出”三个动作。
将读门与存储状态分开做一次干预
在前面的保留实验上,只把末步输出门从1改成0:内部记忆仍为0.6,外部读出却为0。由此可设计两个独立检查:直接观察状态确认是否保存,再改变读门确认是否能取出。仅凭最终输出为零无法区分“忘了”与“没读出来”;这也解释原图为什么需要把存储线和读出乘法节点分开画。
教法联系:Christopher Olah的Understanding LSTM Networks。算例为本文自构。
三、按原版连接和梯度规则实现记忆单元
输入:监督序列 x[1:T]、目标 y、可训练门与候选变换
初始化内部状态 c、外部输出 h
对每个时间步 t:
    根据当前输入及允许的循环连接计算输入门 i
    计算候选内容 g
    c ← c + i * g                 # 原始恒等自连接的教学表示
    计算输出门 o
    h ← o * activation(c)
根据任务读出预测,并与监督目标计算损失
按原始算法规定的梯度路径与截断规则更新参数
输出:能够选择写入、保持和读出的序列模型
四、从人工长时延任务读出学习难度
三者不能混成“LSTM 直接优化记忆长度”。记忆长度是任务条件或行为表现,不是公式中单独最大化的量。
作者在人工长时延任务上展示了学习优势,其中涉及超过 1000 步的时延。
实现明确后,检查任务是否真的依赖早期输入,并分开读时延、干扰和训练工作量。
| 项目 | 原论文范围及阅读要点 |
|---|---|
| 任务 | 第 5 节的人工长时延任务,含实值、噪声和符号模式 |
| 数据 | 按任务规则生成;不是大型自然语言预训练语料 |
| 对照 | BPTT、RTRL 等循环学习方法,以及论文讨论的其他方法 |
| 指标 | 学习是否成功、训练工作量及可跨越的时延,按任务分别阅读 |
| 预算 | 各实验单独给定;不能用一个现代 GPU 小时数概括 |
| 重复与不确定性 | 关注第 5 节各任务的成功运行统计;不把单次成功视为平均可靠性 |
证据一,第 3 节误差传播分析。作者展示普通循环路径上误差信号如何包含反复相乘的因子。它解释了优化困难的来源,但不是“所有普通 RNN 在所有任务上都会失败”的定理。
证据二,第 4 节架构与附录 A.1。门控和特殊内部连接给出了可执行的解决机制,而不仅是关于记忆的比喻。复现时要保留原版连接与梯度规则,若直接调用现代框架默认 LSTM,得到的是相关但不同的算法。
证据三,第 5 节实验与第 6 节讨论。人工任务提供关于长时延学习的受控证据,作者同时讨论适用特点。实验能够说明在这些构造中学习更容易,不能证明真实文本中的语义记忆、检索精度或语言生成质量。
读原表3。 左两列分别控制时延与干扰符号数,最右列是达到成功标准所需的训练序列数。上半部随时延增加同时扩大可用干扰符号集合;下半部固定长时延、增加同一种干扰重复出现的机会,学习代价明显不同。这是特定人工任务的训练统计,不能把最后一列当作自然语言任务的通用记忆容量。
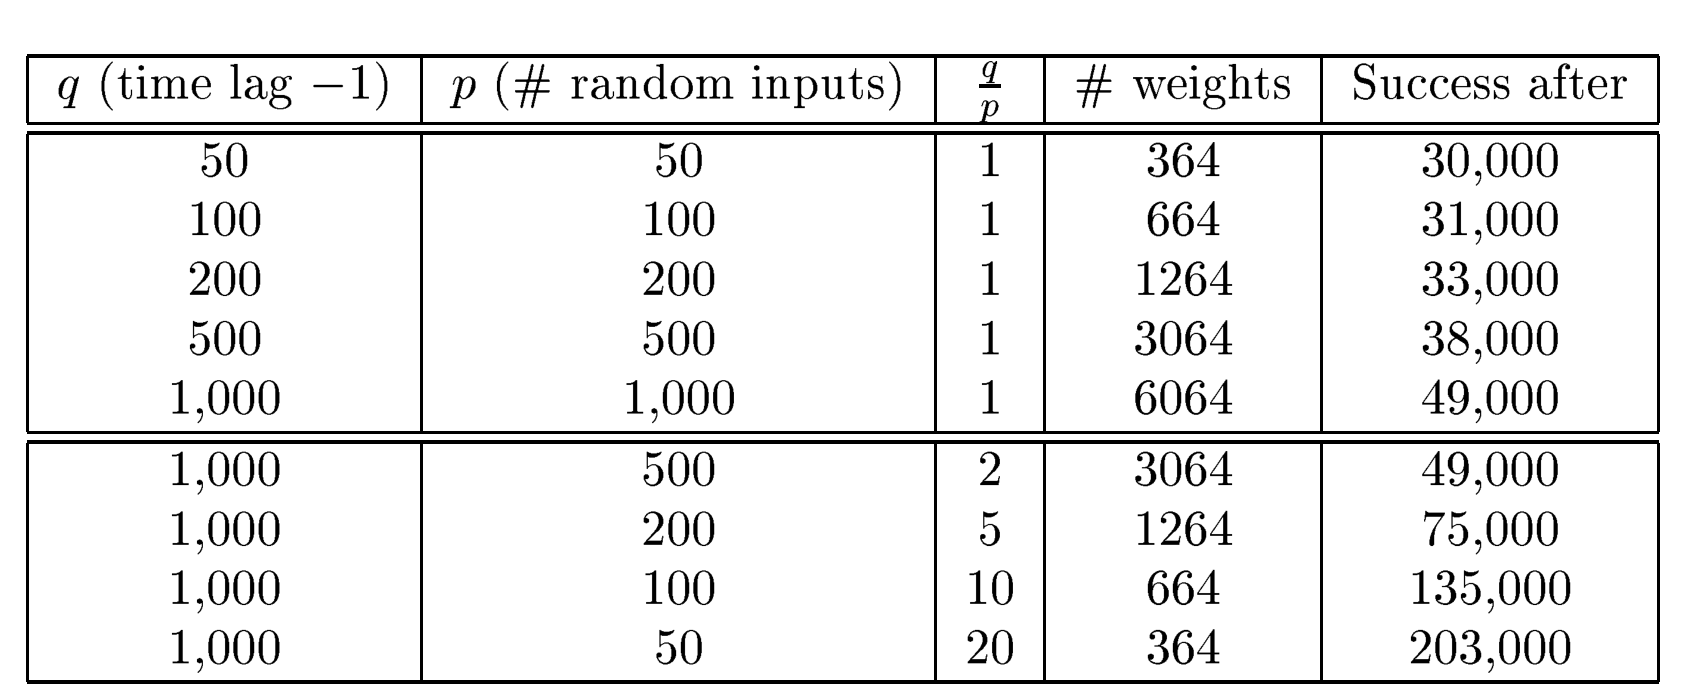
这里最有价值的公平性问题,是任务是否真的要求长程记忆。如果中间输入本身泄露了答案,或者局部统计可以预测结果,模型并不需要保存早期条件。反过来,只有不可预测干扰而没有可学习标记,也可能让任务本身没有足够信息。一个好实验需要同时控制时延和信息位置。
五、梯度能保留,内容为什么仍会被覆盖
再把任务改成同时记住 100 个独立数字。即便每个数字都需要长期保持,固定维度状态的容量和读出方式也会成为瓶颈。由此可以理解为什么梯度传播改善不等于无限记忆。模型仍需要学习哪些信息值得保留,并解决多个事实相互干扰的问题。
真正的新意在于对长期信用分配作出结构性处理:不是单纯增加层数,而是让存储通路与输入输出变换部分分工。代价包括更多参数、顺序计算以及结构实现复杂性。本文的分析是,后来的注意力并非使这个问题消失,而是通过直接访问过去表示改变了信息路径和资源取舍。
六、把本篇机制再推进一步
1. 若输入门每步漏入少量噪声,恒等路径还解决了什么?
参考答案:它仍保留内部直接路径的导数,却不保证存储内容不变。正文中每步漏入0.001会改变最终数值,说明内容保护还依赖门控;可固定序列和初始化,分别改变门的泄漏与时延,区分梯度保持和错误写入。这个消融是教学建议,不是原文新增结果。
七、把存储模块接到序列任务,再改变读取接口
恒等记忆仍要学习何时写入。到RNN语言模型继续看另一种循环状态怎样压缩词历史,并检查实际反传长度;两者是记忆机制的教学对照,不能把RNNLM写成原版LSTM的直接实现。
自测与参考答案
1. 为什么把普通 RNN 的学习率提高十倍,不能根本解决长时延梯度消失?
学习率同时放大近期和远程更新,而时间链上的相对衰减仍存在。若远程梯度比近期小很多,统一放大无法恢复合适比例,近期梯度还可能先造成不稳定。结构性改变针对的是传播路径,学习率针对的是整体更新尺度。
2. 既然内部自连接导数为 1,是否说明 LSTM 不会梯度爆炸或遗忘?
不是。这只描述特定直接路径,其他路径仍可放大误差;输入门持续写入会改变状态,多个内容也会干扰。原始结构与现代遗忘门版本还需要分开讨论。可靠记忆是结构、训练和任务共同产生的行为。
3. 怎样设计实验,证明模型确实使用了早期信息?
固定后半段噪声,仅改变第一步内容,检查输出是否随之改变;再删除或打乱第一步标记,观察表现是否下降。训练和测试使用不同延迟与噪声序列,并报告多次初始化。这样才能排除靠中间泄露信息或记忆训练样本完成任务的解释。