086|DeepSeekMath:数学数据、在线探索与组内相对优势
论文:Zhihong Shao、Peiyi Wang 等,DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models,2024。采用原文 v3;模型资源见官方仓库。以下解释区分数学领域继续预训练与强化学习的增益。
先接住前作的问题
PPO用价值估计构造优势,本篇直接保留概率比裁剪,改为同题组内比较以省去学习价值函数。领域语料和SFT也是关键阶段;DeepSeek-R1随后沿用GRPO,但其规则奖励与长推理训练不能倒写成本篇配置。
五个前置概念
五个前置概念:策略梯度按收益调整生成概率;优势比较行动收益与基线;重要性比率联系旧策略采样和当前策略更新;KL 正则约束分布偏移;Pass@K 与 Maj@K分别关心候选中是否存在正确解和投票能否选到正确解。
一、问题设定:较强数学模型怎样把更多概率分给已有正确路径
语言生成的状态是题目与已有前缀,动作是新token,终止于结束或长度截断。奖励评价整条解答或推理步骤,更新中的策略不断重新生成答案,因此是在线采样训练;本篇要区分增加数学知识与重新分配解答概率各自的贡献。
策略就是语言模型。奖励模型负责判断输出质量;价值模型则估计当前前缀的未来收益。二者功能不同:删掉价值模型不能推出“不需要评分器”。这篇论文的 GRPO 训练仍使用从数学基础模型初始化的奖励模型。
对于长回答,最终才出现的评分很难为所有中间位置提供准确价值监督。PPO 常通过另一个网络拟合价值、计算优势;GRPO 则问:“这条答案比同一题的其他答案好多少?”前提是同题采样能够产生有区分度的得分,且评分方向大体可信。
二、区分领域训练、示范与组内相对奖励
1. 从“找数学网站”变成可迭代的语料收集
以 OpenWebMath 为种子训练 fastText 分类器,从去重后的 Common Crawl 召回候选网页;再按域名统计数学网页比例,人工识别遗漏的数学 URL 区域,扩展正样本后重新训练。四轮得到约 35.5M 网页、120B token。
分类器并不证明网页内容正确。它把“与种子语料相似”作为召回信号,再通过模型训练和下游评测判断这套筛选是否有用。对基准问题和答案做精确 n-gram 过滤,可以降低直接重复;无法保证改写题、相近题型或原始代码模型中的污染已清除。
数学语料的独立规模与实际训练消耗也不同。7B 继续预训练使用 500B token,混合数学网页、数学代码、arXiv、GitHub 代码与普通语言;不能把 120B 写成全流程训练量。
2. SFT 教回答方式,GRPO 调整当前答案分布
SFT 使用数学题与解答,包含自然语言推理、程序推理和工具交错推理。随后 GRPO 对题目 采样 个输出 ,计算奖励 。结果监督下,同一回答的各 token 共用一个优势:
这里 是组内均值。它把题目难度的一部分消掉:奖励 0.7 是好是坏,取决于这道题其他答案的表现。标准差归一化又改变不同题的梯度尺度,因此不能把它仅理解为不影响训练的数值技巧。全部奖励相同会使原式分母为零;实现必须明确零方差处理,不能直接照抄数学式计算。
令 ,论文式 3 的核心为:
控制更新幅度, 控制偏离参考策略的惩罚。每条回答先按自身长度平均,再在组内平均,这一权重选择值得保留,不能擅自改成所有 token 统一平均却称为原始 GRPO。
论文使用 ,其中 。这个量非负,在两分布相等时为零。其作为 KL 估计的期望性质依赖采样分布;若样本来自旧策略而当前策略已更新,不能忽略分布差异便宣布任意重用次数下都严格无偏。
二元奖励时,组标准差实际上给稀有结果多大权重?
为看清归一化的作用,取一个教学特例: 条回答中有比例 得1,其余得0,并采用总体标准差。组均值为 、方差为 。只要 ,成功与失败回答的优势分别为
这里 是当前采样组的经验成功比例,不是已知的真实成功概率。式子说明:同样一个正确回答,在几乎全错的组内会有较大正优势,在几乎全对的组内则较小;与此同时,罕见的失败会收到较大负优势。它是两侧对称的标准化效应,不应只描述成“奖励困难题”。
原创教学算例。 四个奖励为 ,则 ,成功优势为 ,失败优势各为 。四项均值仍为0,平方均值为1。当奖励变成 ,符号分布对调。这些优势随后还要乘概率比、经过裁剪和序列长度权重,不能直接当成最终参数更新量。
本篇实际学习型奖励可以是连续分数,上例只拆出标准化机制。小组的 有采样噪声,极端组又失去相对信号;增大 可改善估计但增加生成成本。这与图7中“概率质量重新分配”的观察相呼应,却不构成模型能力上界的证明。
3. 过程评分与迭代评分器
结果监督把一个分数分给整条回答,难以定位早期错误。过程监督对推理步骤评分,先在组内标准化,再把当前位置之后的步骤得分累加为优势。它提供更细的信用分配,却需要更可靠、更昂贵的步骤监督。
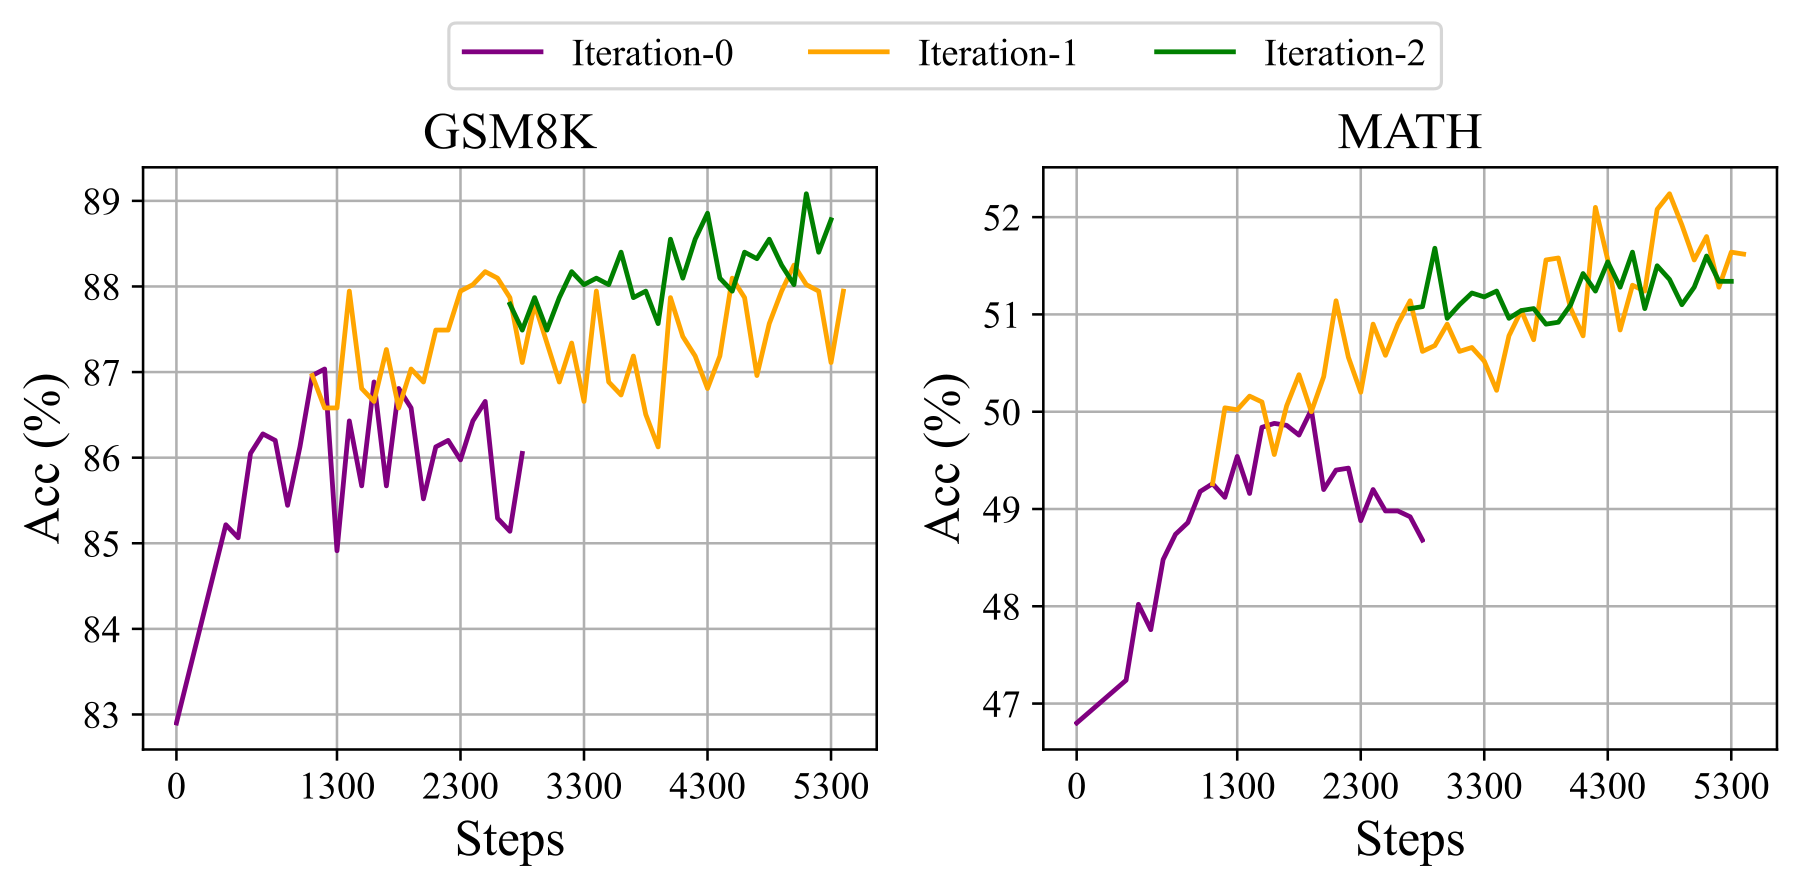
迭代版本还会用新策略生成的数据更新奖励模型,混入历史数据回放,再重设参考模型。参考策略、采样旧策略和当前待更新策略是三个角色,不应合并成一个名字。
这是算法 1 的教学改写,其中零方差处理提示是实现要求,不是原文给出的具体阈值。没有把后续论文中的规则奖励版本倒写进这篇论文。
以下是自构例子。对同一题采样四个答案,评分为 。若使用总体标准差,则均值为 0.5,标准差为 0.5,优势为 。算法倾向提高前两条路径、压低后两条路径的概率。
组标准差的定义会改变优势尺度
同组奖励(1,1,0,0)的总体标准差为0.5,样本标准差约0.577。前者得到±1优势,后者约±0.866;排序相同,梯度与参考KL的相对尺度却改变。实现应明示方差分母与零方差处理,并用这个小组核对,不能只说“做了标准化”就默认所有程序等价。
教法联系:Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla的Illustrating Reinforcement Learning from Human Feedback。算例为本文自构。
三、在线采样同题答案并分别维护参考与旧策略
若四条答案都得 1,原始归一化失去分母,也没有相对高低可学。若前三条“答案正确但推导碰巧”、第四条“推导正确但抄错结论”,只看结果的更新还可能奖励较差推理。过程奖励可以缓解这一点,但前提是步骤评分可靠。
输入:数学 SFT 策略、奖励模型、训练题目、组大小 G
for 外层奖励模型迭代:
    reference = 冻结当前策略快照
    for 训练批次:
        old_policy = 当前策略快照
        对每道题用 old_policy 采样 G 条解答
        用奖励模型评分整条解答或各推理步骤
        按同题分组计算均值、标准差及优势
        若组内无区分度:采用明确的零方差处理
        计算 token 概率比、裁剪目标与参考 KL 惩罚
        更新策略;该主实验每轮探索后只更新一次
    用新解答及历史回放数据继续训练奖励模型
输出:更新后的数学策略
四、用阶段对照及Maj@K、Pass@K区分收益来源
表5 中,7B 模型无工具的 MATH 准确率从监督微调后的 46.8% 提升至强化学习后的 51.7%,即增加 4.9 个百分点。
数据曲线发生在GRPO之前,SFT到RL对照定位后训练收益;再联合读取投票和覆盖曲线,避免把概率重分配等同能力集合扩张。
| 环节 | 设置与预算 | 对照或指标 | 能回答的问题 |
|---|---|---|---|
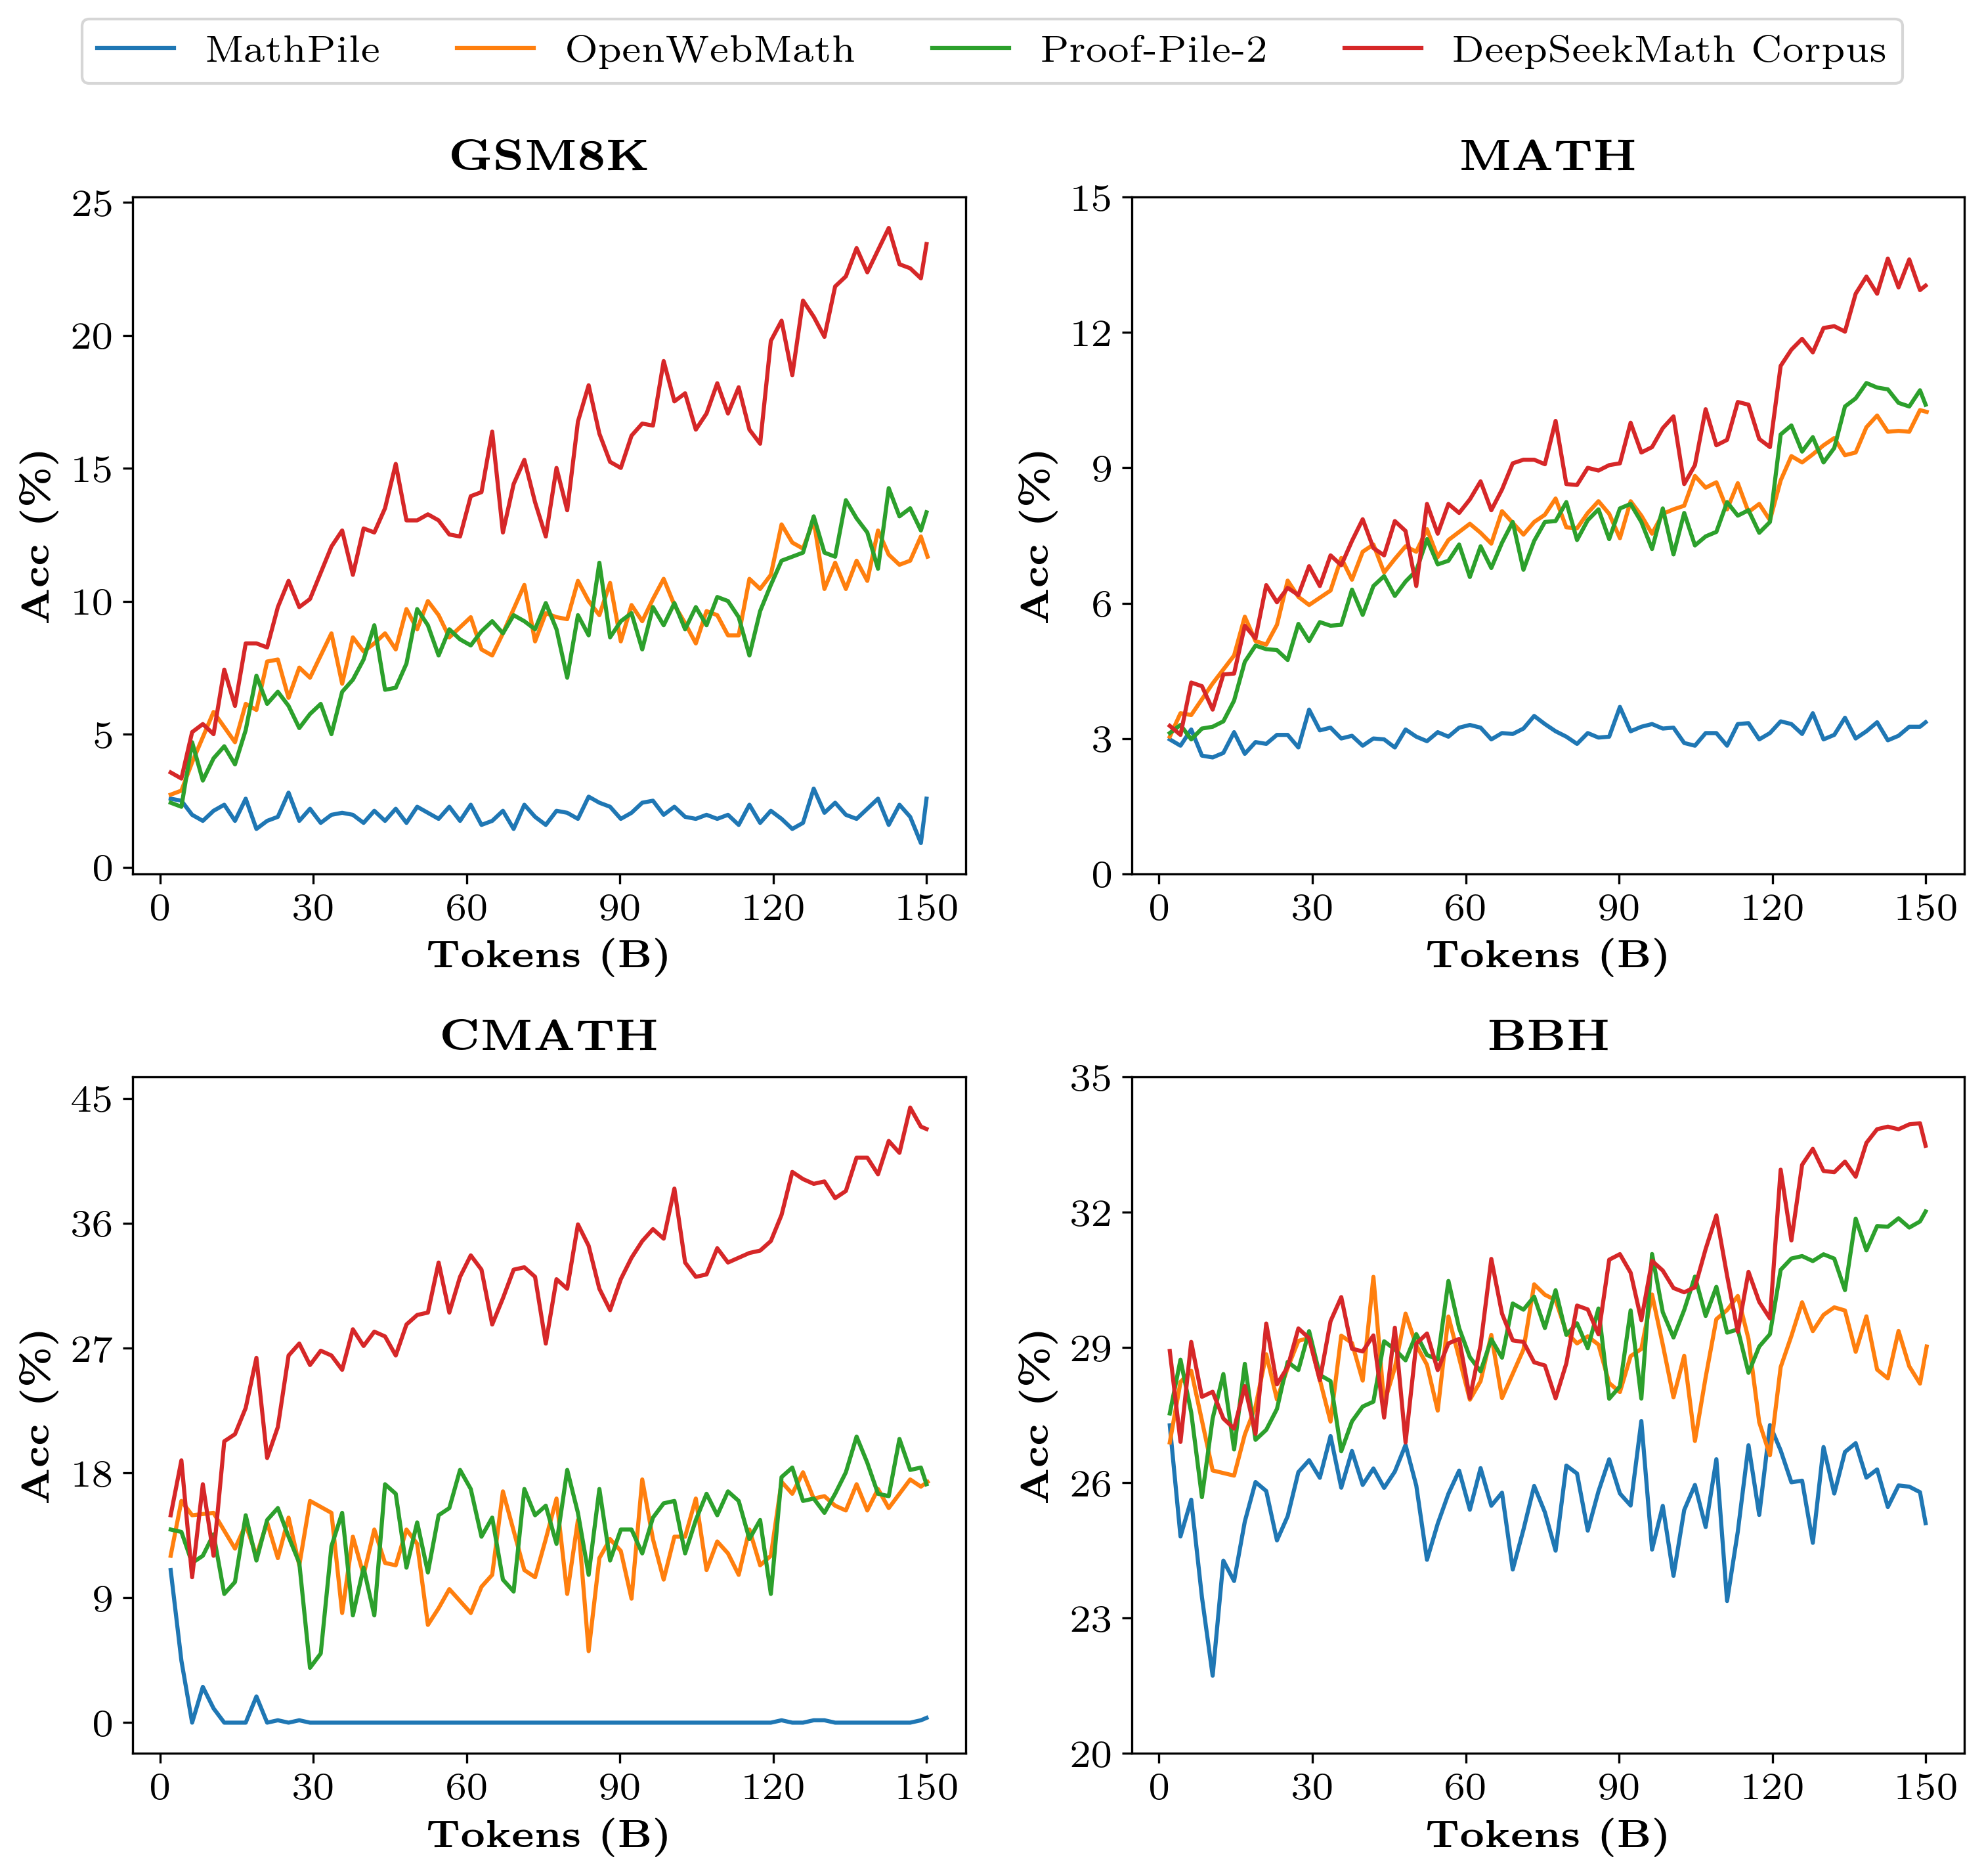
| 数学语料比较 | 1.3B 基础模型;每种语料训练 150B token;4K 上下文、4M token 批量 | MathPile、OpenWebMath、Proof-Pile-2;中英文数学准确率 | 相同训练 token 预算下哪套数据更有效 |
| 7B 继续预训练 | 500B token;数学网页 56%、数学代码 4%、arXiv 10%、GitHub 20%、普通语言 10% | 基础模型数学、代码与语言任务 | 最终领域模型的综合能力 |
| 监督微调 | 776K 示例;拼接至 4K;500 步、批量 256、学习率 | 无工具与工具推理分开 | 示范训练后的能力 |
| 强化学习 | 约 144K GSM8K/MATH 相关题;每题 64 输出、上限 1024;批量 1024;策略学习率 、KL 系数 0.04 | 与同一 SFT 起点比较 | 在线奖励优化带来的变化 |
| 方法诊断 | 1.3B 方法比较;7B 迭代与多样本评测 | 图5、图6、图7;准确率、Maj@K、Pass@K | 在线采样、过程评分与答案分布的作用 |
依据 §2.2、§2.3、§3.2、§4.2。这里的批量、序列拼接与每题多次采样不是同一个单位,不能将数字直接相乘后声称得到了论文未列出的完整 GPU 预算。完整训练的硬件时数及多随机种子置信区间未在所引主设置中明确报告。
语料比较控制了处理的 token 总数,但不同语料独立规模差异很大,小语料会重复更多轮。因此结果体现数据质量、覆盖和重复率的综合作用,不是孤立的“单条网页质量”测量。闭源模型分数还有模型版本、提示和外部训练数据差异,适合定位水平,不构成严格算法消融。
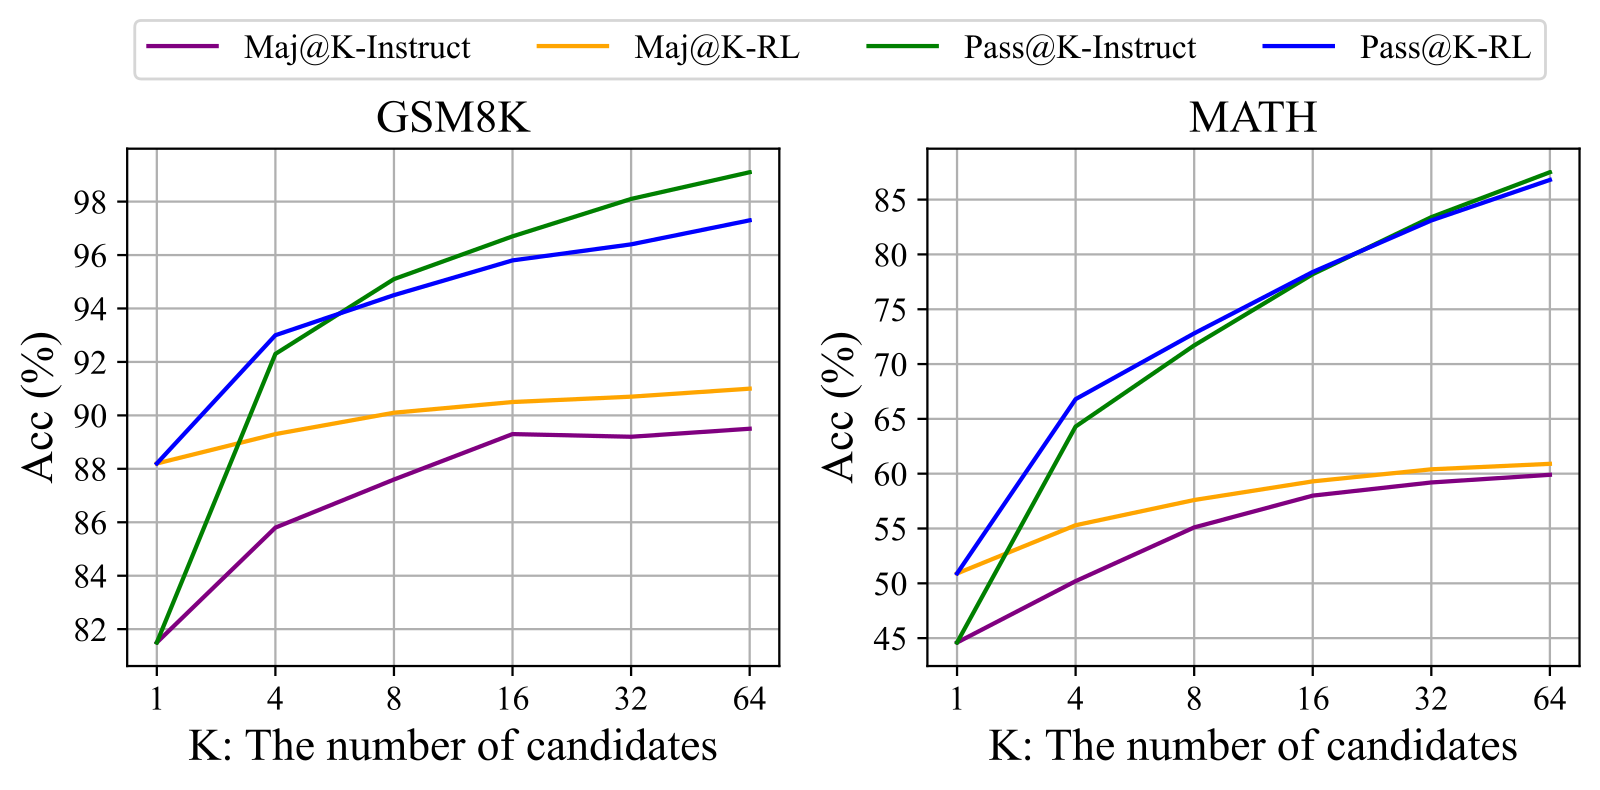
证据一:表1 与图3,数据确实重要。 同样 150B token 训练量,1.3B 模型在 DeepSeekMath 语料上的 GSM8K 为 23.8%,Proof-Pile-2 为 14.3%;MATH 为 13.6% 与 11.2%。曲线补充训练过程中差异,并非只挑一个终点。它支持这套语料配方更有效,不能说明 GRPO 导致了这些增益,因为此时尚未运行 GRPO。 Maj@K 和 Pass@K 共用候选预算 K,但前者是投票结果、后者是至少一个候选答对;两条趋势不同正是区分概率重分配与覆盖扩张的依据。
证据二:表5,RL 在较强 SFT 起点上仍有提升。 GSM8K 从 82.9% 到 88.2%,MATH 从 46.8% 到 51.7%,均为该模型无工具的 Top1 结果。工具模式 MATH 则从 57.4% 到 58.8%,增加 1.4 个百分点;改善幅度随输出方式变化。不能把无工具 51.7% 与多次投票 60.9% 当成同预算结果。
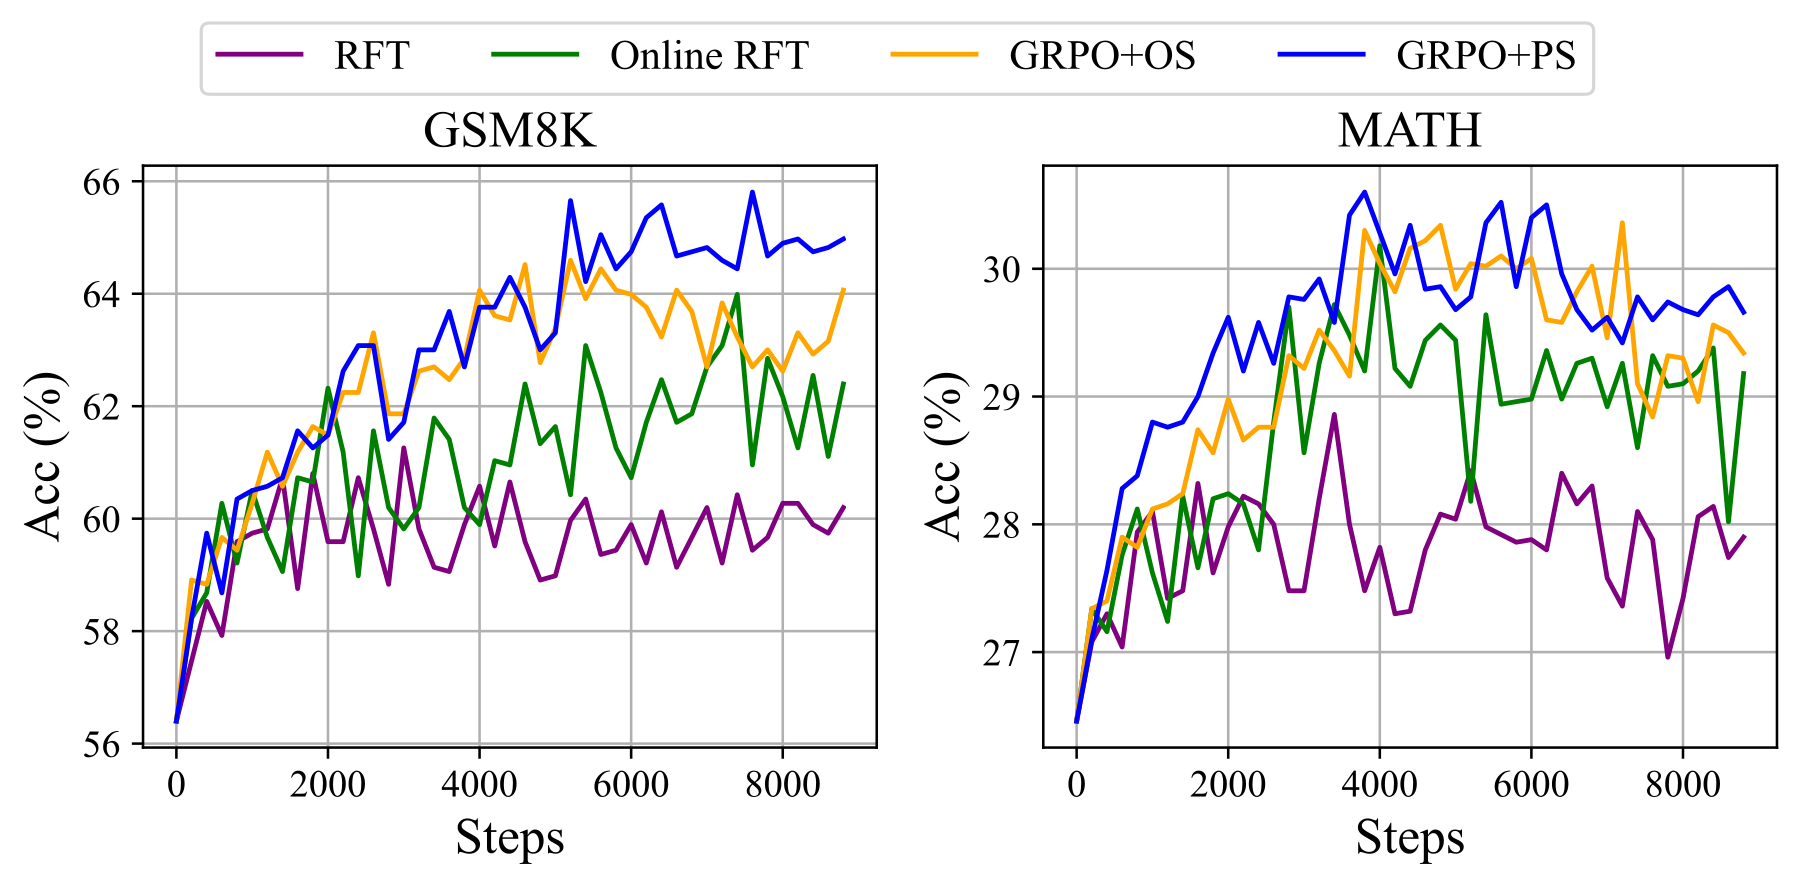
证据三:图5、图6,在线数据和细粒度反馈有帮助。 1.3B 实验中,Online RFT 后期优于固定答案库的 RFT;GRPO 又优于 Online RFT,过程监督优于结果监督。7B 迭代实验也显示收益。这支持多个机制的价值,但比较同时涉及数据来源与奖励处理,并不是仅替换一个数学符号的完全隔离实验。
证据四:图7,正确率提高未必意味着可解问题集合扩张。 在温度 0.7 的多样本比较中,RL 改善 Maj@K,却没有改善 Pass@K。作者据此推测,主要作用是提高已有正确解的生成概率。这个解释与实验一致,但有限 K、有限任务下的曲线不能证明模型绝不获得新能力。
证据五:表6、表7、表8、表9,数据结论也有反例与边界。 代码与数学混合训练对程序辅助解题有利,却可能损害无工具解题;arXiv 单独继续训练并未稳定改善所测数学基准。作者明确没有据此否定更大模型、其他任务或混合语料中 arXiv 的价值。
五、省去价值模型仍需昂贵采样与可靠奖励
它保留 PPO 风格的概率比和裁剪,重写了优势来源与 KL 放置位置。
省去 critic 能减少一部分模型驻留和更新开销,但每题采样 64 次仍昂贵,奖励模型也仍要运行。论文没有用统一端到端计时给出适用于所有配置的节省百分比。若更小的 critic 已足够,或者采样本来就是主要瓶颈,净收益会改变,这是机制推断。
奖励模型可能偏好貌似严密但错误的解答;整条奖励对早期错误的归因也粗糙。组内比较不能纠正共同错误,所有解答都获得相同错误高分时仍缺乏有用排序。作者在 §6 承认几何、定理证明和少样本利用存在弱项,部分三角形及椭圆问题失败提示数据选择可能有偏。
还要区分“RL 阶段域外”与“从未训练过”。中文数学题未参与这里的 RL,并不代表中文数学内容未进入继续预训练或 SFT。因此中文结果改善是阶段性的迁移证据。
六、沿组内比较继续研究长推理奖励训练
R1直接沿用GRPO并改用可验证结果塑造长解题行为。继续读时分别跟踪基座、奖励来源、筛选和监督整理,别把本篇数学语料阶段的收益记成强化学习单独贡献。
自测:能否解释这些判断
1. GRPO 没有 critic,为什么这篇论文仍需要奖励模型?
奖励模型负责给已完成的答案或步骤评分,critic 负责预测前缀之后的期望收益,服务于优势估计。GRPO 用同题其他答案的得分替代后者的基线,但得分本身仍由奖励模型产生。后来的可验证规则奖励实现是另一种评分选择,不能反推本篇没有奖励模型。
2. MATH 从 46.8% 到 51.7%,能否证明 GRPO 比 PPO 普遍更强?
不能。这个数值首先是相同模型 SFT 与 RL 阶段的比较;它支持该训练配方有效。要判断与 PPO 的普遍优劣,需要相同起点、采样量、奖励、调参和总成本的直接比较,并覆盖多个任务与种子。省去价值网络的结构优势也不自动等于所有墙钟预算下准确率更高。
3. Maj@K 提升而 Pass@K 不提升,为什么还可能很有用?
候选中偶尔有正确答案,并不意味着用户能得到它。把正确路径概率提高,能改善单次回答与有限预算投票,即使可覆盖的问题集合不变也具有实用价值。不过不能据此声称模型学会了所有此前不会的题;还应检查更大 K、不同题型及奖励模型未参与的独立评测。