098|DeepVerifier:让研究型 Agent 检查证据,而不是再自信一次
论文:Wan 等,Inference-Time Scaling of Verification: Self-Evolving Deep Research Agents via Test-Time Rubric-Guided Verification,2026。原文 · 正文 v2 · PDF v2 · 官方代码。
图表来源:Wan 等,2026,原文;CC BY 4.0。本篇展示做了PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。
先接住前作的问题
Self-RAG在生成中学习支持度,本篇采用平行的事后核查:对研究Agent轨迹拆分疑点,再用工具找外部证据。SWE-agent提供反馈改变行动的跨任务教学联系,不能据此宣称编辑接口的直接继承。
五个前置概念
五个前置概念:轨迹 是行动与观察的序列;评分准则 把抽象质量拆成可检查条件;元评估 评价裁判是否判断正确;假阳性 在本文指误拒正确答案;测试时扩展 通过额外推理和工具调用改变结果,而不必更新权重。
一、问题设定:第二个模型说合理时,怎样把可疑环节变成外部查证
研究Agent的状态包括任务、已访页面、工具输出和行动历史,可搜索、点击、执行代码或提交答案。主要干预发生在一轮执行之后,固定参数下核查并重试;另有小模型SFT路线,不能把每次核查说成一次RL更新。
作者从 WebAggregatorQA 收集轨迹,构建五大类、十三小类失败分类,主要涉及来源寻找、推理、任务理解、动作执行与步骤预算。表1 的语料来自 90 个任务、2997 个动作;对错误轨迹由两名研究人员标注,合并得到 555 个错误点,平均交集比例为 63.0%。
摘要使用了自动构建分类的表述,但 §3 具体过程包含人工检查、标签归并和讨论。描述方法时应以过程为准,不能写成完全无人参与。63% 的交集比例也不是 Cohen's kappa,更不是证明错误标签全部客观一致。
核心假设是:确认一个关键声明的证据,有时比重新解决整道复杂问题更容易。这种不对称并非总成立;若正确性依赖复杂综合判断,分解后的局部检查也可能漏掉全局矛盾。
二、分解失败类型并推导纠错收益与误报代价
三个模块
第一步生成带步骤编号的摘要,保留访问了什么来源、获得什么信息。它是降低上下文负担的措施,但摘要也可能遗漏决定性信息,因而不能把摘要当原始证据本身。
第二步依据失败分类,识别行为与潜在错误的对应关系,再形成少量具体问题,例如某个来源是否真的支持某个数值,某篇论文是否确实早于另一篇。论文成本讨论将核查问题限制在不超过三个。
第三步由具有搜索、截图和代码工具的验证 Agent 回答这些问题。裁判结合轨迹摘要、疑点、问题与新证据,给出 1—4 分以及反馈。评分不超过 2 继续修正,达到 3 或 4 则停止。因此系统的“接受”包含大体正确,而非只接受完全正确;这是评估和部署都应看清的阈值选择。
框架改变的是信息流与计算分配,没有提出主循环的新梯度损失。小模型路线从 400 条基础执行轨迹再生成验证轨迹,保留正确接受与正确拒绝的案例,整理成 4646 个训练对,与 CK-Pro 数据混合做 SFT。这些是步骤级训练对,不是 4646 道完全不同的研究任务。
为什么要同时测 precision 和 recall
论文把“拒绝错误答案”定义为正类。令 TP 为正确拒错,FP 为误拒正确答案,FN 为放过错误答案,则:
高 precision 表示被指控错误的答案大多确实错误;高 recall 表示错误不容易漏掉。一个从不轻易质疑的裁判可以 precision 很高,却漏掉大量问题。反过来,频繁要求重写可能增加正确答案被改坏的机会。
为理解迭代,构造一个教学关系:若当前正确率为 ,错转对概率为 ,对转错概率为 ,则下一轮 。这不是论文训练公式,而是说明净收益取决于两个方向;当可修错误逐渐耗尽时,持续误报可能使收益转负。
从“发现错误”走到“修好答案”,还隔着执行者
把当前答案正确率记为 ;对错误答案,验证器拒绝的概率为 ,被拒绝后成功修正的条件概率为 。对正确答案,误拒概率为 ,误拒后被改坏的条件概率为 。若被接受的答案保持不变,一轮后的正确率是
对应拒错召回率,但 取决于执行者能否理解和使用反馈; 是正确答案上的误报率,不是 。精确率的分母是所有被拒答案,两者不能交换。该式不需要把拒绝与修订成功假定独立,因为 已定义成条件概率。
原创教学例。 100道题已有80道正确、20道错误。取 ,预期修好 道,同时改坏 道,净增4道。相同机制在95道已正确时,预期修好2道、改坏4.75道,净收益反而为负。分数是期望计数,单次实验仍只会出现整数个任务。
在这个固定参数教学模型中,净收益为正需 。真实任务里剩余错误会变难、 随轮次变化,不能把8/9当作论文的停止阈值。表5错转对与对转错的双向统计,比单独报告裁判F1更接近这一系统问题;选择最佳轮数仍须用开发数据,不能看完测试曲线才决定何时停。
反馈要区分被反驳与尚未证实
若核查只发现原链接日期是页面更新日期,它反驳的是“用该日期证明发表时间”的依据,不必然证明原年份本身错误。反馈应要求补正式发表记录,而不是直接编一个新年份让执行者替换。这样把证据缺失与反证分开,才能降低正确答案因过度反馈被改坏的风险。
三、执行独立核查后返回可操作反馈再修订
自构例子。 Agent 说某位研究者最早论文发表于 2012 年。好的核查不应直接再搜索一次“最早论文”,而是检查作者身份是否同名、是否存在 2011 年正式记录、页面日期是发表还是更新。若新证据只否定一个来源,却没有找到更早论文,反馈应是结论未证实,不能捏造替代年份。
输入:研究问题 q、初始 Agent 答案 a、轨迹 τ、最大反馈轮数 K
重复至 K 轮:
    summary ← 按步骤整理 τ 中的来源与事实
    risks ← 根据失败分类定位关键疑点
    checks ← 把疑点改写为至多三个外部可验证问题
    evidence ← 调用工具逐项回答 checks
    score, feedback ← 裁判结合 summary 与 evidence 评分
    若 score ≥ 3:返回 a 与核查记录
    否则依据 feedback 重试任务,得到新 a 与 τ
达到轮数上限:返回当前结果并保留未解决疑点
测试期间:所有语言模型权重保持不变
四、同时读取裁判F1、错转对与对转错
裁判能拒错只是第一步,表5双向转移才连接最终正确率;最高测试轮数不能事后充当可部署停止规则。
| 项目 | 设置与证据边界 |
|---|---|
| 分类来源 | WebAggregatorQA 90 个任务;两人标注错误点,不与 GAIA 主评估混为同一语料 |
| 执行框架 | CK-Pro,多模块 Agent,主要骨干 Claude-3.7-Sonnet;另检查 GPT-4.1 与 Qwen3-8B 系列 |
| 验证对照 | 去掉外部核查的分解式 LLM 裁判;去掉分解的直接 Agent 裁判 |
| 推理扩展 | 最多十轮反馈,验证器接受后停止;记录不同轮数成绩 |
| 数据集 | GAIA-Web、完整 GAIA,另有 XBench-DeepSearch 与 BrowseComp |
| 小模型训练 | DeepVerifier-4K 与 CK-Pro 训练集混合;不是仅 4646 条数据从零获得工具能力 |
| 参数缺项 | §6 在介绍训练参数后没有列出具体数值,PDF 文本也未提供可确认的学习率、轮数和完整训练预算 |
| 费用 | 提供核查问题数和早停机制的定性讨论;未给充分的美元、墙钟、总 token 对照证明最优成本比 |
| 统计 | 主表未给独立重复执行的置信区间;实时网页、工具故障和 API 变化也影响复现 |
外部核查对照需要更多工具调用,因此实验验证的是完整核查机制的收益。若要证明相同预算下优于多次重跑或 Best-of-N,还需要明确配平工具、输入输出 token 和等待时间。
证据 1:表2,裁判本身。 DeepVerifier 的拒错 precision/recall 为 75.00/71.43,F1 为 73.17。去掉验证为 100.00/14.29、F1 25.00;去掉分解为 86.96/47.62、F1 61.54。这说明外部核查与问题分解帮助发现更隐蔽错误,同时也牺牲了一些拒错精确率。
摘要中的 F1 提升 12%—48% 应谨慎解释:表中直接差值为 11.63 与 48.17 个百分点。若计算相对增长,应分别除以 61.54 和 25.00,不能把这两种口径混写。
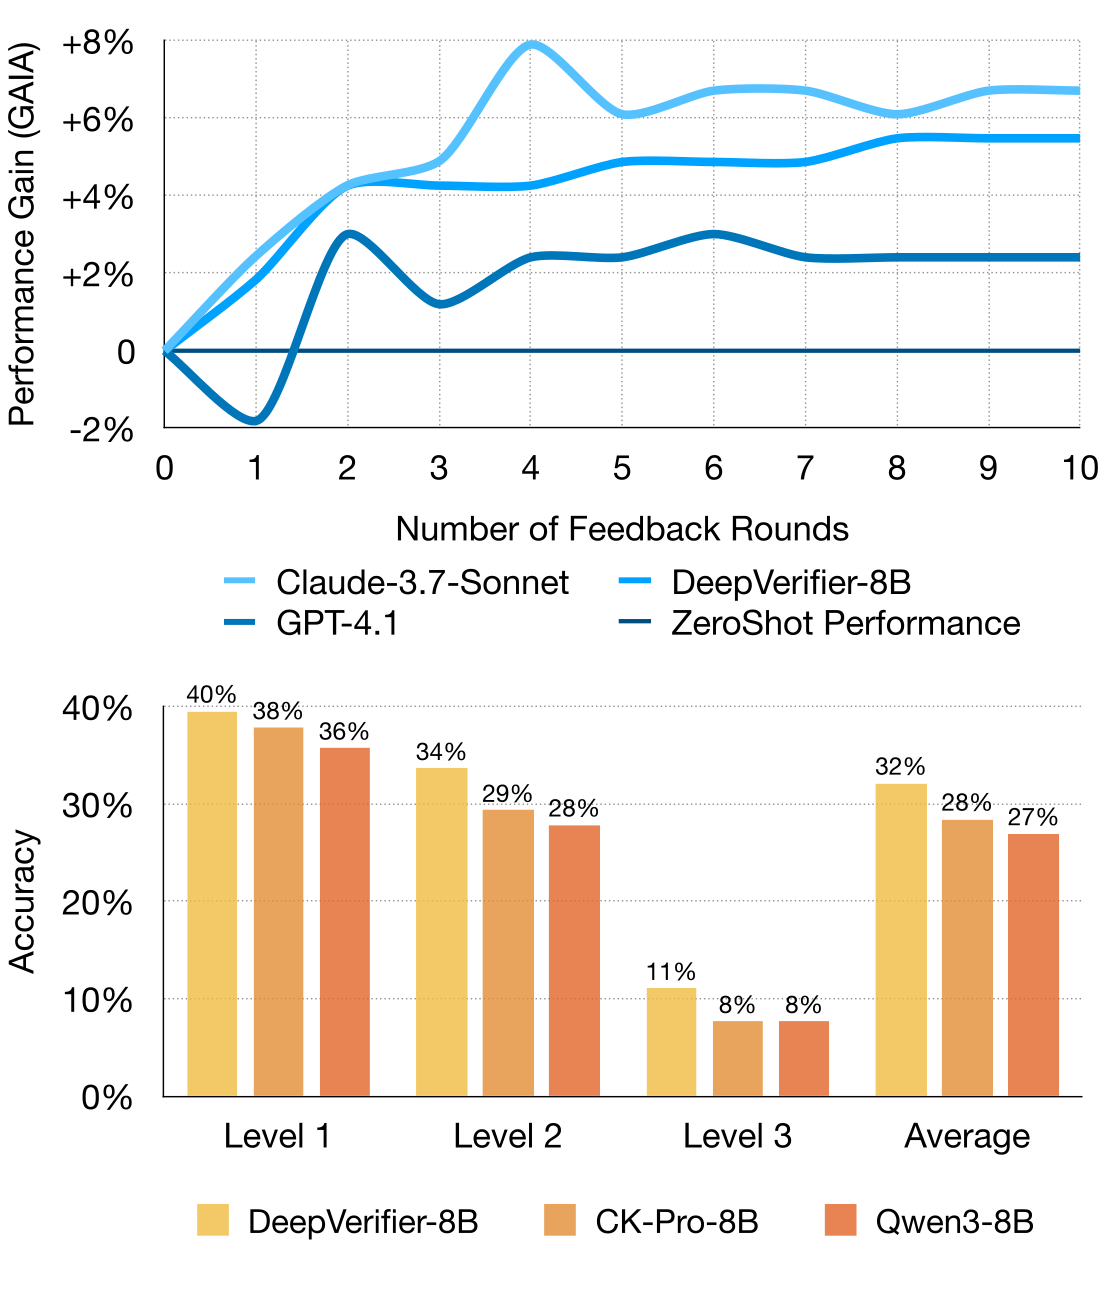
证据 2:表3,GAIA 的轮数曲线。 Claude-3.7 在 Web 子集从 51.11 到四轮的 63.33,十轮为 62.22;完整集从 52.22 到四轮 60.12,十轮 58.93。应保留原表的百分比口径,不反推出未报告的整数计数。最佳与最终不同,直接反对“轮数越多必定越好”。
证据 3:表4,跨任务。 DeepSearch 从 41.0 到最佳 47.0,十轮结束为 44.0;BrowseComp 从 5.0 到最佳 10.0,最终 9.0。这是不同任务也存在收益的证据,不能将最高点当作无需开发集就可选出的固定部署策略。
证据 4:表5,错误转移。 第一轮错转对比例为 18.99%,对转错为 12.79%;后期纠错收益明显衰减,而个别轮次仍有回退。两个比率的条件人群不同,不能简单相减就当总正确率净增加 6.20 个百分点。
证据 5:§7.3 与图1,小模型适配。 DeepVerifier-8B 反思后完整 GAIA 约 32.2%,比自身无反思提高约 5.5 点;仅 CK-Pro 训练的模型改善约 2.6 点。它支持专门反馈数据有用,但混合训练、骨干能力与执行链共同影响结果,不能仅凭最终分数分离所有原因。 上面板是165道GAIA开发题的验证轮数曲线,下面板比较十轮后的模型;选择最佳停止轮数和报告独立测试成绩属于不同评价步骤。
五、共有偏差与轮次选择会限制越查越好
论文把“请检查一下”具体化为失败分类、证据问题和修改反馈,这比单纯增加自我评价文字更容易审计。价值在于核查行为,不在于用了多少次“反思”这个词。
作者承认弱模型难以准确遵守准则,工具能力不足时反馈会变差,迭代也增加延迟。近期报告还存在需要保留的文档边界:摘要对分类自动化的描述与 §3 人工流程不同,训练超参数没有完整列出,成本优势主要是结构性解释。
本文的分析是:验证器与执行者即使用不同提示,也可能共享同类知识偏差。真正降低共同错误需要原始来源、可执行检查及独立证据,而不是仅把同一个结论换种措辞说两遍。失败分类也应根据新任务更新,不能假设五类十三项穷尽所有错误。
六、用完整预算和因果停止协议检验核查系统
推理评估协议将核查放回完整系统:额外调用、因果停止、修订选择与最终正确率都需记录。裁判F1只说明某一环节,不能单独决定应当检查几轮。
七、自测与答案
1. 没有额外训练的自我改进,改的是什么?
答:改的是当前任务的上下文、证据和后续行动。模型参数不变,更多核查改变了可用信息;另行训练 DeepVerifier-8B 属于独立的 SFT 路线,不能混成一次测试中的权重自我进化。
2. 拒错 precision 为 100%,为什么仍可能是很差的验证器?
答:它可能只拒绝极少数明显错误,放过绝大多数隐蔽错误。论文去掉验证模块后 recall 只有 14.29%,说明判断保守不能代替有效覆盖。
3. 为什么不应总是运行到十轮?
答:后期剩余错误更难修,而误报仍可能触发错误重写,净收益会下降。应在开发集上选择停止或回退规则,并记录实际费用;不能看完测试曲线后用最佳轮次冒充预先固定的决策。