第 32 天|IMPALA:采样与学习分离后,用V-trace处理策略滞后
原论文与版本:IMPALA: Scalable Distributed Deep-RL with Importance Weighted Actor-Learner Architectures,2018。原论文。
先接住前作的问题
A3C的worker既采样又送梯度,已经有参数滞后。IMPALA进一步分开Actor与Learner以提高吞吐,也让收到的动作更可能来自旧策略。
五个前置概念
- 策略滞后:数据来自较旧行为策略。
- Actor–Learner:环境采样和梯度训练的分工。
- V-trace:截断重要性校正的多步价值目标。
- 重要性比:目标与行为概率的比例。
- 吞吐:单位真实时间处理的样本量。
一、问题设定:采样与学习分开以后,旧轨迹怎样评价新策略
Learner看到一条轨迹时,当前策略可能已不再按当时概率选择那些动作。若仍把它当成on-policy数据,多步目标的解释就错了。重要性比值可以校正差异,但长链乘积又会放大方差,因此要分别决定当前残差和后续传播怎样截断。
| 要素 | 本文设定 |
|---|---|
| 研究场景 | 分布式Actor–Learner、off-policy校正的Actor–Critic |
| 状态/观测 | 各Actor环境观测 |
| 动作 | 行为策略μ采样动作 |
| 奖励或学习信号 | 环境奖励 |
| 终止/边界 | unroll边界bootstrap,真终止清零 |
二、分开残差权重与多步传播权重
提高吞吐的一步是让Actor只负责采轨迹,Learner批量训练。但Actor发来的动作来自旧行为策略μ,Learner当前策略π已改变,因此轨迹不再严格on-policy。V-trace在每条转移里保存行为概率,用π/μ校正,而不是把滞后当成可以忽略的系统细节。
两个截断系数承担不同工作:ρ乘当前TD残差,决定正在评价哪个有效策略;c出现在多步乘积中,控制远处残差传播和方差。在表格分析下,有限ρ上限对应归一化的 策略,c上限不改变这个固定点,却影响收敛及噪声。
当μ=π且截断不生效,残差望远镜相消,回到n步on-policy目标。Actor的优势使用下一时刻V-trace值构造回报,不能随意把v_s当成Q(s,a)。大吞吐仍可能增加滞后,吞吐峰值不是学习质量的唯一目标。
将有限V-trace和式变成反向递推
,。截断不是免费修正,理论固定点需按论文解释。
有限轨迹怎样计算这条和式:这里求和实际只到当前 unroll 的末步 ,并非要求无限未来;首项的空乘积为1。原式把起点时间也记作 ,为免与状态混淆,可把状态写成 。令 ,从尾部 反推 ,就得到同一有限和,真终止后的价值取零。若所有比值为1,中间估值正负相消,只剩实际 n 步奖励与末端自举;这解释了它为何接回普通多步目标。见原文§4.1式1—2与Remark 1。
残差权重出现的位置决定其职责
起点残差前的空乘积为1,因此第一个误差直接受ρ控制;越往后的残差才累积更多c。把ρ也沿整条链相乘,会改变原式的校正与方差结构,不是记号替换。
算出截到1之后实际评价的策略
以下是可手算的教学构造,不是论文实验。
某状态μ=(0.8,0.2),π=(0.2,0.8),ρ上限1。有效未归一化概率为min(μ,π)=(0.2,0.2),归一化后为(0.5,0.5),并不是目标π。
因此说“比值截到1仍精确评价新策略”不成立。若取消ρ截断,理论目标回到π,但第二动作比值4会增大方差。c的截断则主要避免这类比值沿长链相乘。
三、存下行为概率并从unroll尾部递推
Actor:同步策略→执行unroll→发送状态动作奖励与logμ
Learner接收批轨迹:
  计算当前logπ与V
  ratio←exp(logπ-logμ)
  ρ←min(ρbar,ratio);c←min(cbar,ratio)
  反向递推V-trace目标v
  用v回归V
  Actor用ρ*(r+γ*v_next-V)构造优势更新
  将新参数供Actor获取
输出:可扩展的共享策略
实现要点:截断引入特定偏差,系统吞吐不等于环境样本效率。
四、把吞吐、策略滞后与任务表现分别检验
| 实验要素 | 原文设定与证据范围 |
|---|---|
| 环境与任务 | DMLab-30、Atari及吞吐任务 |
| 数据来源与规模 | 多Actor持续生成轨迹 |
| 对比基线 | A2C等系统与不同校正 |
| 训练预算与资源 | 表1比较特定任务吞吐;硬件数影响结果 |
| 指标及其含义 | 每秒帧数、任务分数、多任务表现 |
| 随机性与不确定性 | 全部种子/区间本文未核实 |
| 实际验证的假设 | 解耦后吞吐收益能否在策略滞后下保留 |
实验解读(本文分析):论文把架构吞吐、策略滞后校正和单/多任务结果分别测试;固定点推导明确依赖表格表示、访问和步长条件。不能将框架每秒处理更多帧,直接解读为每帧更有效;也不能拿V-trace算子的收敛证明覆盖异步深网训练全部细节。
不要用每秒帧数替代每帧学习质量
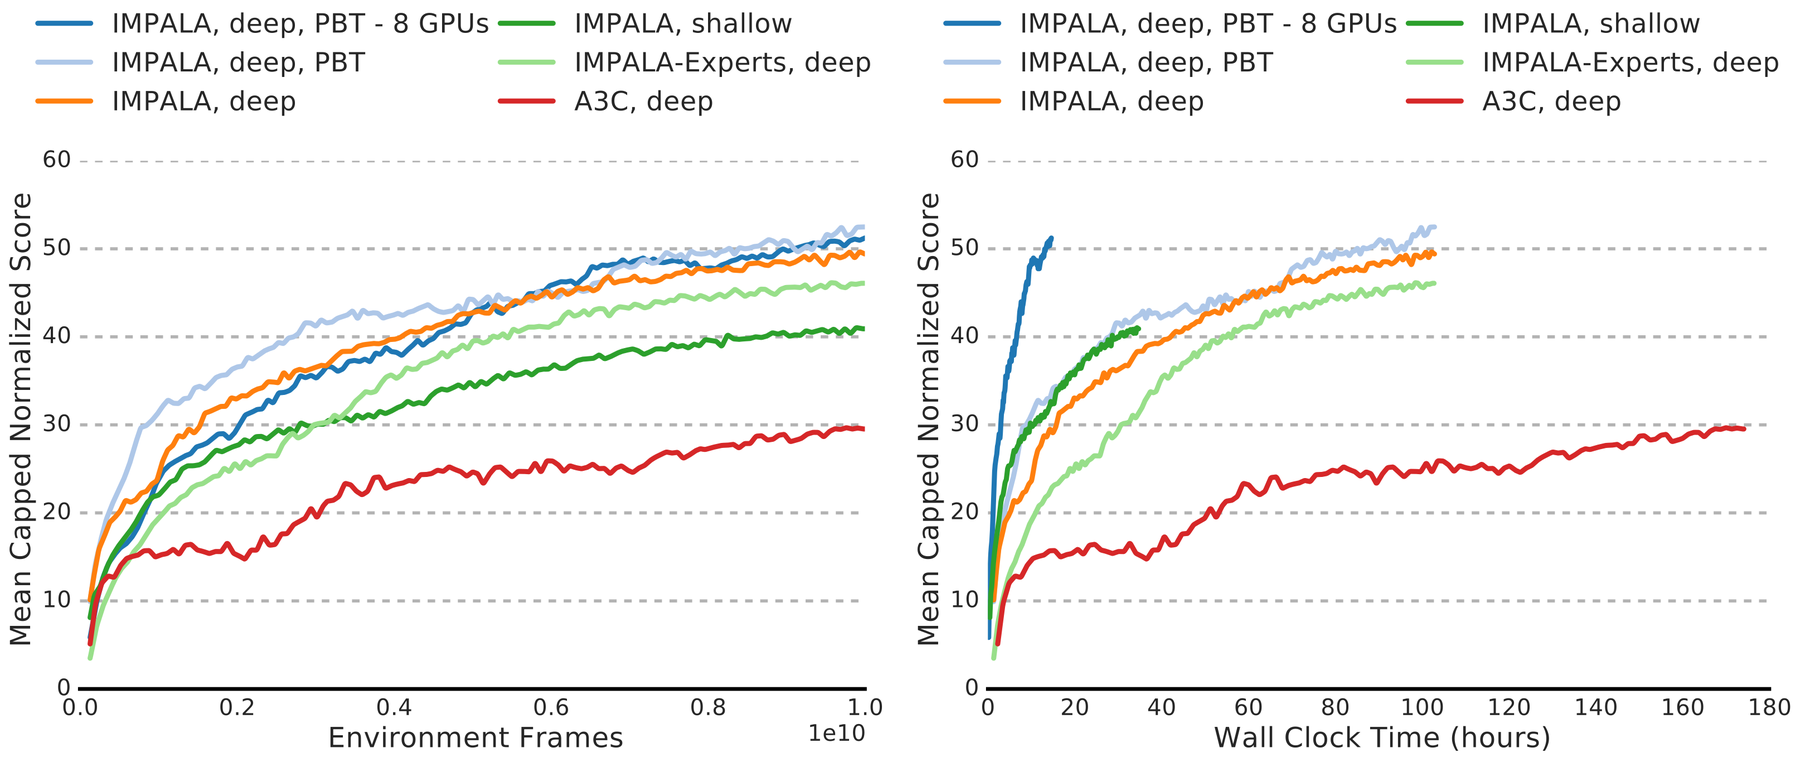
左图按环境帧比较数据效率,右图按小时比较墙钟效率,两个横轴不能混成同一种加速。曲线选择每组超参数搜索或PBT种群中的最佳agent;左图帧数只算一个agent,若计算24个候选的总搜索成本还要乘以种群规模。
两图共用的纵轴是DMLab-30“封顶后的人类归一化分数均值”:先按各任务随机/人类参照归一化,再把每项的上限设为100%,最后平均。因此某项超人类高分不能无限补偿别的任务失败;曲线也不是“答对任务的百分比”。深蓝八GPU曲线在右图较早到达相近高度,主要说明墙钟收益,左图仍须另看相同帧数的学习效果。口径见§5.3.1及附录B。
图1把actor队列和learner解耦,图2的时间线说明慢环境为何让同步批处理等待;这是吞吐机制,而非回报保证。表1只在两项具体任务和硬件上比较吞吐。V-trace附录定理区分ρ决定的目标固定点与c控制的迹传播,截断校正不能概括为完全无偏。DMLab/Atari结果还需检查逐任务变化,平均多任务提升不排除负迁移。 查看原文。
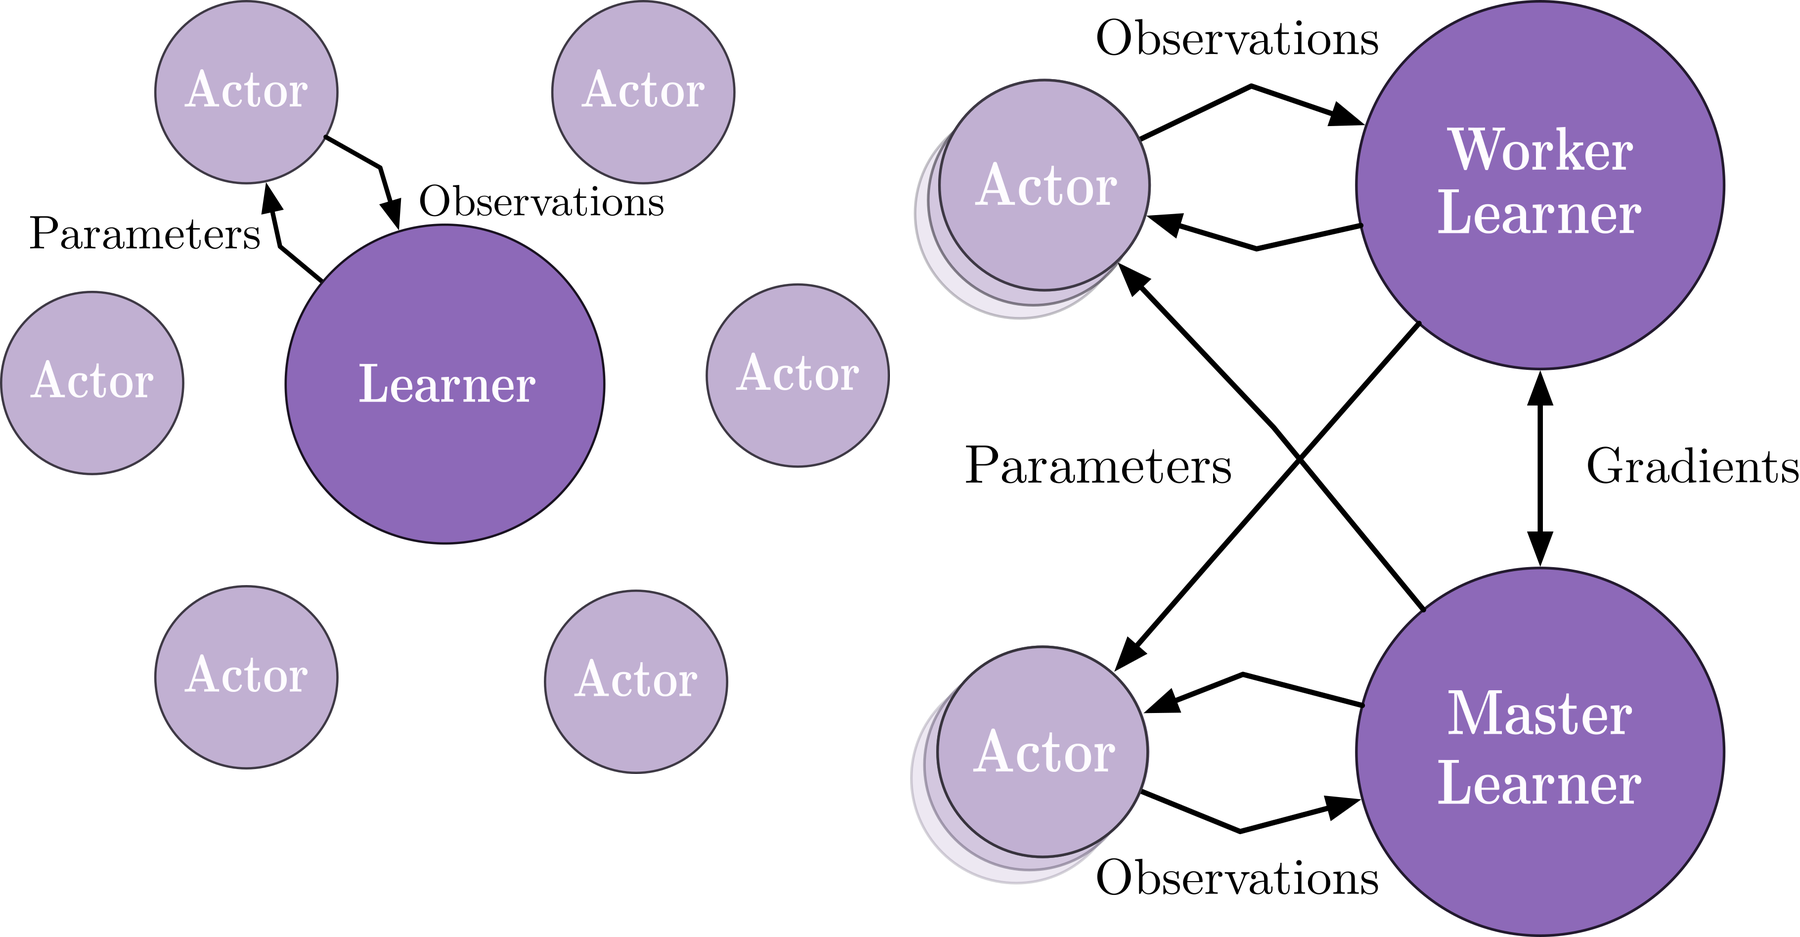
读图提示:左侧为单learner,右侧为多个同步learner。沿参数和观测箭头读actor与learner的数据交换;解耦结构本身没有保证回报提高。
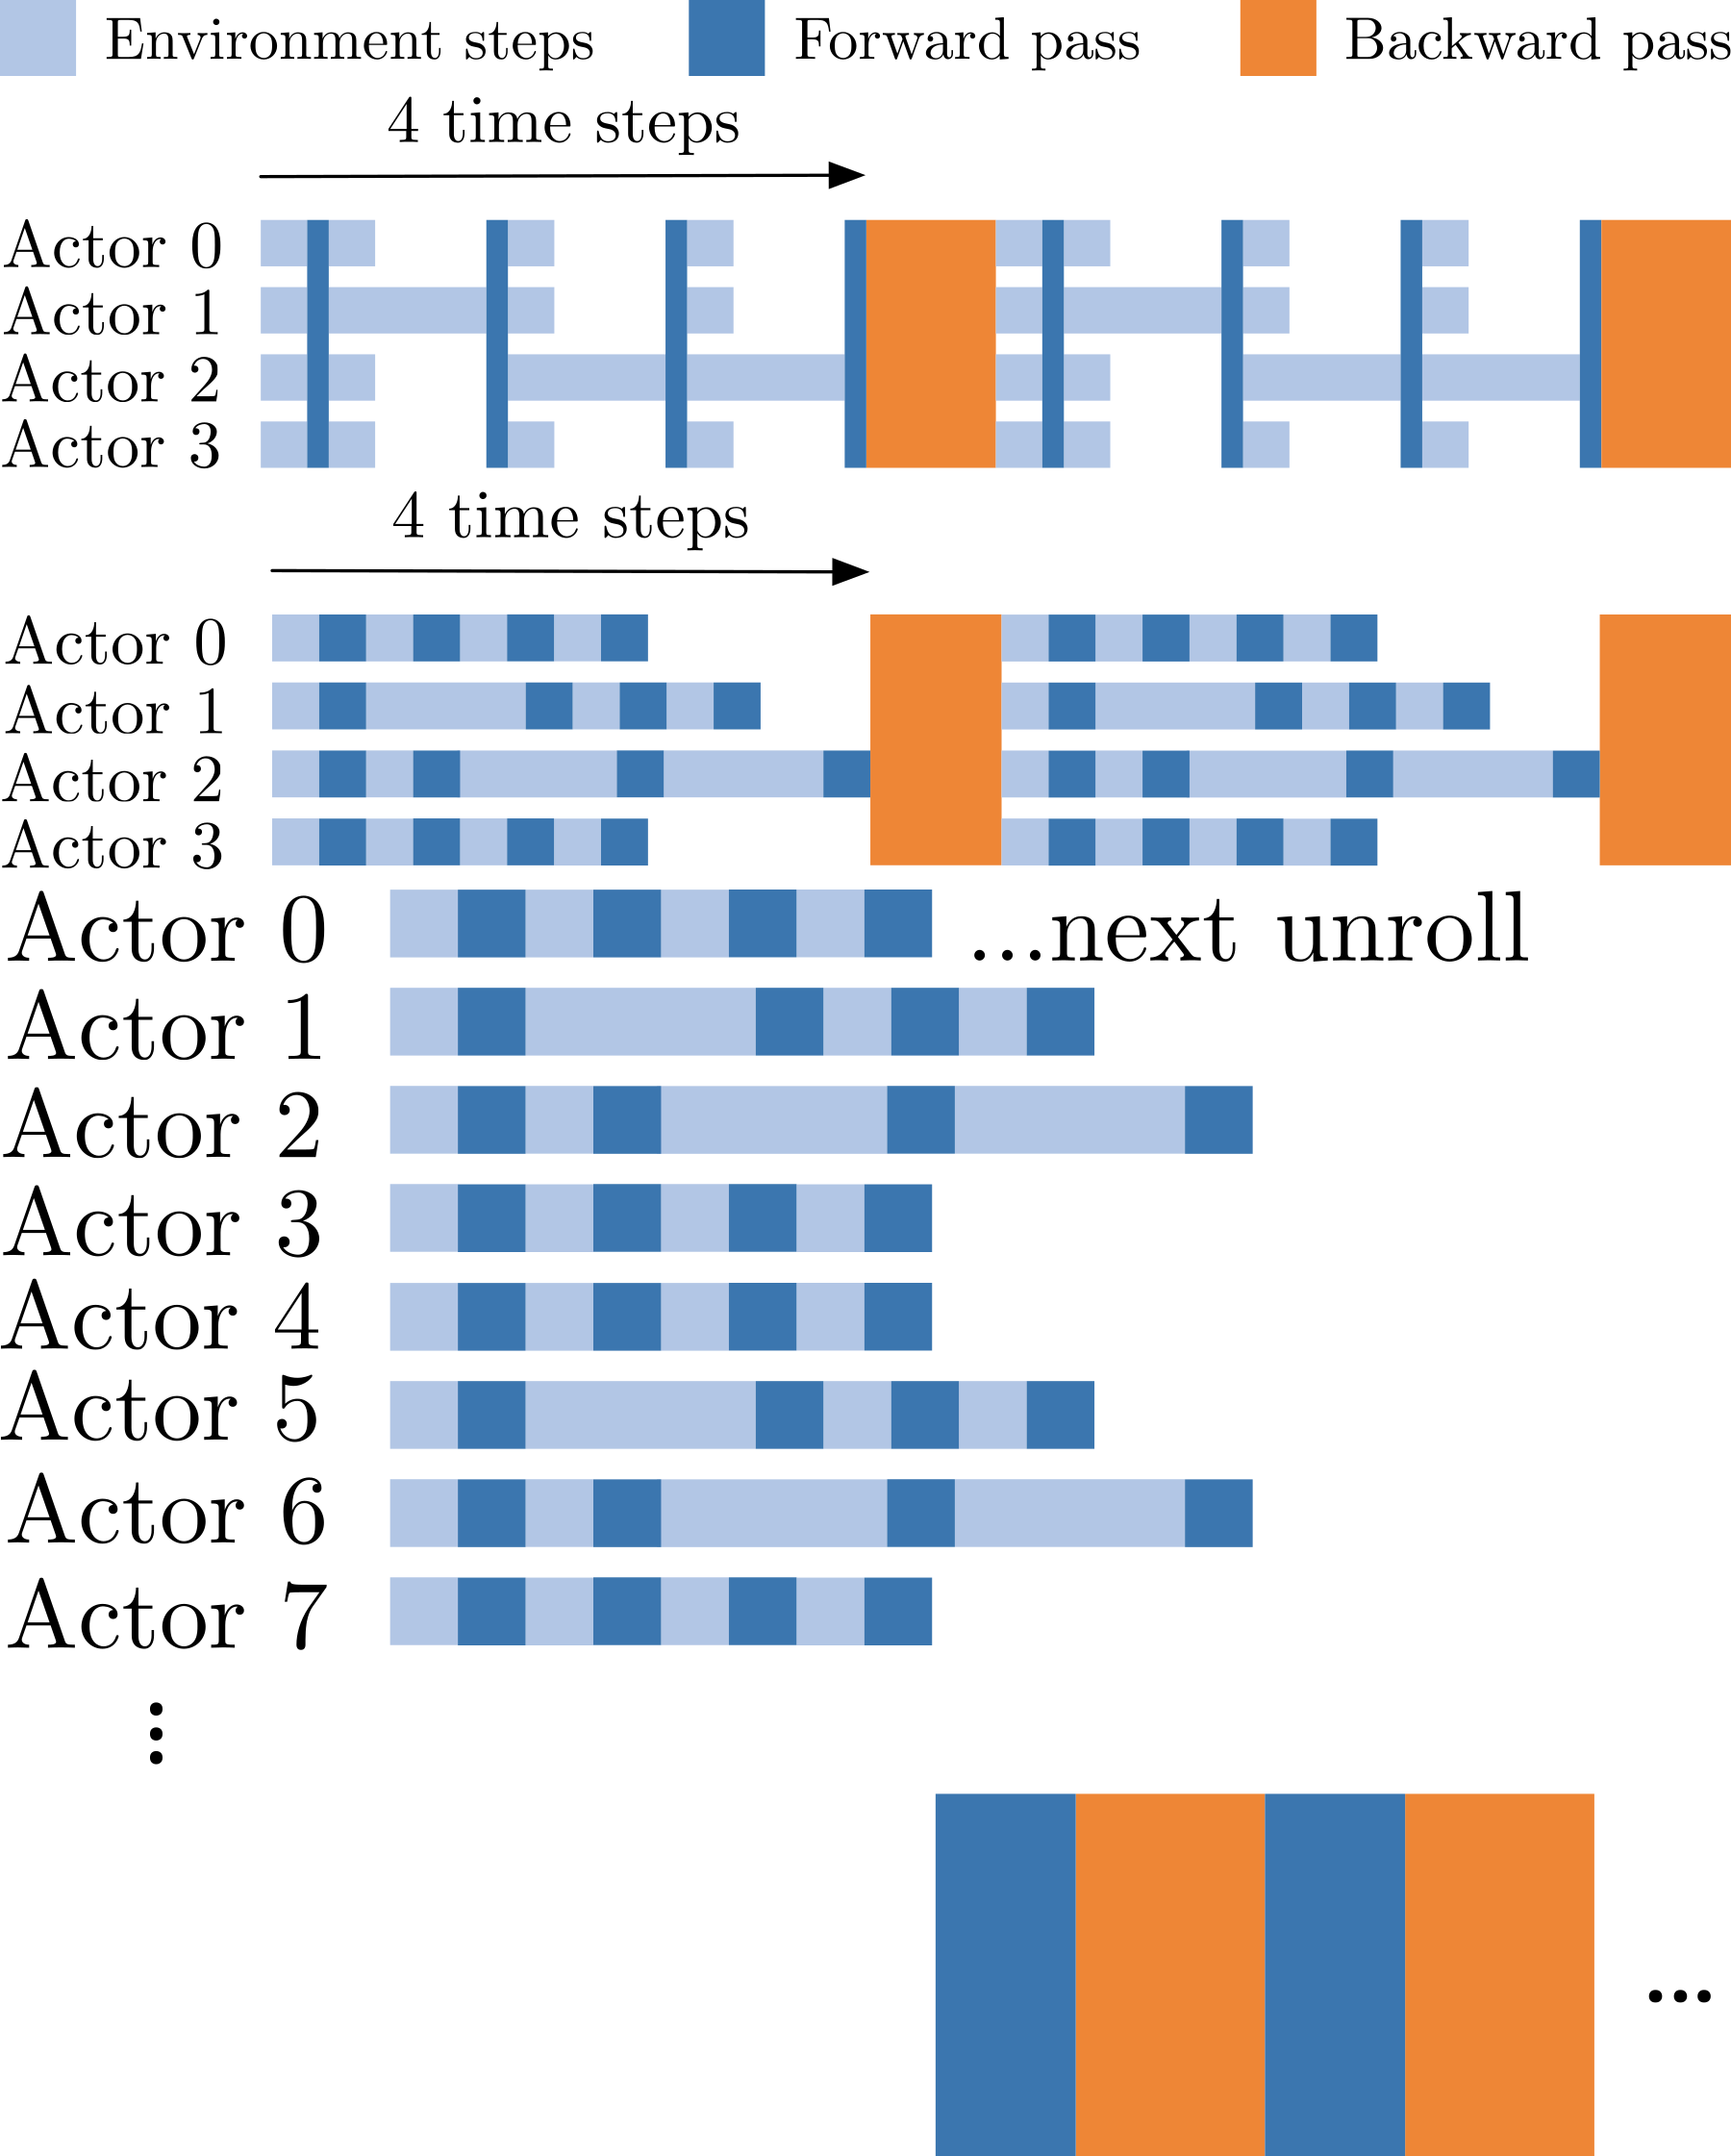
读图提示:自上而下为(a)逐步同步A2C、(b)整段同步A2C、(c)IMPALA;最上方保留环境步、前向和反向计算图例。空白等待体现吞吐损失,不是训练质量。
五、截断固定点不一定就是当前目标策略
队列太长会使行为策略μ远离当前π,截断后的有效学习信号随之减弱。表格固定点条件不覆盖整个异步深网系统;需同时画return-vs-frame与return-vs-time,才能区分DMLab、Atari等结果中的样本效率与吞吐收益。
继续追问:比值上限、覆盖与系统延迟
1. 队列长度如何影响有效样本质量?
队列越长,轨迹生成时的行为策略与 learner 当前策略通常差得越远,重要性比率更极端,截断比例上升,有效校正信息下降。吞吐提升可能被策略滞后抵消。应记录样本年龄、行为/目标 KL、比率分布与有效样本量代理,再调节队列上限、参数同步频率和 actor 数量,而不能仅以每秒帧数选择配置。
2. ρ与c两个截断各自改变什么?
截断单步校正的 TD 项,有限上限一般改变所评价的固定点策略; 控制多步迹的传播与方差,在论文的相应条件下不改变由 决定的固定点,却影响收敛速度。两者常数取值可以相同,数学角色仍不同。还需满足行为策略支持覆盖;称 V-trace 为校正机制不意味着任意截断都是原策略的无偏估计。
3. 多任务共享提高均值时是否存在负迁移?
可能。总体均值提高允许部分任务下降,且共享模型会让高频或梯度大的任务主导表示。应报告逐任务与低分位变化、任务采样比例以及与同预算独立模型的对照,区分正迁移、负迁移与单纯增加数据。分数归一化和任务权重改变也会改变均值,不能只凭汇总曲线断言所有任务获益。
六、对照两种加权残差的不同用途
系统来源回看:A3C。从异步提交梯度到提交轨迹,通信与计算分工改变了策略滞后的处理方式。
教学对照:GAE。两者都累积TD残差,但GAE调节优势跨度,V-trace的概率比针对离策略数据;不能把两个权重互换。
原论文与图表入口。§4 V-trace式3、附录A Theorem 1与Remark 3;架构说明。
自测两题
第一题考查核心机制,第二题考查边界与辨析。建议先自行作答,再对照参考答案。以下数值小例子均为教学构造。
问题 1:为什么采样和学习分离后需要 V-trace?
参考答案:采样器可能使用较旧策略,而学习器参数已更新。直接按当前策略数据处理会产生分布偏差。V-trace 利用当前与行为策略的动作概率比,并结合多步自举,对这种策略滞后进行修正。
问题 2:为什么不直接使用完整的重要性权重?
参考答案:长轨迹概率比可能极大,造成高方差和不稳定。截断权重能控制波动,但修正不再完全,某些截断设置还会改变评价的固定点。它是在可扩展性、方差和偏差之间取舍。