039|CONDENSATION:暂时保留错误答案,反而能避免彻底跟丢
论文:Michael Isard、Andrew Blake,CONDENSATION—Conditional Density Propagation for Visual Tracking,1998,International Journal of Computer Vision 29(1):5–28。作者出版页 · 期刊原文。1996 年已有相关会议版本,这里精读扩展的 1998 年期刊文。
先接住前作的问题
Bootstrap Filter可以表示多峰分布,本篇把它与轮廓似然、学习动态模型组合。与Lucas–Kanade对照时,应问多假设何时值得成本,再去MCL看同一表示如何迁移到定位。
五个前置概念
五个前置概念是:贝叶斯后验结合历史与新证据;马尔可夫转移描述状态变化;粒子表示用有限样本近似分布;重采样将计算集中到高权重假设;多峰分布允许几种互相分离的解释同时存在。
一、问题设定:视觉杂波中的多个轮廓解释怎样保留到下一帧
一个人从屏幕前跳过,屏幕边缘恰好像头部轮廓。当前图像最像目标的位置可能是屏幕,但下一帧屏幕不会按人的运动继续移动。如果跟踪器立即抛弃其他解释,它可能再也回不到人身上。
问题定义:状态不是每个像素,而是低维轮廓参数
作者跟踪参数化曲线,例如头部、手和树叶边界。状态 描述形状与运动,观测 来自当前图像边缘。曲线可由 B 样条表达,但若直接自由移动所有控制点,维度过高且不稳定,因此实际限制在仿射空间或学习的形状子空间。
机器人可以用这种结果跟踪操作对象、观察人或给视觉伺服提供目标状态。不过这篇论文实验主要验证图像跟踪,并未闭环控制一个抓取机器人。不要把像素轮廓成功等同于三维抓取位姿准确。
标准 Kalman 滤波以均值和协方差表示一个高斯状态分布。在线性高斯条件下这很充分;但两个彼此分开的目标位置不能用一个高斯峰精确表达。即使增大协方差,均值也可能落在两人之间的空白处。
论文的讨论针对这种单峰表示限制,不应理解为所有带 Kalman 名字的多模型或数据关联方法都不可能处理多假设。CONDENSATION 与本系列 bootstrap particle filter 共享贝叶斯采样思想,贡献在于与视觉轮廓、杂波观测和学习运动模型的结合,而不是首次发明整个粒子滤波家族。
二、将样本预测与轮廓似然结合,维护多峰分布
方法:预测分布乘上当前图像证据
记 为截至当前的观测历史。贝叶斯滤波先预测
再更新
转移概率 表示运动规律及其随机扰动;似然 表示给定某条轮廓时看到当前图像的相容程度。它不是“状态概率”本身,必须与历史预测相乘才能得到后验。
难点是这个积分和更新后的多峰密度通常不能解析求解。采样表示以 近似后验。这里每个样本是一条可能的轮廓状态,不是图像中的一个像素点。
这对应论文“选择、预测、测量”的核心循环。祖先按上一帧权重选择后,预测分布已隐含在新样本位置中,因此这个形式的新权重可直接由当前观测似然给出。如果改用别的提议分布,则需相应的重要性权重修正,不能照搬这一简式。
观测模型:为什么没看到边缘也不能直接判死刑
背景杂波也会产生边缘,真实目标还可能暂时漏检。论文 §6.1 的一维模型同时考虑目标测量、杂波和漏检,给似然保留背景底值。否则一次遮挡就会把真实目标假设的概率压到零,后续再好的证据也难以救回来。
在二维曲线中,计算集中在稀疏法向线上,而不是扫描所有像素。沿这些线寻找候选边缘,并以截断的距离惩罚近似观测相容性。其教学形式可写为
其中 是第 条候选曲线在第 条法线上的边缘偏差, 为截断尺度, 与观测方差和采样设置有关。它表达“近边缘更可信,但一次远离边缘不应无限惩罚”,并不声称所有法线观测在真实图像中完全独立。
原文 p.15 式 (15)–(16) 还明确把随状态变化的归一化因子近似看作变化缓慢,并指出这种假设仍有待确认。这个细节说明系统使用的是可计算的观测近似,不能把权重都称作已完全校准的真实概率。
连续两帧怎样让一个弱假设翻身
教学双假设:左轮廓和右轮廓当前权重为0.8、0.2。下一帧若似然分别为0.1、0.9,未归一化权重成为0.08、0.18,归一化后约0.308、0.692。上一帧只保留最大值的方法已经丢掉右侧;概率传播却允许新证据翻转结论。
但有限采样仍会杀死小模式。十次独立有放回抽样全部漏掉权重0.2模式的概率是 。一旦它消失,若动力学传播也到不了那里,后续似然再强都救不回来。保留多个假设是表示能力,真正保留多久还取决于粒子数与动力学扩散。
Bootstrap Filter提供直接的采样贝叶斯祖先;Lucas–Kanade是局部单解跟踪的平行参照。原作者摘要明确使用学习的动态模型:论文中的敏捷目标追踪效果,应连同模型训练运动的覆盖范围阅读,不能理解为完全无先验的视频分割或任意目标检测。
优化了什么:估计质量与计算量的交换
数学任务是近似条件状态分布,不是最大化一个机器人长期回报。机制改动是从单一均值协方差换成可分裂、合并的样本群,结合时序运动先验与当前轮廓证据。实验改进主要表现为杂波下连续跟踪、短暂误导后的恢复,以及可承担的处理速度。
粒子多有助于覆盖多个模式,却不自动修复错误模型。若运动先验始终把样本送到错误区域,或者真实目标附近没有任何样本,似然再尖锐也无法凭空生成正确假设。观测越精确、峰越窄,从预测分布抽样时可能越难命中,这也是论文结论讨论重要性采样的动机。
轮廓似然只有在正确候选尚有样本支持时才能重新提高它的权重。下面把多峰传播写成流程,再用舞者恢复图检查粒子成本与错误峰存活。
三、运行动态模型与重采样,用错误峰恢复作检查
输入:上一帧粒子及权重,运动模型,当前图像
构建上一帧权重的累计分布
for i = 1 ... N:
    按权重抽取一个祖先粒子
    用运动模型的确定部分推进该祖先
    加入过程噪声,形成候选状态 xi
    将 xi 变成候选曲线
    沿曲线法向寻找图像边缘
    根据观测模型计算候选权重 wi
归一化权重
保留整组粒子用于下一帧
按任务需要输出均值、可信区域或多个模式
教学例子和前置概念
自构例子,未运行。 两个位置分别获得 0.6 与 0.4 的后验权重。下一帧观测在两处的似然为 0.1 与 0.9,则未归一化新权重是 0.06 与 0.36,第二个位置归一化后占约 85.7%。如果上一帧强行只保留 0.6 那一峰,就失去了利用下一帧反转判断的机会。有限粒子重采样也可能碰巧丢失 0.4 的峰,所以“能够表达”不等于“必然保留”。
四、读舞者与多人图,连同粒子数和速度比较
视频中的训练运动、测试场景和粒子数共同限定结论;多峰状态支持多假设,不能据此补出持续多目标身份管理。
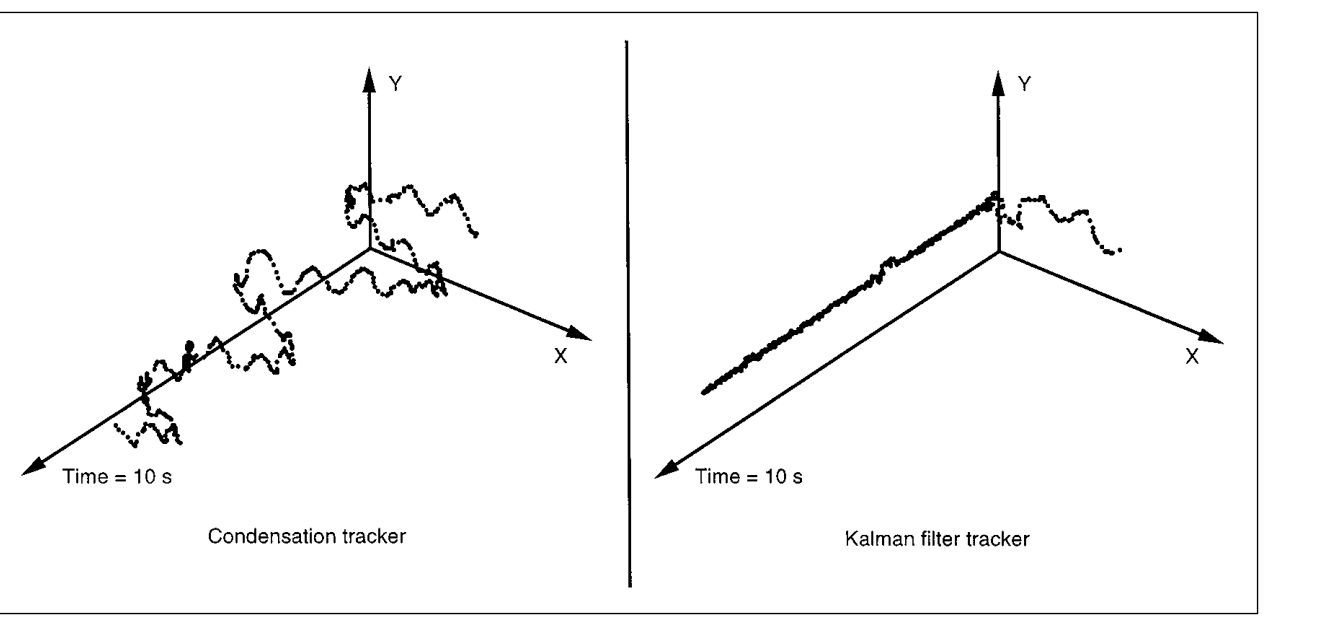
读图:左右采用相同运动模型,却因密度表示不同而出现不同跟踪结果。看右侧轨迹被杂波拉走的时段,再对照左侧保留的轨迹;这仍只是所示序列的比较。
实验设置与训练来源
| 实验 | 数据与模型 | 想验证什么 |
|---|---|---|
| 三人房间 | 70 帧、2.8 s,手绘头肩模板与平面仿射变形,1000 粒子 | 能否保持多个位置峰并经历遮挡 |
| 舞者头部 | 500 场、10 s 测试;学习运动模型,100 粒子;初始化手动放置窄分布 | 杂波与敏捷运动下是否恢复 |
| 手部运动 | 500 场、10 s 测试;12 维形状空间;初始 1500 粒子降到 500 | 较高维轮廓与手指变形 |
| 风中树叶 | 600 场、12 s 示例,手绘叶片模板,迭代学习运动模型 | 相似背景与临时遮挡 |
这里“场”是交错视频的 field,不应与完整 frame 随意换算。三人示例采用 40 ms 帧采样,舞者与手部例子按场处理,论文不同速度数字要结合这一差别阅读。
运动模型训练也并非零人工成本。舞者先在较干净背景下使用 Kalman 轮廓跟踪器取得一段训练轨迹,学习后再延长可跟踪的训练段;测试才加入杂波。手部形状由多个手绘模板、PCA 和分阶段跟踪学习建立。三人训练使用背景建模,测试的 CONDENSATION 没有这一背景消除帮助。
这些设计说明作者在检验“学到运动先验后能否抵抗杂波”,并不等于从任意原始视频自动发现任意未知对象。论文没有提供现代大规模数据集上的身份关联指标或多随机种子置信区间。
五处证据及其限度
1.Fig. 1–图 2,pp.6–7。 高斯密度传播与一般密度漂移、扩散、观测强化形成对照。图解释为何需要多峰表示,但这是机制示意而非性能曲线。
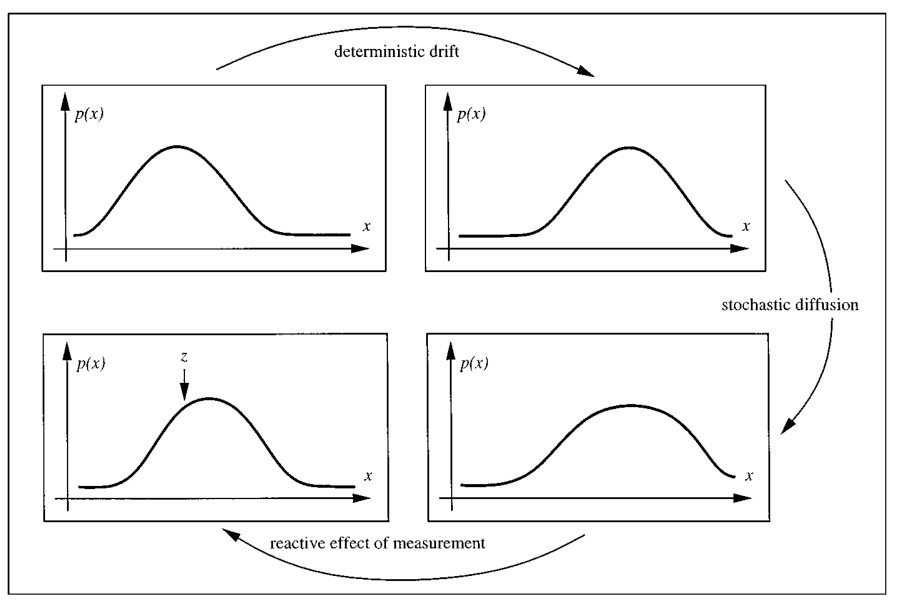
读图:按箭头顺序读四个分布;在高斯假设下,变化仍可由均值和协方差概括,这是后续多峰传播图的对照。
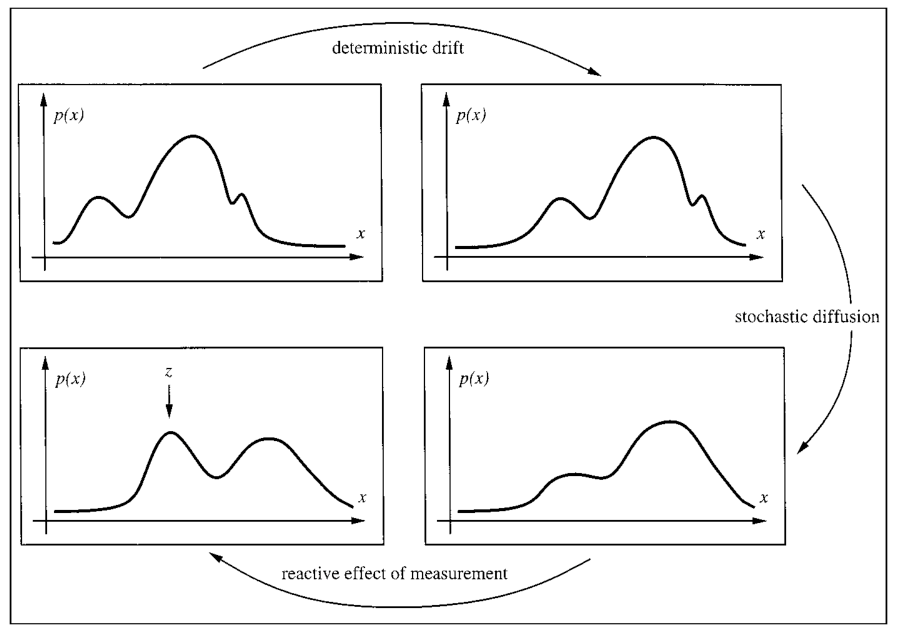
读图:与图1比较,多个峰可在预测和校正后继续存在;保留竞争假设是粒子表示的关键,并非仅让单个高斯变宽。
2.Fig. 9–图 10,pp.16–17。 三人序列的横向状态投影形成三个峰,移动者的峰与其他峰合并后再分开。它支持多假设保持;它不是具有身份标签、出生消失建模和完整关联评估的现代多目标跟踪器。
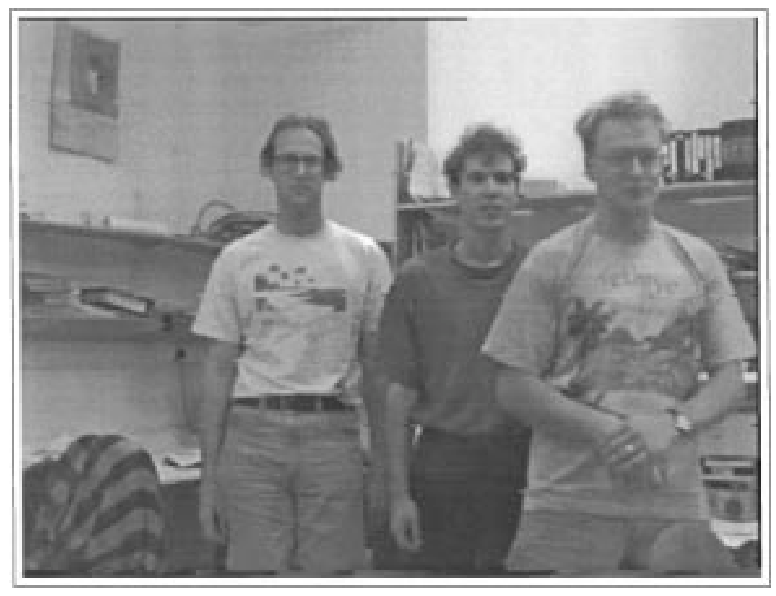
读图:此图建立图10的目标与遮挡关系:一个人物移动到另外两人前方;它本身不是跟踪精度结果。
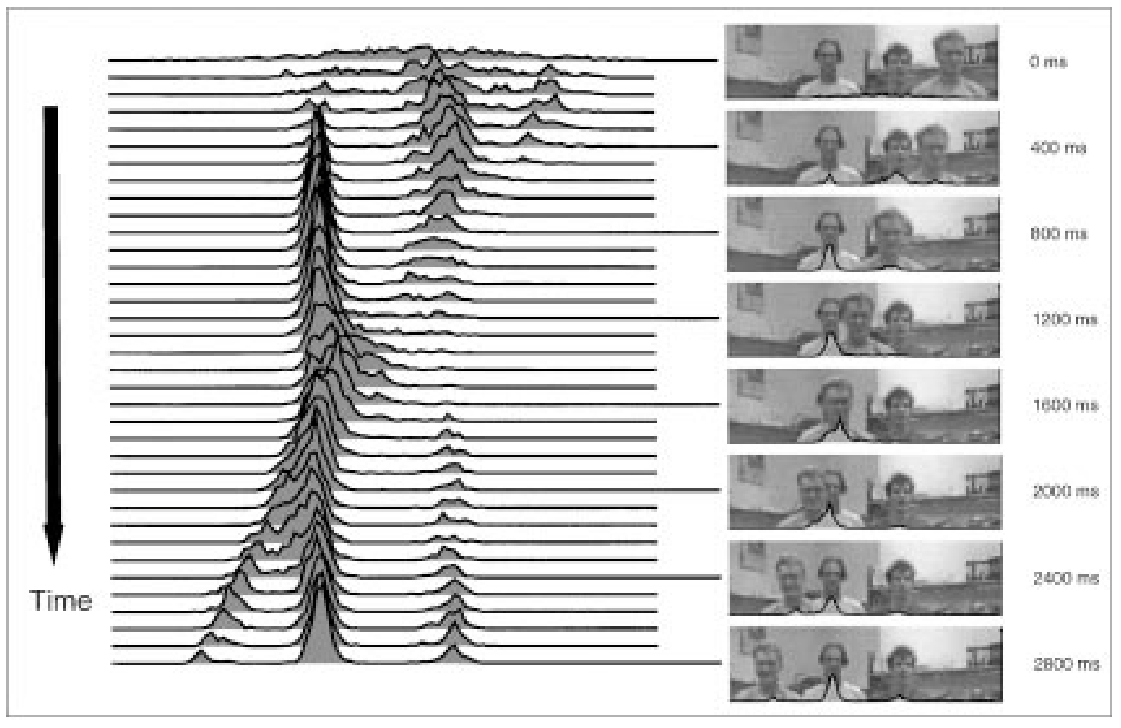
读图:左侧密度峰与右侧人物位置对应,时间向下推进;峰的合并和分离说明多假设能在遮挡期间继续传播。
3.Fig. 12–图 13,pp.19–20。 使用同一运动模型的 Kalman 对照约在 0.8 s 后被杂波吸引,而所示 CONDENSATION 运行完成舞者序列。分布在约 900–960 ms 之间受干扰、分裂并恢复,直接展示保留次要峰的价值。它不能证明所有初始化、所有视频中都能恢复。
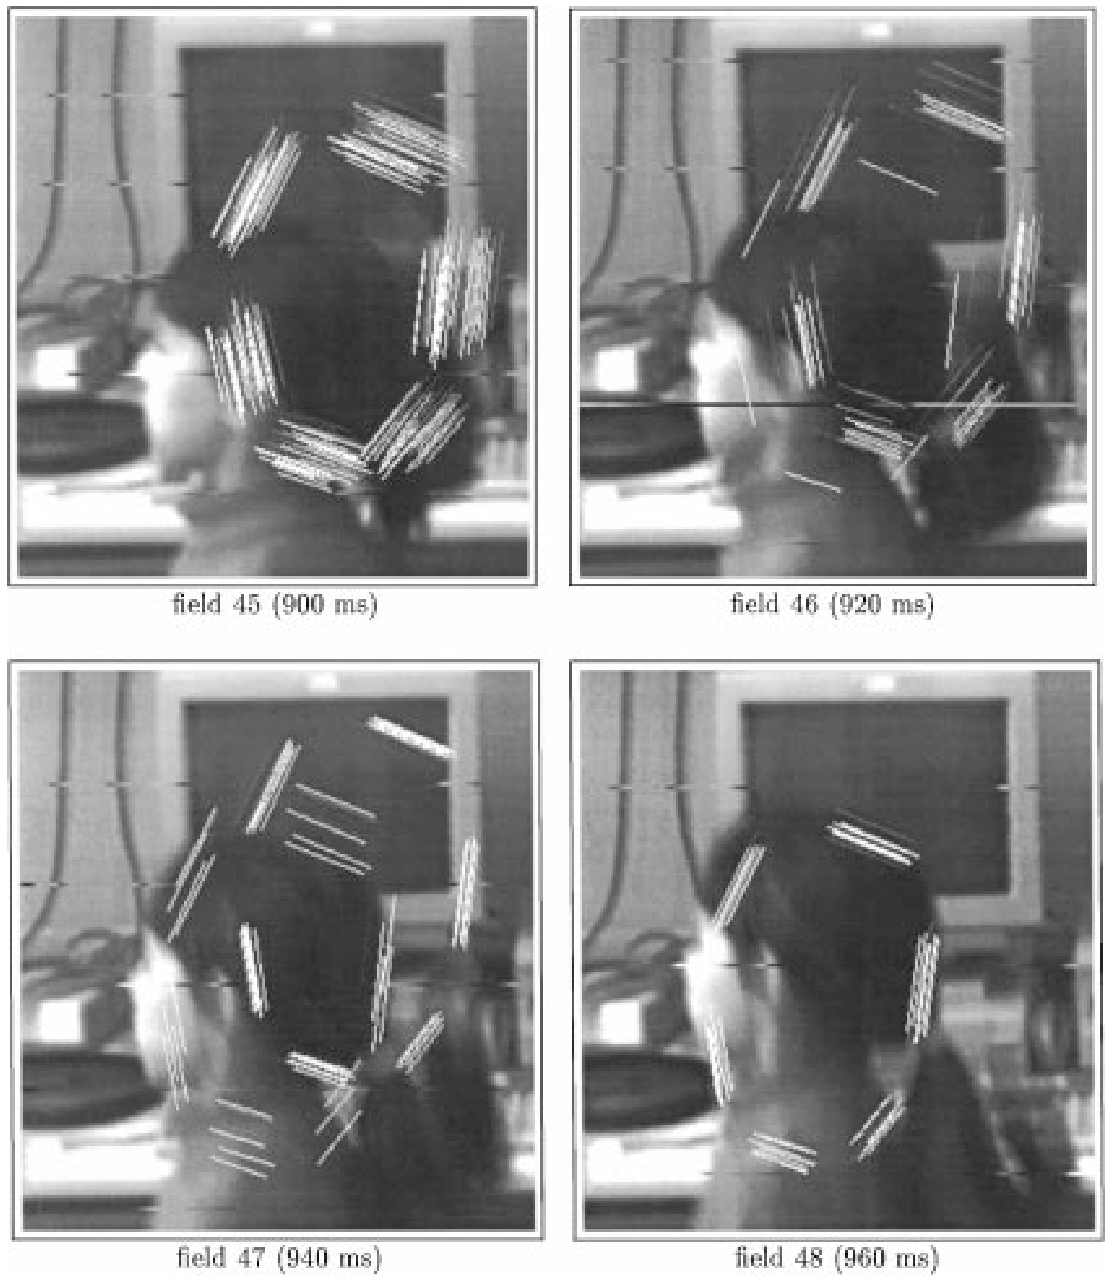
读图:四面板分别为900至960毫秒;先看错误假设如何分裂,再看概率较高的假设回到人物,不能把单帧恢复当作保证。
本页定位:图 12内嵌图。
4.Fig. 16,p.22。 手部序列从 1500 粒子过渡到 500,表明大范围初始化需要更多覆盖。成功的 12 维形状例子并不推出维度继续增长时样本需求仍然温和。
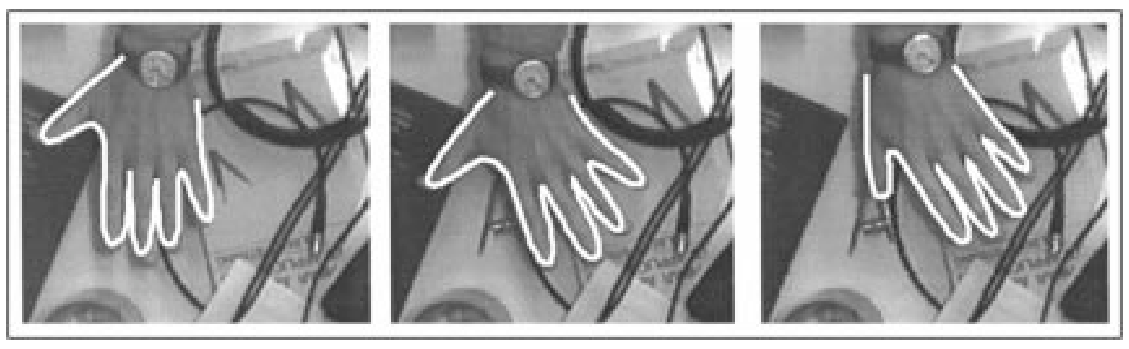
读图:三帧轮廓既平移旋转,也随手指形变变化;这是特定形状模型与样本设置下的展示,不能外推为任意手势识别。
5.§7.4 与 §8,p.23。 树叶配置下,1200 粒子约 6.5 Hz,200 粒子约 25 Hz,但后者偶有轮廓错位;六维形状、100 粒子的另一配置报告 50 Hz。硬件为所述 200 MHz SGI Indy 工作站。这些是不同配置的计算权衡,不能把 50 Hz 套到最困难的 1200 粒子实验。
五、区分多峰表示、初始化与多目标身份跟踪
作者把分布传播从一个抽象统计表达变成了可运行的视觉轮廓系统:采样不需要将所有分布强制压成高斯,观测模型允许杂波与漏检,运动模型则把搜索集中到合理位置。
代价是粒子数、形状子空间和模型训练。高维、快速运动或低概率目标模式都会增加所需计算;重采样还可能随机淘汰一个暂时弱但后来正确的假设。论文展示了若干恢复例子,没有承诺错误峰永远不会胜出。
一个反直觉是:维护了完整多峰分布后,输出均值可能反而丢掉最有价值的信息。三个人的位置平均值可能不在任何人身上。作者在结论中明确指出均值不适合此类情况,并提出模式查找等后续方向。因此系统接口也需要能表达多个候选,而不只是“一个坐标加置信度”。
六、追问:正确峰已经被全部重采样掉时,未来图像更清晰为何也未必能恢复?
正确峰已经被全部重采样掉时,未来图像更清晰为何也未必能恢复?
参考答案:观测只能给现有或新生成的候选重新赋权,不能保证在没有支持样本的区域自动出现正确状态。恢复还依赖传播模型、样本数量或额外初始化机制。应在同一图像序列上记录正确区域的样本存活,而不能只用最后一帧的视觉清晰度解释成败。
七、将多峰状态表示迁移到定位
- 模块组合:Monte Carlo Localization:让位置假设跟着证据聚拢。将多假设后验转到已有地图中的机器人定位。
八、自测与参考答案
问题 1:两个目标位置的概率相同,输出均值为什么可能完全错误?
参考答案:均值最小化平方误差意义下的平均损失,但可能落在两个峰之间的低概率区域。若下游要选择一个真实目标,应该看模式、任务条件或保持多个候选,而不是把统计平均当成必然存在的目标。
问题 2:观测模型非常精确,为什么 bootstrap 式粒子传播仍可能失败?
参考答案:粒子先从运动预测分布产生;若真实位置的高似然区域很窄,有限样本可能一个都没落进去。重新加权只能改变已有样本的相对权重,不能生成没有采到的位置。更好的提议分布、更多样本或更合适的运动模型可能缓解。
问题 3:三人实验形成三个峰,就等于完整的多目标身份跟踪吗?
参考答案:不等于。多峰表示多个可能位置,但没有自动为每个人建立持续身份、处理新目标出现与消失,也不保证遮挡后身份不交换。原实验有力证明多假设表示能力,完整多目标系统还需要更丰富的状态和关联机制。