007|PILCO:把模型不确定性传播到长期回报
原论文:PILCO: A Model-Based and Data-Efficient Approach to Policy Search,Marc Peter Deisenroth、Carl Edward Rasmussen,ICML 2011。原文。
先接住前作的问题
PI²可以按试验成本改进动作参数,却不把学得动力学的未知部分显式传播到长期预测。PILCO改问:数据只有几条时,能否借助模型不确定性谨慎地评价策略?这里比较不同信息利用方式,不宣称PILCO直接改写了PI²。
五个前置概念
五个前置概念是高斯过程、后验不确定性、矩匹配、全方差公式和链式求导。它们依次解释模型、信心、分布压缩、误差传播及策略更新。
一、问题设定:少量交互下怎样避免策略利用模型猜测
只观察过几次摆动,机器人可以拟合出很多不同的动力学函数。若随便选一个确定模型,再在它上面优化长轨迹,策略就可能利用模型在未知区域的错误。PILCO 的出发点是:不仅学习预测均值,也要把“模型还不知道什么”带入未来状态与成本的计算。
| 要素 | PILCO 中的含义 |
|---|---|
| 状态 | 连续位置、速度等任务状态 |
| 动作 | 连续控制输入,经过约束映射 |
| 模型数据 | 到 |
| 策略 | 可求所需统计量的参数化控制器 |
| 目标 | 累积期望状态成本 |
| 初始信息 | 目标、状态表示、成本与模型形式 |
| 新交互 | 优化后策略执行产生的新转移 |
没有示范和已知动力学方程,不等于完全没有先验。平方指数核倾向平滑函数,状态选择规定了可观察信息,成本形状规定了目标附近的偏好。PILCO 的样本效率应放在这些条件下理解。
二、传播状态分布并对期望成本求导
它使用高斯过程学习状态增量,通过矩匹配近似传播状态分布,再对长期期望成本解析求导,更新策略参数。不需要另训练一个价值网络。原文 §2、图 1–2
1. 一步预测有均值,也有方差
高斯过程对状态增量给出后验预测。离数据较远时,模型可以表达较大不确定性,而不是始终输出一个自信点估计。这改善的是模型表达方式,不是保证所有真实误差都被正确校准。
2. 下一步输入本身也不确定
当 是随机变量, 也随之变化。因此必须计算状态与动作的联合分布,而不是先取平均状态再执行策略:
对非线性策略一般成立。忽略这种区别,会错估未来状态和控制变化。
PILCO 近似用高斯表达联合输入与输出,同时尽量准确保留均值和协方差。状态更新为 ,其协方差含有交叉项:
这些项不是细枝末节:状态与未来增量往往相关,不能把两者当独立噪声随便相加。
3. 对分布中的成本求平均
策略目标为:
成本与分布形式选择得当时,期望及其关于参数的导数可以解析计算。策略改进因此沿“参数→动作统计→未来状态统计→成本”的链条进行,而不对真实环境反向传播。
有一个容易被“概率模型”遮住的近似:同一个未知物理参数会在整条轨迹持续作用,而逐步矩匹配可能把它近似成每步重新抽样的噪声。作者在讨论中明确指出没有保留这种时间相关性,可能低估模型不确定性。原文讨论
教学推导:若每步恒定未知位移偏差 的方差为 ,连续 步位置误差为 ,方差是 ;若误当成独立的 ,得到的却是 。这与下一节“均值相同、方差不同”的例子互补:既要传播方差,还要问方差代表什么。真实cart-pole的少量交互结果证明该近似在那组任务里有用,并未使相关性问题消失。
一个方差不能忽略的例子
教学构造:目标为 0,成本为 。两个预测分布都均值为 0,但方差分别为 0.01 与 1。只看均值会认为两者成本都是零;实际期望成本为:
所以分别是 0.01 与 1。不确定性直接改变哪种动作更好。
但也不能据此说“PILCO 永远远离不确定性”。对饱和或非二次成本,不确定性可能改变进入目标区域的概率,产生不同探索倾向。具体效果取决于成本形状和近似分布;概率传播本身不等同于显式信息增益探索。
三、固定概率模型优化策略,再用新轨迹更新模型
矩匹配提供联合均值与协方差后,长期成本才成为可对策略参数求导的近似目标。内层先固定GP做策略优化,外层再真实执行并更新GP;若把这两个阶段混在一起,就说不清梯度基于哪个模型。
输入:状态表示、目标成本、初始策略
执行少量探索轨迹,得到转移数据 D
重复:
    用 D 学习每个状态增量维度的高斯过程
    在模型固定时:
        初始化状态均值与协方差
        对整个规划时域:
            计算策略产生的动作及状态动作联合统计
            经 GP 传播均值、协方差和交叉协方差
            累积期望成本
        对策略参数求解析梯度并优化
    在真实系统或指定仿真执行优化后策略
    将新转移加入 D
输出:控制策略与概率动力学模型
这里的内层优化可以进行很多次而不新增真实交互,这正是数据效率来源之一。但 GP 训练和长期矩传播有计算成本;数据不断增加时,矩阵运算也会变重。若只报告真实系统运行了多少秒,就遗漏了离线优化时间。
四、区分真实交互时长与模型优化成本
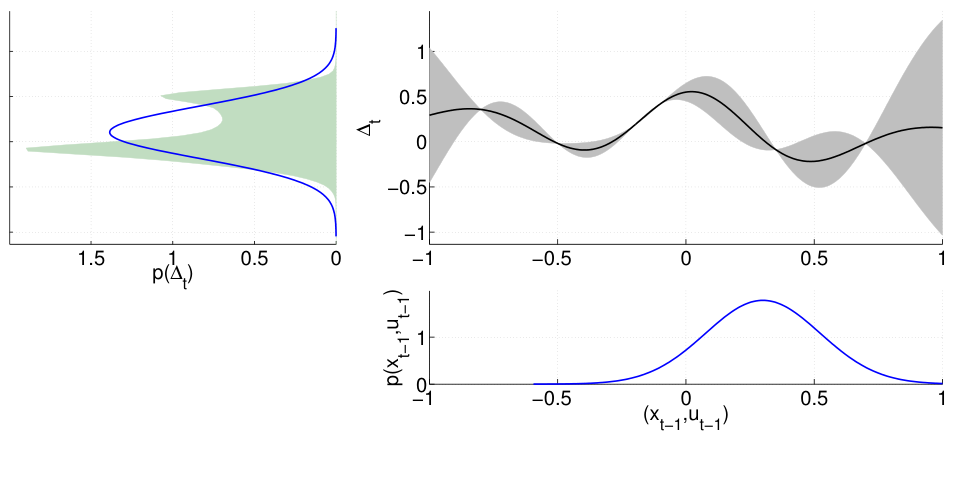
原图怎么读: 图2,PDF第3页。先看输入高斯怎样经过GP映射变成非高斯输出,再看匹配均值和方差的高斯近似。阴影不是“真实未来一定在其中”的硬边界。
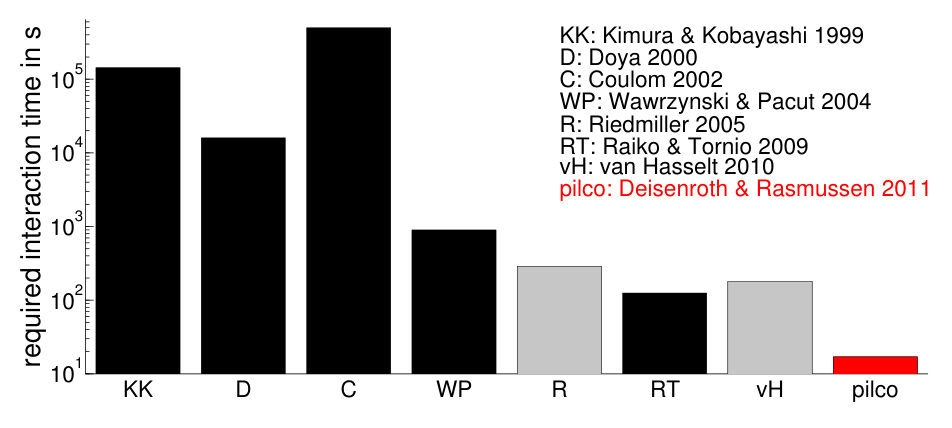
结果图怎么读: 内嵌图5聚焦样本效率:纵轴是完成杆摆起任务所需的交互秒数,采用对数尺度;横轴按研究年代排列,不是训练迭代。各柱来自不同文献与任务条件,红柱展示PILCO的报告结果,不能把整幅图当成同一协议的随机种子对照。
| 位置 | 实验或分析 | 支持的结论 | 边界 |
|---|---|---|---|
| 图1 | 少量数据下的模型歧义 | 确定预测可能过度自信 | 示意图不等于模型校准测试 |
| 图2、§2.2 | 不确定输入下的矩匹配 | 算法保留哪些统计量 | 高阶结构仍可能丢失 |
| 图3、§3.1 | 真实 cart-pole 摆起和平衡 | 少量真实交互可学会特定控制任务 | 不是通用机械臂操作 |
| 图4、§3.3 | 独轮系统仿真 | 较高维状态下可学习平衡 | 不能标为真实独轮车实验 |
| 表1、图5 | 任务与文献交互时间比较 | 样本利用具有优势 | 任务、成本、基线设置并非完全统一 |
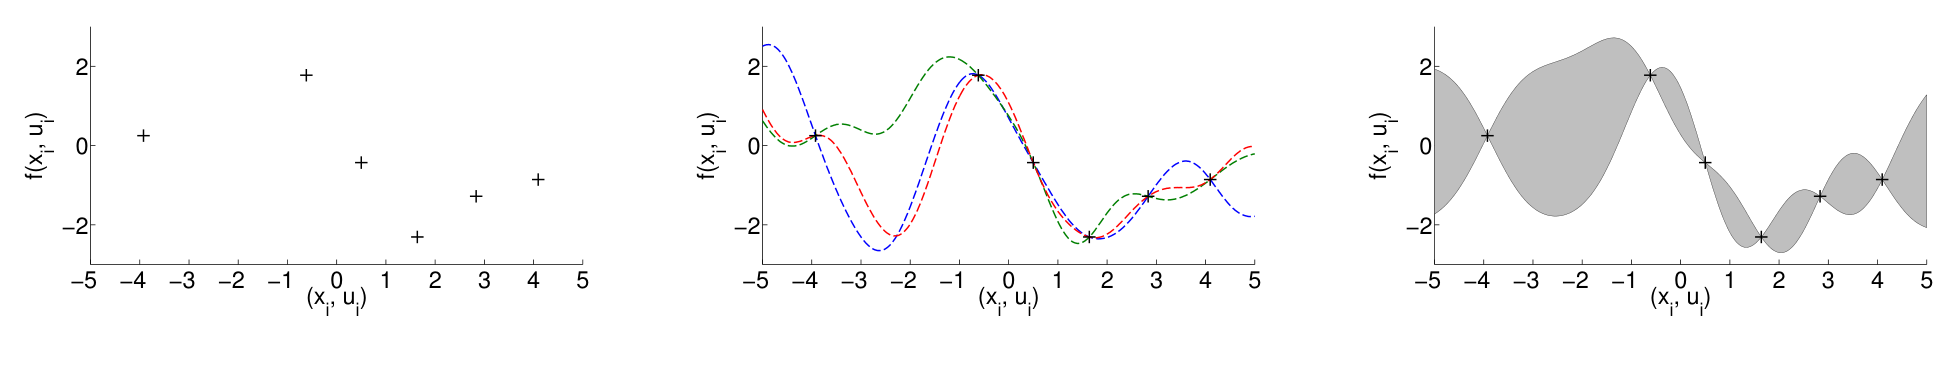
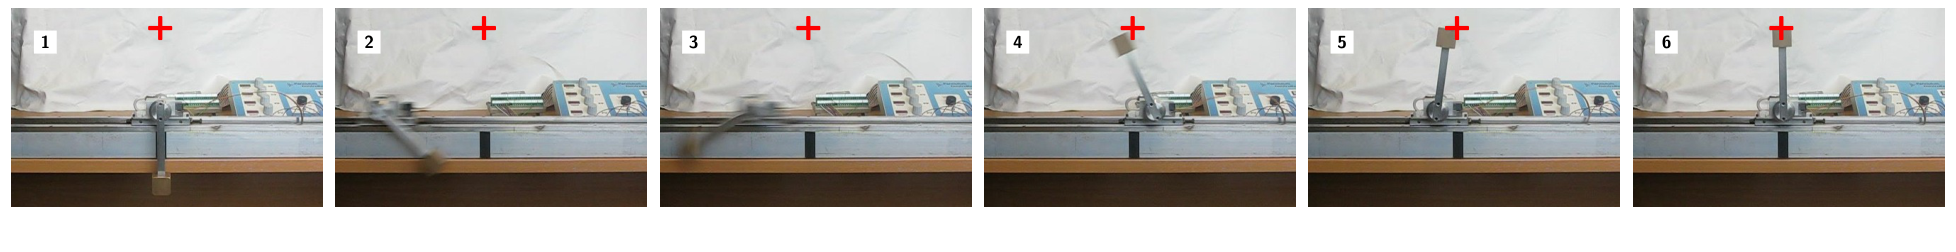
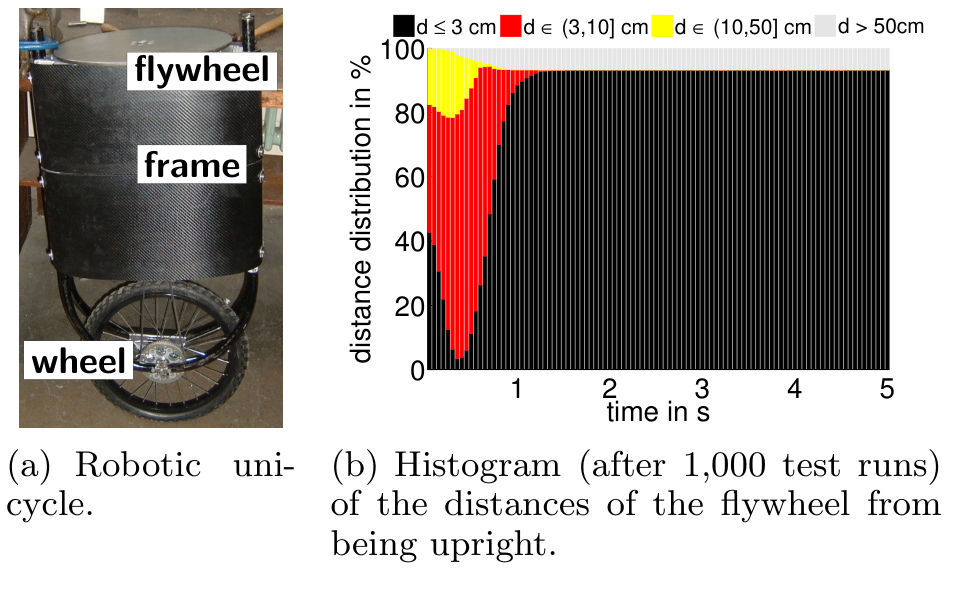
图3 报告真实 cart-pole 使用 17.5 秒交互获得相应行为。独轮仿真在 1000 次测试中约 93% 成功;极端初始姿态受到力矩限制。表1 还列出不同任务的状态与参数维度,这两种维度不能混称机器人自由度。
图5 汇集文献数据,而非全部方法在同一实现中重跑。原文也注明部分基线只做平衡、不做摆起。因此应将它看作历史样本效率背景,而不是严格控制全部变量的排行榜。
五、检查高斯近似遗漏的多峰未来
第一,后验依赖模型家族。接触产生不连续变化,平方指数核可能平滑掉关键边界。模型可能知道数据少,却未必正确表达“接触或不接触”的两种模式。
第二,矩匹配把多峰分布压成单个高斯。例如一半轨迹从障碍左侧绕过,另一半从右侧绕过,平均状态可能落在障碍内部。保留正确均值方差不等于保留完整几何可行性。
第三,长时域近似误差可以累积。每步预测都看似合理,连续组成的轨迹仍可能不准确。一次真实执行再追加数据是必要的校正环节,不能无限信任固定模型。
追问:两个真实未来分支被矩匹配合成一团,会给控制带来什么误判?
参考答案:匹配均值与协方差不保留完整分布形状。若两个安全分支之间是危险区域,单高斯近似可能给中间区域不恰当的概率质量,进而改变期望成本和梯度。可在同一拟合模型上对照近似传播与更细的采样成本估计,先定位传播近似误差,再区分动力学模型本身的误差;这不是原文已运行的新对照。
六、沿机制关系继续读
后来的PETS同样认真处理模型不确定性,但使用概率集成与粒子规划,是平行模型学习路线;PILCO对策略求解析梯度,PETS在预测器上搜索动作。二者共享问题,不能只按年份画成一个网络替代一个高斯过程的直接继承链。
七、自测题与参考答案
问题 1:两个未来状态预测均值相同,为什么最优动作可能不同?
参考答案:成本通常是非线性的,期望成本取决于方差及更高阶结构。对平方成本,均值相同但方差较大的分布成本更高;换一种成本,影响还可能不同。
问题 2:为什么更新协方差时不能只写旧方差加增量方差?
参考答案:增量依赖当前状态,两者通常相关。相关项可能放大或减小下一状态不确定性,忽略它会使长期预测系统性偏差。
问题 3:能解析求梯度,是否意味着得到了真实系统的精确梯度?
参考答案:得到的是所用概率模型与近似推断过程中的梯度。它可以计算准确,却仍相对真实物理过程有模型与分布近似误差。模型内精确和现实中正确需要分开。