018|域随机化:让真实视觉成为一种变化
原论文:Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World,Josh Tobin 等,2017。原文。
先接住前作的问题
渐进网络提供一个阅读起点。Progressive Nets允许在真机上训练适应列,但这仍需要目标域交互。视觉域随机化追问另一种选择:能否在模拟训练时就打散外观捷径,使定位网络直接面对真实图像?这里改变的是观测分布,不是动力学参数。
五个前置概念
五个概念是:域随机化在训练时主动改变环境外观;域适应利用目标域信息缩小差距;合成标签从模拟场景直接读取真值;捷径特征指训练中相关但部署时不可靠的线索;归纳偏置指数据与模型设计偏好某些解释。
一、问题设定:不追求照片逼真怎样学到可迁移定位
如果仿真图像和真实图像不一样,常见思路是把渲染做得更逼真。Domain Randomization 提供另一条路径:让模拟场景的纹理、灯光、相机和干扰物大量变化,使模型无法依赖某一种外观捷径,只能寻找更稳定的线索。
输入单张单目图像,输出目标物体中心的笛卡尔坐标。物体的大小和形状已知,用网格模型在模拟中渲染;颜色则随机化。桌面高度固定,因此虽然输出写作三维坐标,任务实质具有强烈的平面定位约束。
没有真实训练标签不意味着系统完全不接触真实设置。相机名义位置按现实视角大致摆放,然后在附近随机;目标形状和桌面几何也是先验。准确说法应是“无需用真实样本继续训练该视觉模型”,不能扩写为“对真实环境没有任何信息”。
二、随机化外观并保留定位标签语义
这篇经典论文主要研究的是视觉定位网络从仿真迁移到真实环境,再接现成运动规划完成抓取。它不是训练端到端强化学习抓取策略,也没有通过随机质量、摩擦来学习鲁棒控制。
设物体位置为 ,视觉扰动为 ,渲染器生成 。训练目标可概括为:
是定位网络。这个公式是教学概括,不是原文额外提出的定理。扰动包括纹理、光源、相机视角、图像噪声,以及场景中的干扰物。模拟器提供位置真值,因此不需要人逐张标注。
直觉是同一形状在各种颜色下都应被正确定位,网络便不能把“红色”等同于“目标”。但随机化必须保留任务可辨识性:若目标与干扰物在全部可观测信息上完全相同,却要求输出某一个指定实例,就需要额外身份条件,光靠随机纹理无法解决。
随机化不是越强越好
若现实相机只在很小范围内变化,却训练到任意朝向甚至完全看不见桌面,模型需要覆盖更多无关情况,可能浪费容量。这是方法设计分析,不是本文已完成的最优随机化范围理论。合适分布需要覆盖真实差异,同时保留定位所需的几何信息。
原文在大致匹配的相机附近随机位置、朝向和视场,而非任意全球视角。物体纹理可用纯色、渐变和棋盘格生成,刻意不依赖逼真材质。这里追求的不是图像看起来像照片,而是训练过程中不稳定因素足够多。
网络与控制的分工
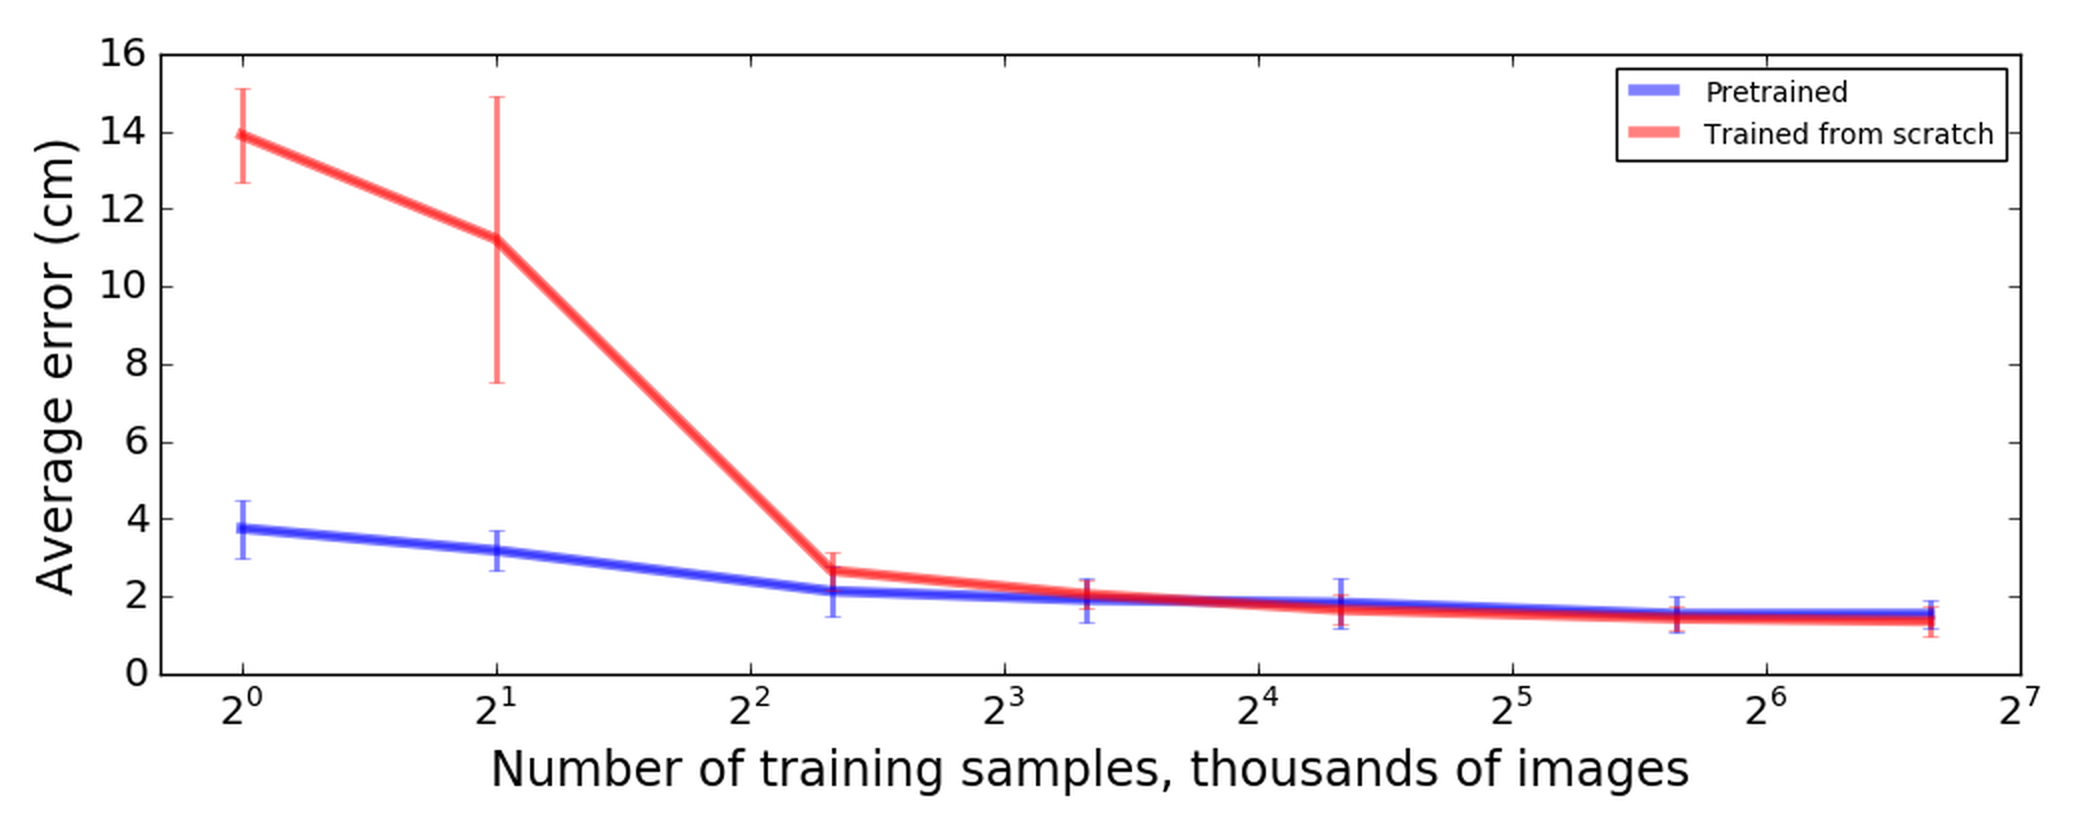
视觉网络采用改造的 VGG-16,回归位置。实验比较 ImageNet 初始化与随机初始化。前者使用额外真实图像预训练,后者才是更严格的纯模拟视觉训练;不能把两种结果混写成同一个条件。
执行阶段,位置估计交给现成运动规划器,再执行预设抓取。网络没有学习抓取力、接触策略或从失败恢复。把系统拆开后,才能判断抓取成功究竟证明了视觉精度足够,还是证明策略学习有效;本论文主要支持前者。
数学优化对象是位置误差;算法机制是训练分布设计;最终指标包括厘米误差与抓取次数。三者应分别报告,没有策略回报最大化或价值函数。
随机化的作用可以写成一个条件独立目标:让位置预测尽量不依赖与位置无关的纹理 ,但绝不能抹去承载位置的投影几何。教学设定中,训练时红色总对应左侧,网络可以只看颜色;让每种颜色均匀出现在左右两侧,颜色捷径就不再减少期望误差。若同时把相机位姿完全未知地改变,二维外观与三维位置的关系可能变得不可辨识,需要可观察的几何线索。
因此原文围绕大致相机配置随机化的限制很重要:它并非任意视角不变定位。抓取演示的证据应追溯到定位误差是否低于夹爪容差,不能把现成规划器的成功全部归给学习到的控制。这里的因果拆解是教学分析。原文渲染与相机设置
一个自构例子
未运行的教学例子:模拟目标立方体总是红色,干扰圆柱总是蓝色。网络可能只寻找红区域,真实目标换成绿色便失败。若两者颜色每次随机,颜色不再稳定,网络更可能使用形状。
但若把立方体和圆柱都远距离渲染到只有一个像素,它们仍无法区分。随机化消除了错误捷径,却不能创造不存在的信息。因此“去掉颜色依赖”与“保持足够分辨率”必须同时满足。
三、同步生成随机外观与定位标签
随机化的对象是纹理、灯光和相机等观测因素,定位监督仍必须对应正确坐标。训练得到的是感知网络,后续抓取由已有控制与规划接口完成。
准备目标物体网格、桌面几何和大致相机范围
重复生成模拟样本:
    随机目标位置和干扰物
    随机物体、桌面、背景纹理
    随机光源、相机与可选图像噪声
    渲染图像,读取目标真实位置作为标签
训练位置回归网络,可比较预训练与随机初始化
真实部署:
    输入真实相机图像,预测目标位置
    将位置送入运动规划器
    执行预设抓取,独立记录定位误差与抓取结果
四、同时核对定位误差与下游抓取口径
作者报告纯模拟 RGB 训练可以得到有用的真实定位能力。实验支持已知形状物体、限定桌面与相机范围内的定位和抓取。
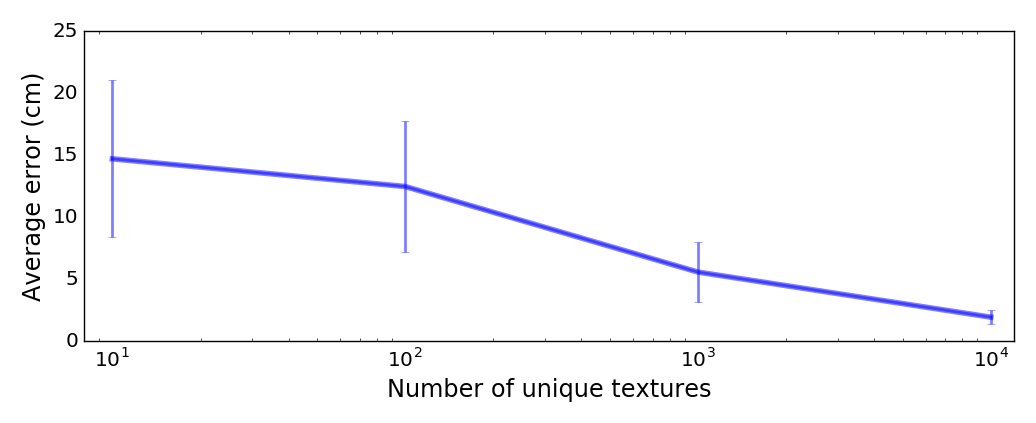
原图怎么读: 图5,原论文图注与图像。本图固定了物体位置与干扰物组合的训练规模,改变独特纹理和光照的数量;它检验外观多样性,区别于图4增加总训练样本的实验。
| 项目 | 原文设置 |
|---|---|
| 定位对象 | 8种几何物体,各有模拟网格 |
| 真图测试 | 480张,每物体60张,分独立、干扰、遮挡各20张 |
| 真实相机 | 测试图中位置固定,周边杂物与照明未严格控制 |
| 合成数据 | 图4改变图像数;图5固定1万训练样本改变纹理多样性 |
| 消融 | 移除噪声、相机随机化、干扰物,表II均用2万训练样本 |
| 预训练 | ImageNet与随机初始化分别比较,不能忽略前者额外数据 |
| 抓取 | Fetch机器人,用预测位置和现成规划器执行 |
| 调参 | 2种学习率、3种batch size的小搜索,报告最佳模型 |
| 统计范围 | 图像误差与有限抓取试验;未在这里核实每个配置的独立种子重复数 |
测试集已知形状、未知外观与杂乱条件,不是任意未知物体类别定位。模型能够忽略颜色是设计目标,但它仍需要目标的尺寸和形状信息。
图像定位准确不保证所有抓取成功。夹爪容差、预设姿态和规划器共同决定任务结果。若要迁移到毫米级装配,应重新定义误差需求,不能直接拿这里的厘米级结果作依据。
五处证据及反直觉结果
依据原始论文全文。
| 位置 | 观察 | 支持与限制 |
|---|---|---|
| 第III-A节 | 固定桌高、相机近邻随机、纹理变化 | 明确迁移所依赖的场景先验 |
| 表I | 不同形状、干扰和遮挡条件误差不同 | 定位有效但不是处处同精度 |
| 图4、图5 | 纹理数量与样本量影响真实迁移,随机初始化可接近预训练 | 不代表预训练一般没有价值 |
| 表II | 无干扰物训练时,真实干扰条件平均误差7.2cm,完整方法1.8cm | 支持干扰覆盖的重要性 |
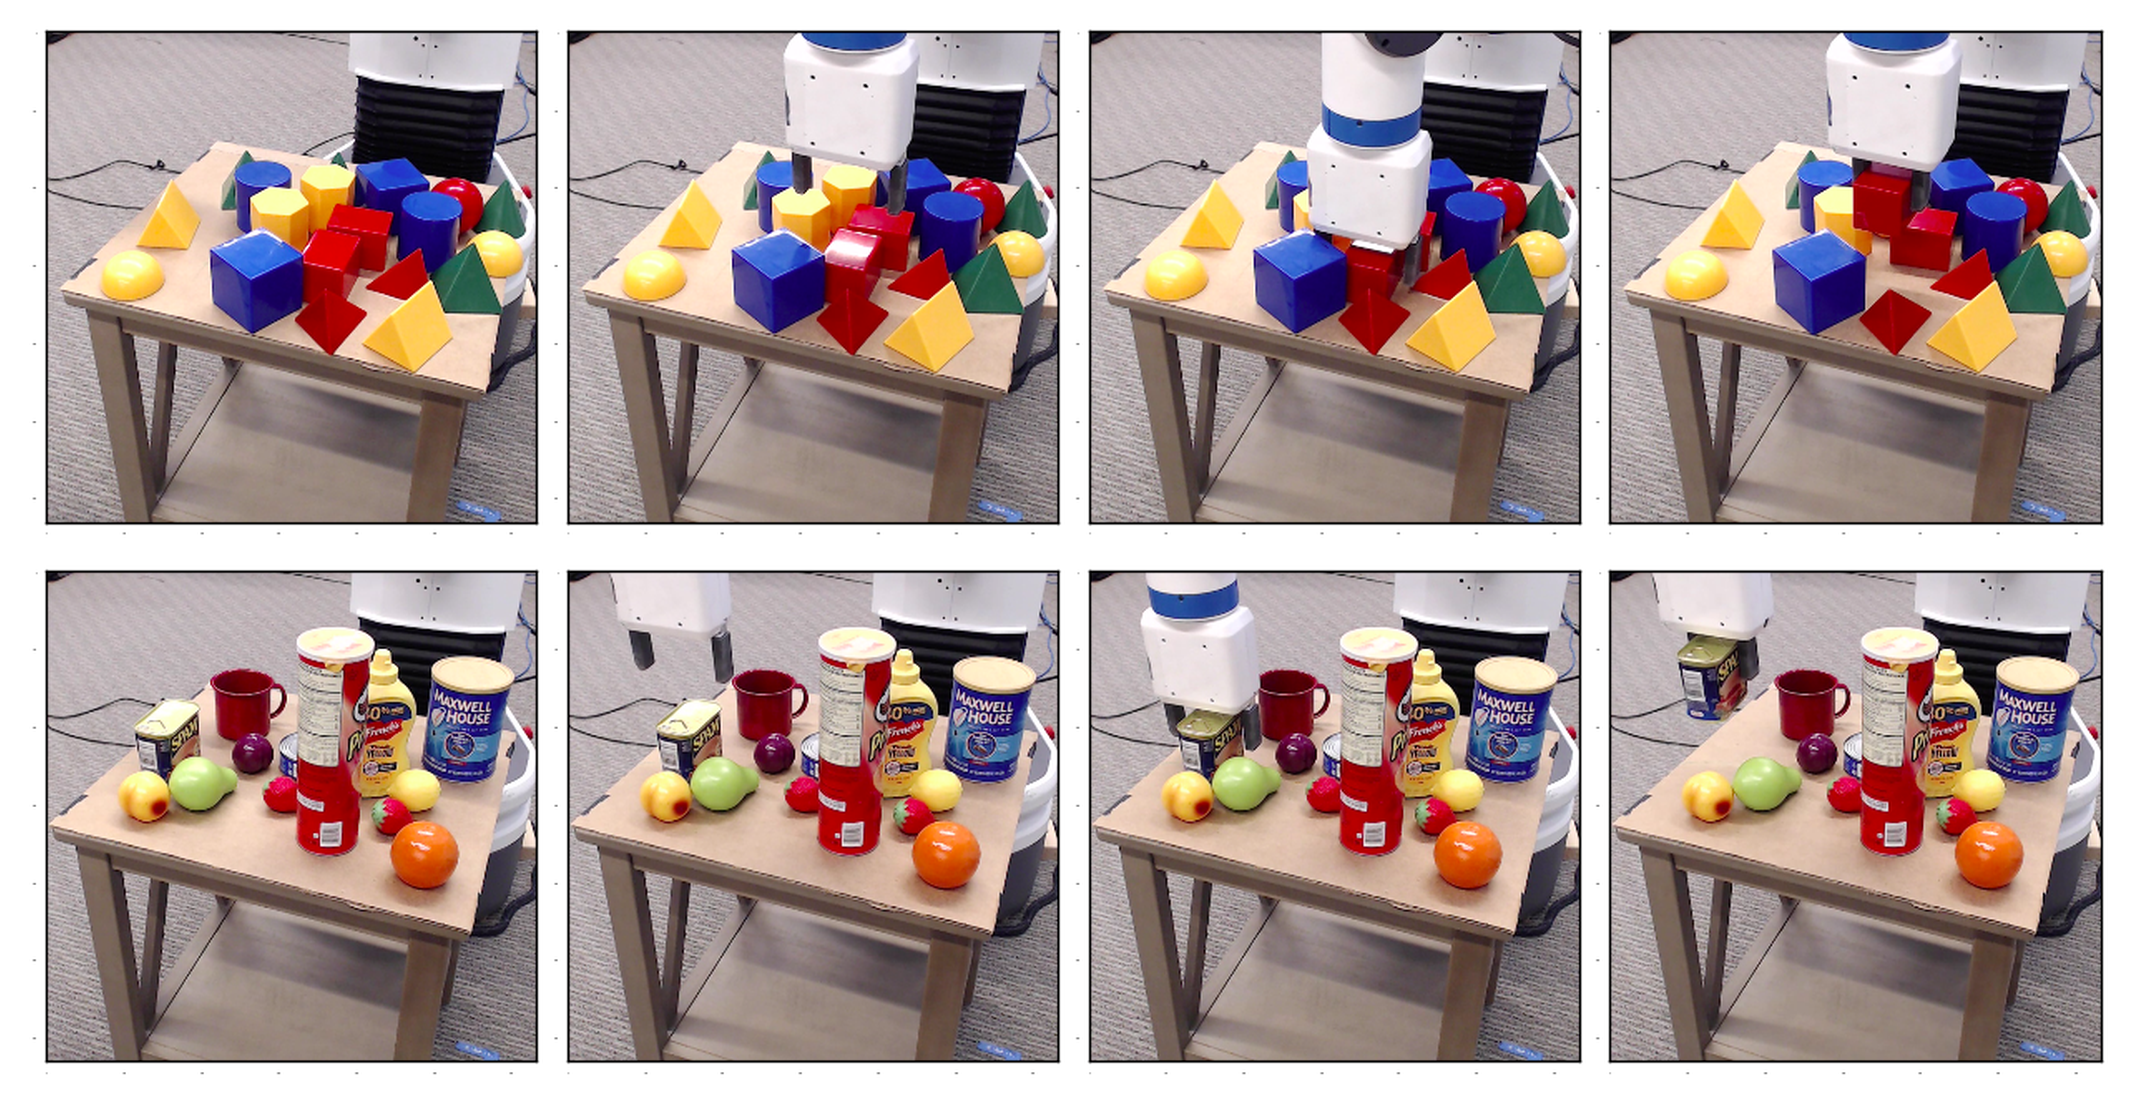
| 第IV-D节、图6 | 几何物体抓取38/40,食品罐9/10 | 有限系统级试验,不是通用抓取成功率 |
表II两项中心值差为5.4cm;但不能据此说域随机化每个因素都有同等价值。原文发现图像噪声影响较小,相机扰动有帮助,而干扰物与纹理多样性更关键。
随机初始化可工作的结果也有条件:数据少时预训练更有帮助,合成数据充足后差距变小。正确结论是模拟数据能在这些任务上提供足够训练信号,而非现实视觉预训练从此无用。
五、限定形状和相机范围之外重新验证
主要假设是任务相关几何在模拟与现实之间足够一致,而变化主要落在随机化能够覆盖的因素中。若真实物体形状差异很大、透明折射严重,或定位需要从图像推断不同桌高,本文没有提供统一解决方案。
作者把更高精度与接触丰富操作列为未来方向。复现时还要警惕选择偏差:在真实测试上反复挑最好的随机化分布,会把测试集变成隐形验证集。这里是评估分析,不能据此指控论文进行了未披露调参。本文解读未独立运行训练。
追问:随机化相机时若没有同步更新坐标标签,会发生什么?
参考答案:相同图像特征将对应不一致的物理位置,增强会从消除外观捷径变成引入监督噪声。应先明确标签是在世界坐标、相机坐标还是机器人坐标中定义,再逐项检查渲染变换与标签变换一致。标签语义不变是随机化有效的前提,增加图像数量不能修复系统性的坐标错误。
六、沿机制关系继续读
动力学随机化是平行方法:本篇主要打散外观相关性,后者改变动作后果分布。视觉上认得物体与施力后行为可靠是两道不同迁移关口,必要时可以组合而不能相互替代。
七、自测三题与参考答案
问题1:这是强化学习算法吗?
答案:这篇主要训练监督式位置回归器,再接规划器。域随机化可以用于RL,但不能因为它后来广泛用于机器人RL,就改写本论文实验方法。
问题2:训练图像完全不逼真,为什么仍可能迁移?
答案:如果任务依赖的形状与投影关系被保留,而颜色、照明等变化足够广,模型可以学到跨外观稳定的映射。不过这取决于真实任务的信息是否被模拟保留,不是“越假越好”。
问题3:38/40能证明对任意新物体都有95%抓取率吗?
答案:不能。95%只是两类选定几何目标、指定平台与预设动作下40次试验的经验比例。推广到新类别或操作方式,需要相应测试分布和重复实验。