036|Meta-World:多任务操作应该怎样比较
原论文:Meta-World: A Benchmark and Evaluation for Multi-Task and Meta Reinforcement Learning,Tianhe Yu 等,首次公开于2019;本文核对2021年的 arXiv v2。论文。
先接住前作的问题
RLBench提出可复用操作任务与少样本接口,但“新任务”究竟改变目标坐标还是操作结构仍需严格定义。Meta-World用共享机器人上的不同操作,分别考查联合训练与未见任务适应;它不是在相同协议上直接替换RLBench。
五个前置概念
五个前置概念:
- 任务条件策略:通过任务信息选择适当动作的共享策略。
- 负迁移:联合学习使某些任务比独立学习更差。
- 元训练:用一组任务训练能够快速适应的先验或机制。
- 上下文推断:根据过去转移与奖励判断当前任务。
- 奖励塑形:加入过程反馈,使最终目标更容易学到。
进阶追问与参考答案(3题)
进阶问题1:任务采样均衡是否足够?
参考答案:不够。相同采样次数仍可能产生不同奖励尺度、梯度范数和探索难度,简单任务也可能在优化中占优势。除了记录每任务曝光量,还应记录梯度贡献与成功率;比较均匀采样和按预先规定规则重加权,并保持总交互量相同。某任务低分不能仅靠增加抽样概率就保证解决。
进阶问题2:增加模型容量能否消除多任务差距?
参考答案:如果瓶颈是表示容量,扩大网络可能有用;若是任务信息缺失、稀疏探索或互相冲突的更新,更大网络未必解决。可做容量×任务ID可见性的二因素实验,再与等总参数和等交互预算的独立策略比较。观察训练误差、任务成功和遗忘轨迹,才能判断容量而非信息或优化是否主导。
进阶问题3:奖励归一化后梯度冲突是否仍存在?
参考答案:仍可能存在。正比例缩放能改变梯度大小,却不会必然改变两个任务梯度的方向;开门和拉抽屉可能继续要求共享参数向相反方向更新。可在相同共享层计算逐任务梯度余弦,并结合任务性能评估归一化前后变化。负余弦是诊断线索,不能单凭它认定所有共享表示都有害。
这些回答给出机制分析与待检验设计,不是已经运行的新实验结果。
一、问题设定:会做单任务为何不等于能联合学习和快速适应
会向不同位置推同一个物体,不等于会开门、关抽屉和装配。早期元强化学习常把目标速度或目标坐标变化称作“新任务”,但这类测试很难检验能否快速学会新的操作结构。
多任务学习让一个策略解决训练集合中的多个任务。它通常知道任务编号,可以写成 。测试重点是这个共享策略是否把各项技能学好。
元学习则利用训练任务获得适应机制,再给新任务少量交互,让策略快速识别并学会它。新任务编号不应直接泄漏答案,算法要从经验与奖励中推断目标。
Meta-World 将变化分成两类:同一种操作的目标位置变化,以及不同操作之间的结构变化。前者可用连续参数描述,后者例如从推物体变成开窗,接触约束与运动要求发生变化。两类变化都值得研究,但应分别命名。
基准采用仿真 Sawyer 机械臂。动作包含末端三维位移与夹爪控制,观察采用结构化状态。本文核对的是 arXiv v2,其中描述了固定维度观察与重新组织的奖励;它与最早版本或后续软件的细节不可自动混用。
为什么要共享机械臂和动作空间?如果两个任务连动作含义都不相同,性能差很难归因于知识迁移;统一底层接口,可以更集中地检验如何组织跨任务经验。
二、把多任务目标与元测试预算分别定义
Meta-World 构建共享机械臂、工作空间和控制接口的多种操作任务,再比较多任务与元学习算法。它不仅发布环境,还实际展示:单个任务能学会,不代表放在一起便能共同学好,更不代表能快速适应未见任务。
1. 联合训练的目标
对于任务分布 ,多任务目标可写成:
这里的共享参数 必须同时服务不同任务。每个任务单独存在一个好策略,并不说明同一训练过程可以轻松找到一组兼容参数。任务的梯度可能冲突,采样量也可能不均衡。
一个容易忽略的问题是奖励尺度。若某任务的奖励天然大十倍,即使所有任务同样重要,优化器也可能主要追逐那一项。论文努力让奖励具有相似结构与量级,减少这一人为偏差。
2. 元学习优化的是适应之后的效果
设 为少量适应交互, 是适应过程,则可写:
不同算法实现不同的 。MAML 用梯度更新;RL² 用循环状态保存经历;PEARL 从上下文推断潜在任务变量。它们共同面对的是“从有限经验判断新任务并行动”,而不是只能使用同一种神经网络结构。
这也解释了为何元训练成功率和元测试成功率应同时报告。训练任务都没学好时,测试差未必主要来自泛化;它可能首先是共享优化和探索失败。
3. 奖励是学习信号,成功率是评价信号
操作任务的塑形奖励包含靠近、抓取、放置等部分。它让随机初始策略更容易得到方向性反馈,但也给算法提供了人工知识。
一个教学示意是:
这不是论文各任务奖励的精确统一式;原文还包含条件、容差函数与任务特定组合。其直觉是把最终成功的稀疏事件分解为可逐步学习的进展信号。
成功指标则根据任务对象是否达到目标等条件判断。高回报可能来自反复靠近但不完成,因此不能把奖励曲线等同成功曲线。即使奖励量级一致,也还要使用明确的成功谓词检查行为。
4. 评价模式是一组不同的问题
| 模式 | 训练与测试变化 | 能回答什么 |
|---|---|---|
| ML1 | 同类操作的新目标配置 | 是否能适应参数变化 |
| MT10/MT50 | 共同训练十/五十类操作 | 是否能学好多种已见技能 |
| ML10/ML45 | 从训练操作迁移到留出操作 | 是否能快速适应新操作结构 |
MT 的多任务编号与 ML 的隐藏任务信息构成重要差别。不能仅凭“都包含十个任务”就将 MT10 与 ML10 当成同一难度。
它强调的是实验组织。具体实现仍需分别遵循 MAML、RL² 或 PEARL 的算法,不能把上述流程当成一个可直接替代三者的新学习器。
“每任务一样多步”和“总预算一样多步”不能同时默认成立。教学设定:单任务训练100万步,50任务各100万步共5000万步;若共享模型总共也只给100万步,每任务平均只得2万步。多任务方法较差可能同时来自干扰与数据摊薄,较好也可能因为总交互增加。应并列两类预算对照。
元学习还要给适应阶段独立记账。ML1留出的是同任务目标配置,ML10/ML45留出的是操作类别;给一个任务标识与让策略从交互猜任务也不是同一信息预算。论文正式协议中的这些区别,比简单的“任务数更多所以更难”更能解释结果。原文评估协议
帮助建立理解
自构例子,未运行:开门和拉抽屉都需要接近把手,但接触后一个沿圆弧、一个沿直线。如果共享策略把两者平均成斜向动作,单任务网络各自表现很好,共享网络却失败。这可能是表示或优化干扰。
另一种失败是策略根本不知道目标是哪一个,需要通过奖励探索辨认。前一种问题即使提供任务ID仍会出现;后一种问题可能因提供任务ID消失。设计这组对照能帮助区分共享控制失败与任务推断失败。
三、分开运行联合训练与未见任务适应
任务留出和回合留出是两道不同隔离:某个开抽屉任务即使在训练时未出现,适应阶段允许的交互也不能与最终计分回合混成同一批。教学上可给每条轨迹标记“元训练、测试适应、测试计分”;检查点、适应步数和超参数若依据最后一类反复挑选,报告的就不再是预先规定适应预算下的独立测试。
固定版本、任务集合、观察及动作定义
先分别训练单任务基线,检查任务是否可解

多任务实验:
    采样训练任务,提供任务编码
    收集交互,更新共享策略
    逐任务评估成功率,统计联合表现

元学习实验:
    采样元训练任务
    收集适应数据,执行适应过程
    用适应后的表现更新共享先验或适应机制
    对留出任务:
        仅提供规定交互预算
        适应后在评估回合统计成功率
四、先看单任务参照再读MT与ML结果
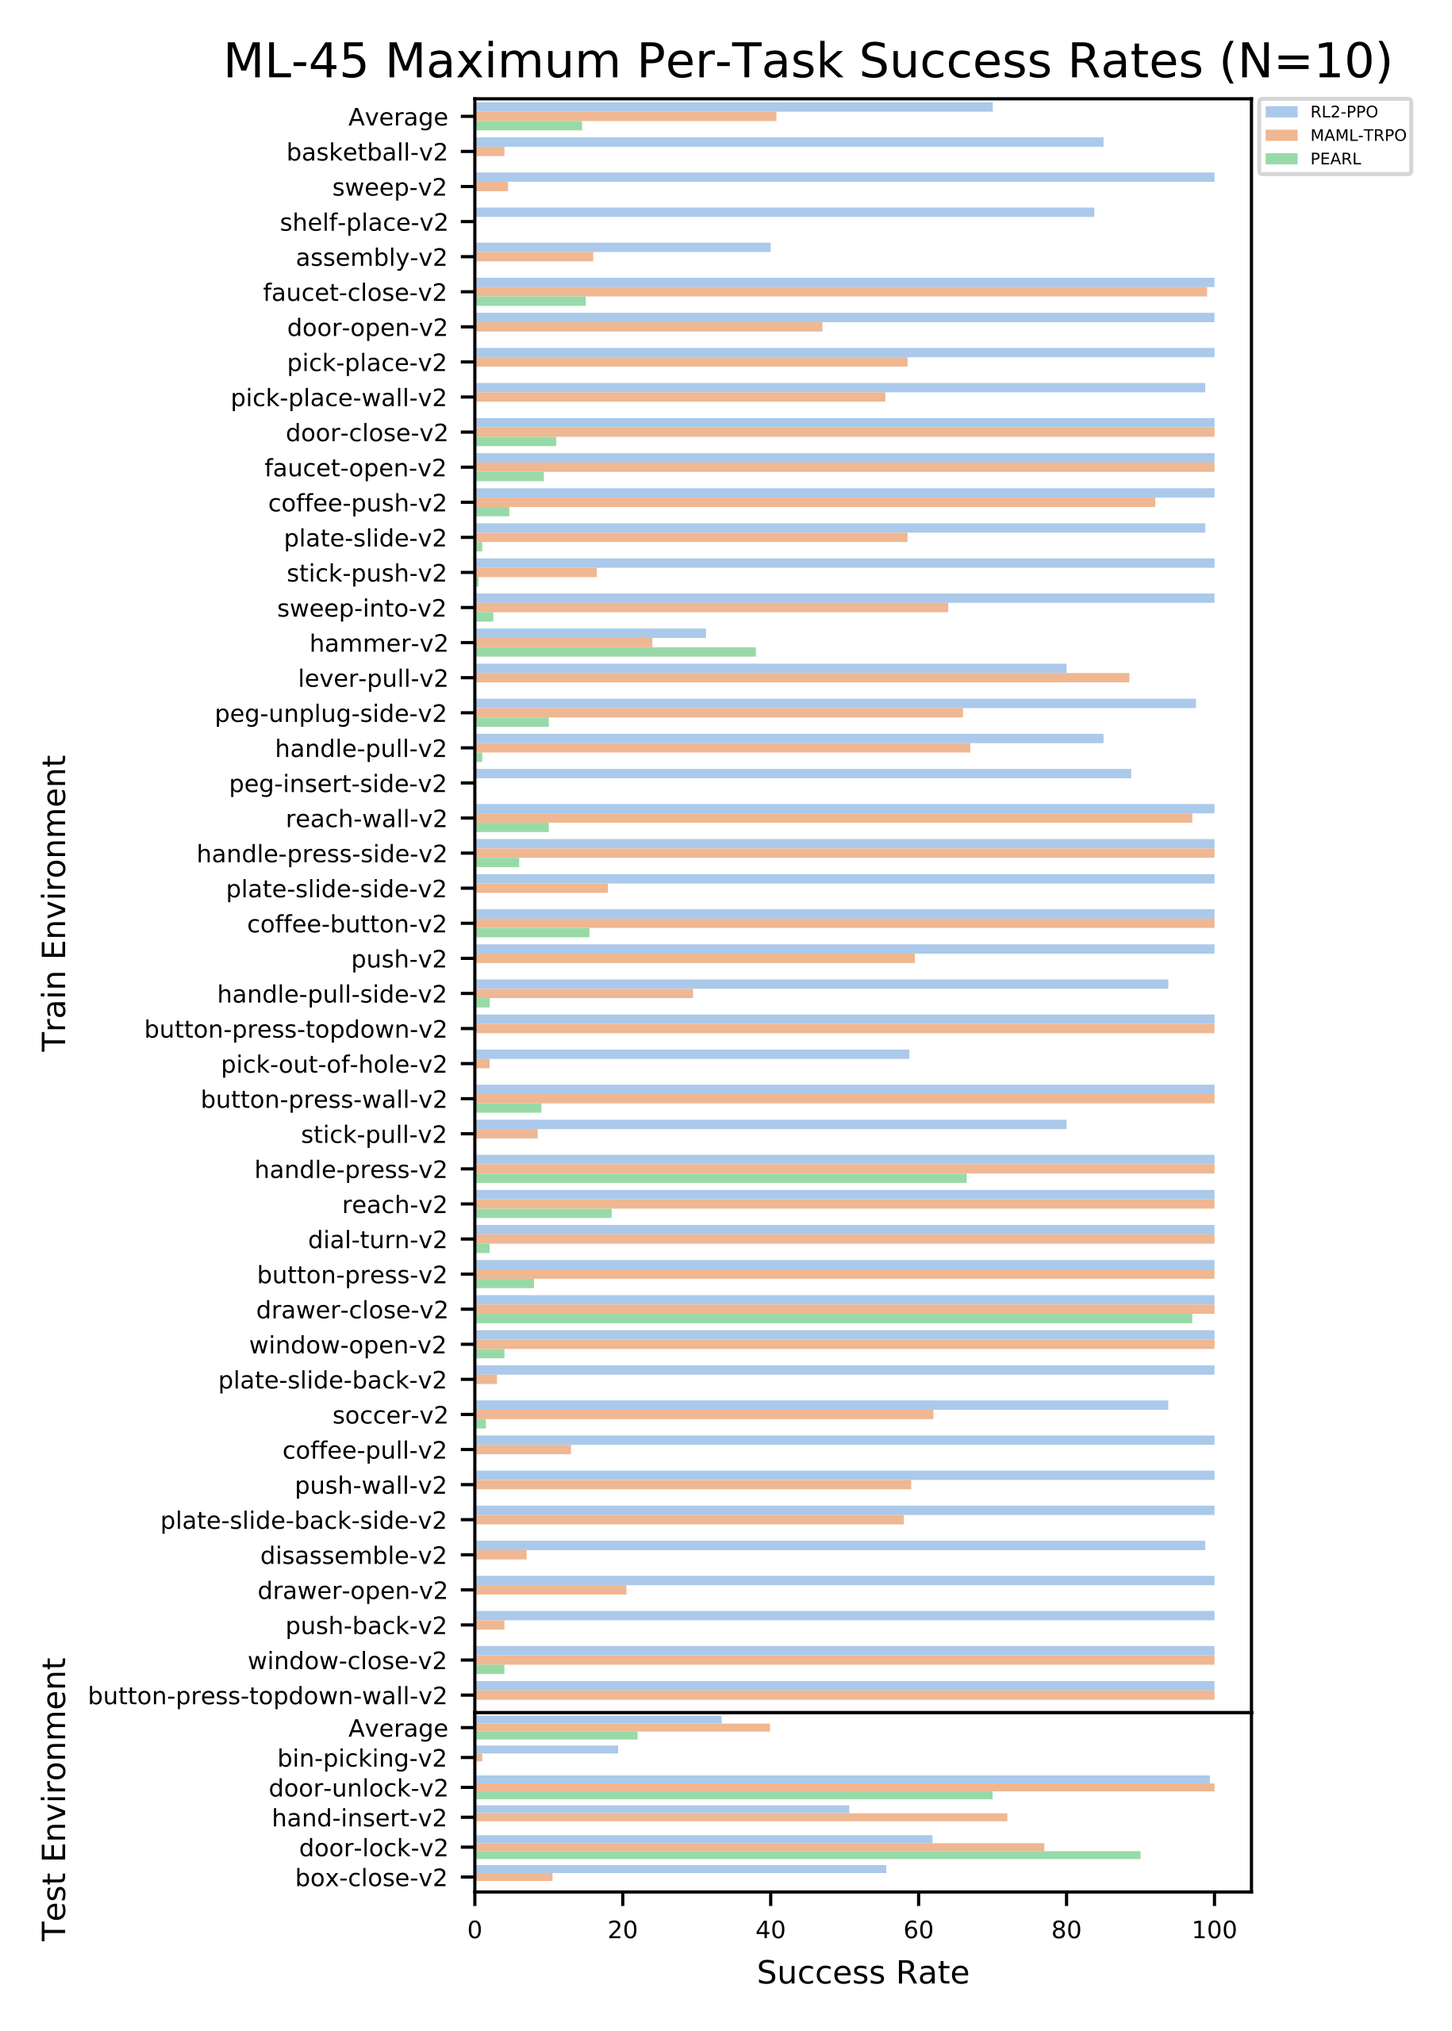
原图怎么读: 图8,原论文图注与图像。图中是ML45的最大成功率汇总,应分开元训练与元测试。训练任务也没学好时,不能把测试差距全部归因于新任务适应。
| 项目 | 论文实际检查 |
|---|---|
| 平台与数据 | MuJoCo 操作任务,算法在线收集状态—动作—奖励 |
| 单任务校验 | 单独学习各任务,避免用不可解任务制造“泛化失败” |
| 多任务基线 | MT-PPO、MT-TRPO、MT-SAC、任务嵌入方法 |
| 元学习基线 | MAML、RL²、PEARL |
| 评价 | 任务成功率,同时区分元训练与元测试 |
| 重复 | 主要比较报告十个种子 |
| 预算 | 各算法配置见附录D;不能只按一次更新比较成本 |
算法采用 on-policy 或 off-policy 数据机制,交互复用能力不同。阅读曲线应确认横轴是总体环境步数还是每任务步数;增加任务数时,如果总预算不同比例扩展,每个任务实际拿到的数据可能更少。
适应预算也需计入。新任务收集若干回合不是“零样本泛化”,测试后选择最好结果也不是固定检查点的最终成功率。论文表1采用平均最大成功率,解释时要保留这个选择口径。
结果:哪里是扎实证据,哪里需要谨慎
以下依据原文第5节、表1及附录。
- 附录B,单任务验证:显示独立学习能够解决任务,排除一部分“任务根本不可学”的解释;不能证明共享训练同样容易。
- 表1,多任务比较:MT-SAC 的 MT10 为 68.3%,MT50 为 38.5%。这支持扩大任务集合仍有困难,但不能只据两个数把差距全部归因于梯度冲突。
- 表1,元训练—测试对照:RL² 在 ML10 的元训练与元测试表现差距明显,支持适应到留出任务仍有障碍;训练能力强不自动带来测试能力。
- 图4,ML1:连同类任务目标变化也仍有改进空间,提醒不能把较窄设定视作已经完全解决。
- 图8及附录曲线:展示困难模式下的训练行为;最高点统计应结合整段曲线,而非只比较一个峰值。
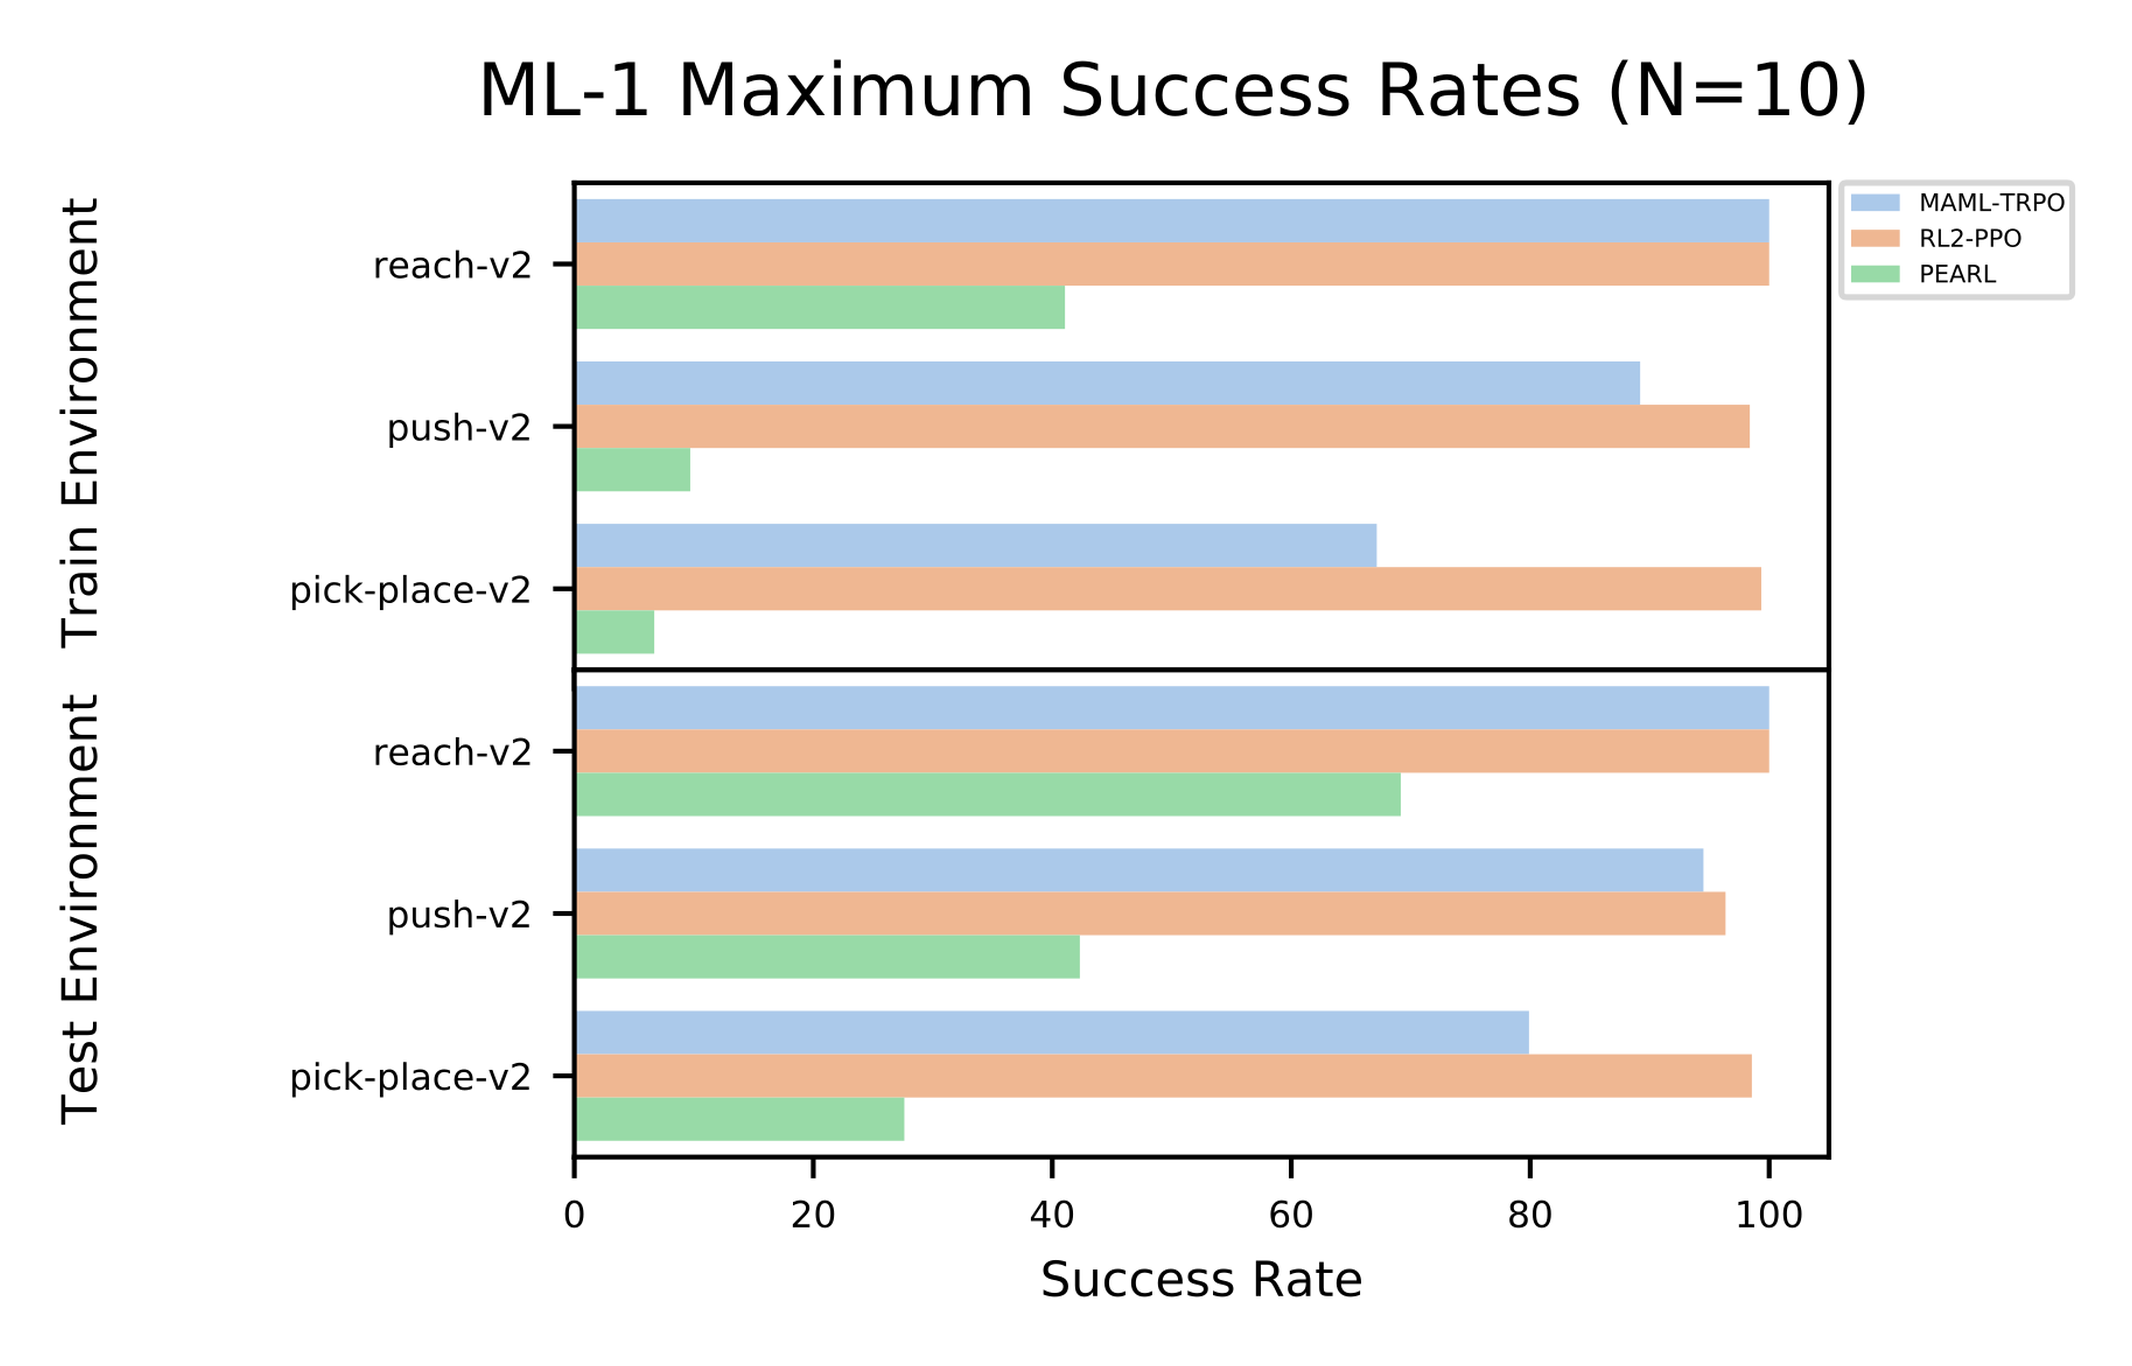
v2 正文和部分图表说明中存在赢家叙述与表1数值不完全一致的情况。例如表内 MT50 的 SAC 数值高于 PPO,但附近文字有相反措辞。本文以明确数值作局部比较,保留版本口径疑点,不扩大成整个实验无效。
这些结果最有价值的地方是拆开两个瓶颈:把许多训练任务学好,以及把所得结构用于新任务。若第一步已经明显不足,直接宣称“元学习不能泛化”会把优化困难和泛化困难混成一个结论。
五、奖励、任务信息和留出因素影响比较
限制首先是感知被简化。机器人直接获得物体状态,与从遮挡图像中估计状态不同。其次是密集奖励包含工程知识;换成真实任务只有成败反馈时,探索会更困难。作者将视觉、稀疏奖励、长序列和少重置等列为扩展方向。
本文分析还包括:同一工作空间可能留下任务识别捷径。随机位置有助于减少某些捷径,但任务形状或状态槽位仍可能携带线索。对元学习而言,识别任务不等于学会操作,却会影响适应难度。
六、沿机制关系继续读
与RLBench是平行基准;与模型元适应有教学联系:Meta-World的任务改变主要涉及目标/操作,前者适应动力学变化。二者都叫元学习,却不应把留出因素混成一个泛化指标。
七、自测三题与参考答案
问题1:MT50 分数高,能否证明模型能快速学习第五十一个任务?
答:不能。MT50 衡量已训练任务的联合表现,通常还提供任务信息。未见任务适应需要留出任务和明确交互预算,是 ML 类协议要检验的内容。
问题2:为什么需要先做单任务验证?
答:如果某任务本身在给定接口和奖励下就难以学会,共享算法失败不能直接归因于多任务或元学习。单任务基线提供必要参照,但仍要注意数据与计算预算。
问题3:元测试表现差,应先看什么才能避免错误归因?
答:先看元训练是否学好,再看适应预算、任务信息和测试分布。训练表现也低时可能主要是优化与探索不足;训练高而测试低才更直接提示迁移或任务推断的障碍。