093|π0.5:开放环境中的任务与动作泛化
原论文:pi0.5: a Vision-Language-Action Model with Open-World Generalization,Physical Intelligence,2025。论文。
先接住前作的问题
π0把语义知识接到连续动作,但陌生家庭长任务还要不断决定当前该做什么。π0.5增加语义子任务与异构监督,把高层选择和动作生成接到共享模型;场景泛化、任务泛化与层级接口要分别检验。
五个前置概念
五个前置概念:
- 层级策略:高层选择子目标,低层产生控制动作。
- 共同训练:不同监督任务共享参数,以迁移有用表示。
- 动作分块:一次预测多步动作,减少频繁模型调用。
- 注意力掩码:规定哪些输入可互相读取,防止答案泄漏。
- 分布外泛化:在训练未覆盖的对象、场景或任务变化下测试,三者须分别说明。
一、问题设定:陌生家庭中怎样持续选择子任务并执行
给机器人一条“把餐具收进水槽”的指令,难点不只是抓起盘子。机器人还要在陌生厨房辨认水槽、选择当前对象、协调底盘和手臂,并在放下后继续寻找下一件。π0.5 把这个问题拆成共享模型的两次推断:先根据整体目标与画面预测语义子任务,再根据该子任务生成连续动作。
这是离线模仿学习的移动操作系统,不是在线通过奖励发现清洁策略。观测包含多路 RGB 和本体状态,动作同时覆盖双臂、夹爪、升降机构和底盘速度。底层 PD 控制器跟踪目标,动作块使低频模型调用能够供应高频控制命令。
文章包含两种重要测试。第一种是任务不变但房屋、背景、家具布局及物体实例改变;第二种是语言指定训练中未出现类别的对象。它们比固定桌面测试更接近实际使用,但都不同于“从未学过的新任务”。例如,把新形状的勺子放进水槽,不能直接证明会维修洗碗机。
基本设定仍有隐含边界:机器人需要能看见与触及对象,硬件要能打开相应机构,训练中要包含足够相关的动作技能。语言知识可以帮助识别抽屉,却不能替代机械抓握力,也不能从静止画面唯一恢复遮挡后的任务状态。
§VI 明确讨论陌生把手、难打开的柜门、被手臂遮住的污渍,以及重复开关抽屉等失败。理解这些限制,比把演示概括为“会做家务”更有研究价值。
二、联合语义子任务与连续动作条件生成
它继承 π0 的动作专家,并吸收 FAST 的离散动作训练。更重要的变化是训练配方:不同身体的操作、不同家庭的静态手臂数据、网页视觉语言任务、人工子任务标注,以及人在机器人实际运行时给出的语言示范。模型尝试把这些不同层次的经验连接起来。
1. 同一个模型,两个条件分布
设整体指令为 ,当前观测为 ,语义子任务为 ,动作块为 。论文采用
右边第二项回答“现在做哪一步”;第一项回答“如何做这一步”。低层只以子任务为语言条件,因此高层必须保留当前执行需要的语义。这个分解降低了动作模型直接从宏观目标推断细节的负担,却也引入信息瓶颈:若高层遗漏“不要碰玻璃杯”,低层未必能恢复约束。
两项由同一套模型表示,但高层调用频率低于动作调用。共享权重不意味着两项同时完成一次前向,也不意味着具备长期规划搜索。这里是基于当前观测的子任务预测与动作生成。(§IV-A)
2. 先用 FAST 学,再加入连续动作专家
预训练把动作压缩为离散 FAST token,与问答、定位、子任务文字一起做交叉熵学习。后训练加入随机初始化的连续动作专家,使部署不必逐 token 解码整段高维动作。文字能力和连续动作能力共同训练:
约束文字与离散动作预测,约束带噪动作的生成速度场,控制两种监督的权重。它们都是代理损失,最终改善的是任务进度和语言目标选择,损失下降本身不保证任务成功。
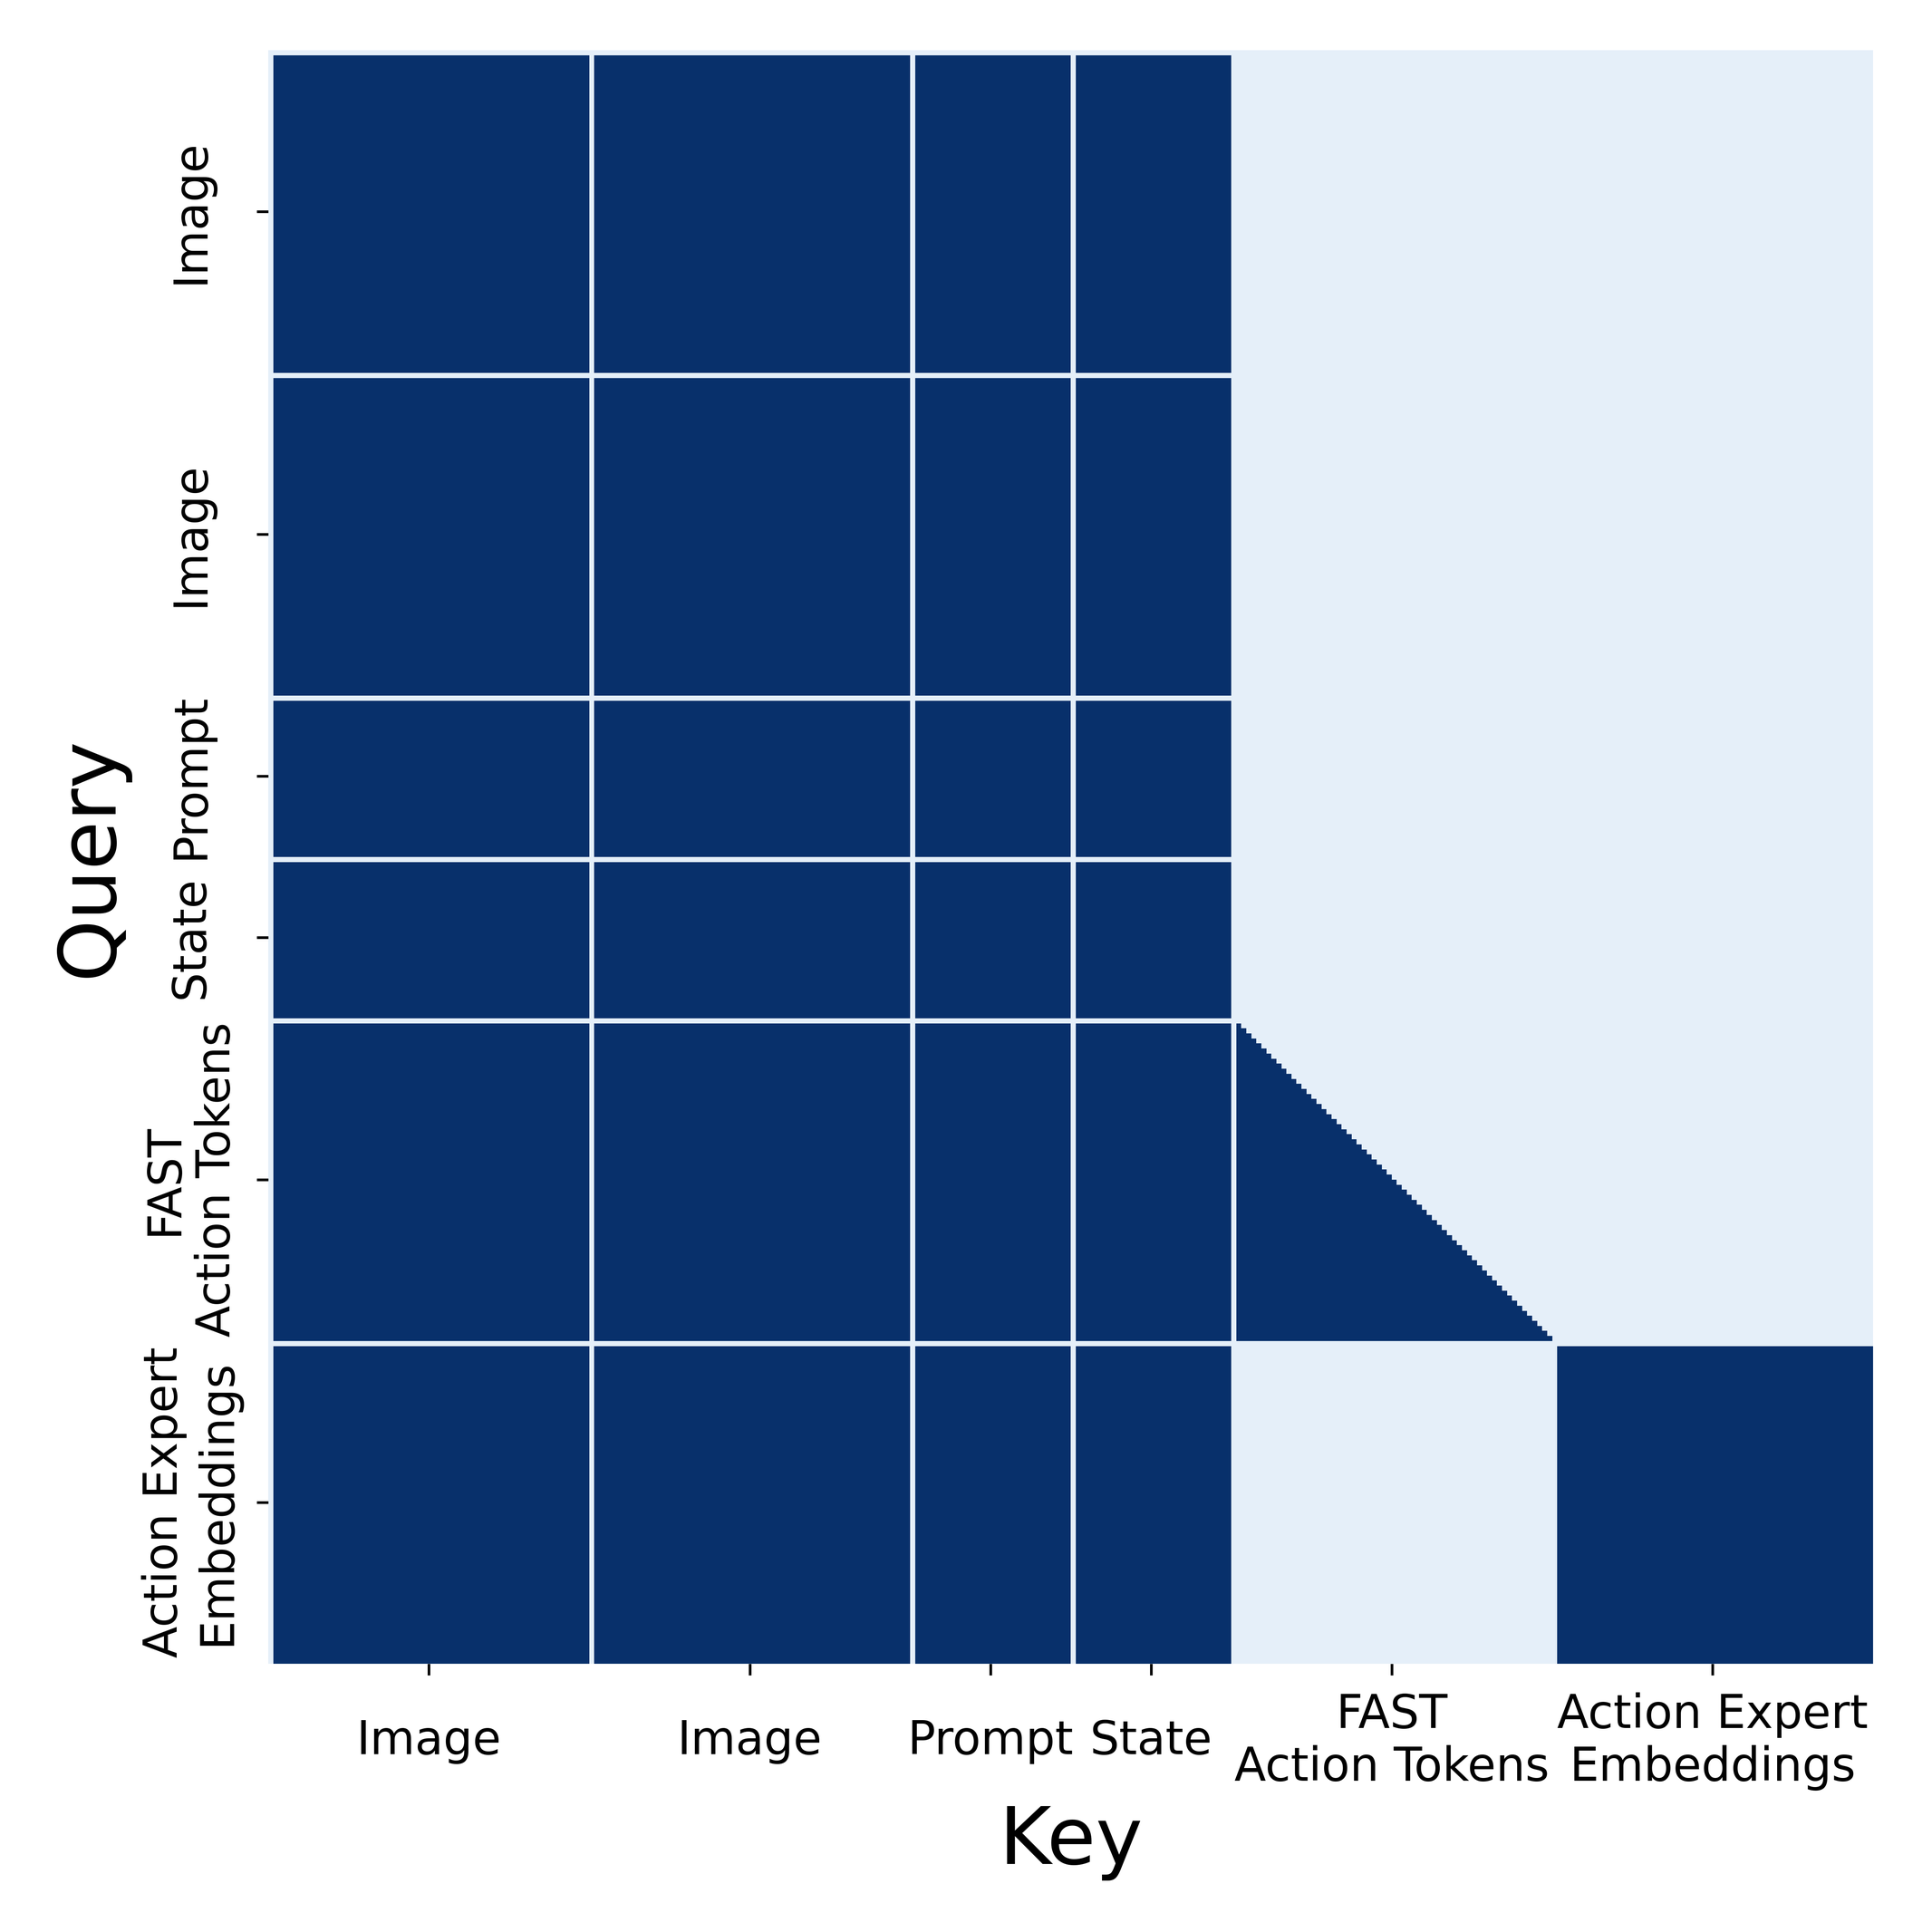
为了避免复制答案,连续动作 token 不能注意到同一样本的 FAST 动作 token;视觉语言前缀也不从动作专家读取信息。否则模型可能训练时从另一种表示直接读出动作,部署却失去该信息。注意力掩码是保证训练任务有效的重要机制。(附录A-E、图18)
流匹配的噪声路径与速度符号需要成套使用。用教学约定 ,目标应为 ,从0向1积分。原文§IV-B的插值与写出的反向速度存在方向疑问,复现时应对照具体实现;不要只抄损失中的负号。
3. 语言示范为什么不是普通文本标注
离线标注告诉模型专家原来在做哪一步;语言示范则让人观察当前低层策略实际造成的局面,选择下一条可执行指令。因此高层学到的并非抽象最优计划,而是适应该低层能力的决策。这与交互式模仿的思想相通,但论文并不把它写成完整 DAgger 理论保证。
网页数据提供对象、语义与视觉定位能力;跨形态动作数据提供操控先验;目标机器人家庭数据负责最终身体与环境对齐。任何一部分的作用都不能简单用“数据更多”解释,必须看消融在什么评估上有效。
伪代码强调逻辑关系,不指定原文未明确给出的高层更新周期或动作执行截断策略。
高层子任务应是低层足够使用的信息,而不能只是一句简短动词。教学设同样画面下,整体要求分别为“倒到半杯”和“倒满”;若高层都压成“倒水”,低层只看当前画面与这条子指令,就无法知道应采用哪个停止阈值。共享参数也不能恢复已经从条件中删掉的区别。
因此层级泛化不仅考语言命名,还考约束是否保留、何时更新子任务、低层执行后是否重新观察。原文动作专家不能读取FAST答案的掩码则解决另一问题:防止训练时直接抄标签。语义瓶颈与答案泄漏是两条不同故障链,不能用同一个“更强推理”概括。原文§IV与附录A-E
教学例子与前置知识
下面是未运行的自构例子。机器人需要把四只盘子放入水槽。高层先给“拿起左边盘子”,低层抓起后,下一张图显示盘子仍在夹爪中,高层应给“放入水槽”,而不能因为盘子离开桌面就寻找下一只。
若四只盘子都曾被拿起但都掉在桌面旁,按“抓起加一、放入加一”的八分规则,仍可能得到四分。这个例子说明阶段指标能揭示动作进展,却会掩盖整体目的是否完成。任务定义和评分必须共同阅读。
三、先预测语义子任务,再条件生成连续动作
FAST提供离散动作学习接口,连续专家负责实际动作生成,训练与执行不必使用完全相同输出。语言示范还影响实际运行中高层决策的条件分布。
预训练:
    混合移动机器人、静态多环境、跨形态、子任务和网页样本
    把有动作样本转成 FAST token
    训练统一模型预测文字、定位与离散动作

后训练:
    加入随机初始化的连续动作专家
    保留文字监督,加入流匹配监督
    使用目标相关的成功动作轨迹与高层语言示范
    用注意力掩码阻止两种动作答案相互泄漏

部署循环:
    高层需要更新时:
        根据多相机观测和整体目标预测当前子任务
    根据前方、腕部图像、本体状态与子任务生成动作块
    向低层控制器发送动作并重新获取观测
四、区分新环境、对象和任务的留出方式
作者的关键证据是:模型可以在未见家庭执行多阶段整理任务;移除跨形态数据明显降低任务表现,移除网页数据尤其影响新物体与高层决策。但“开放世界”不是无限任务覆盖,定量任务类型仍在训练中出现。(§V、附录A-B)
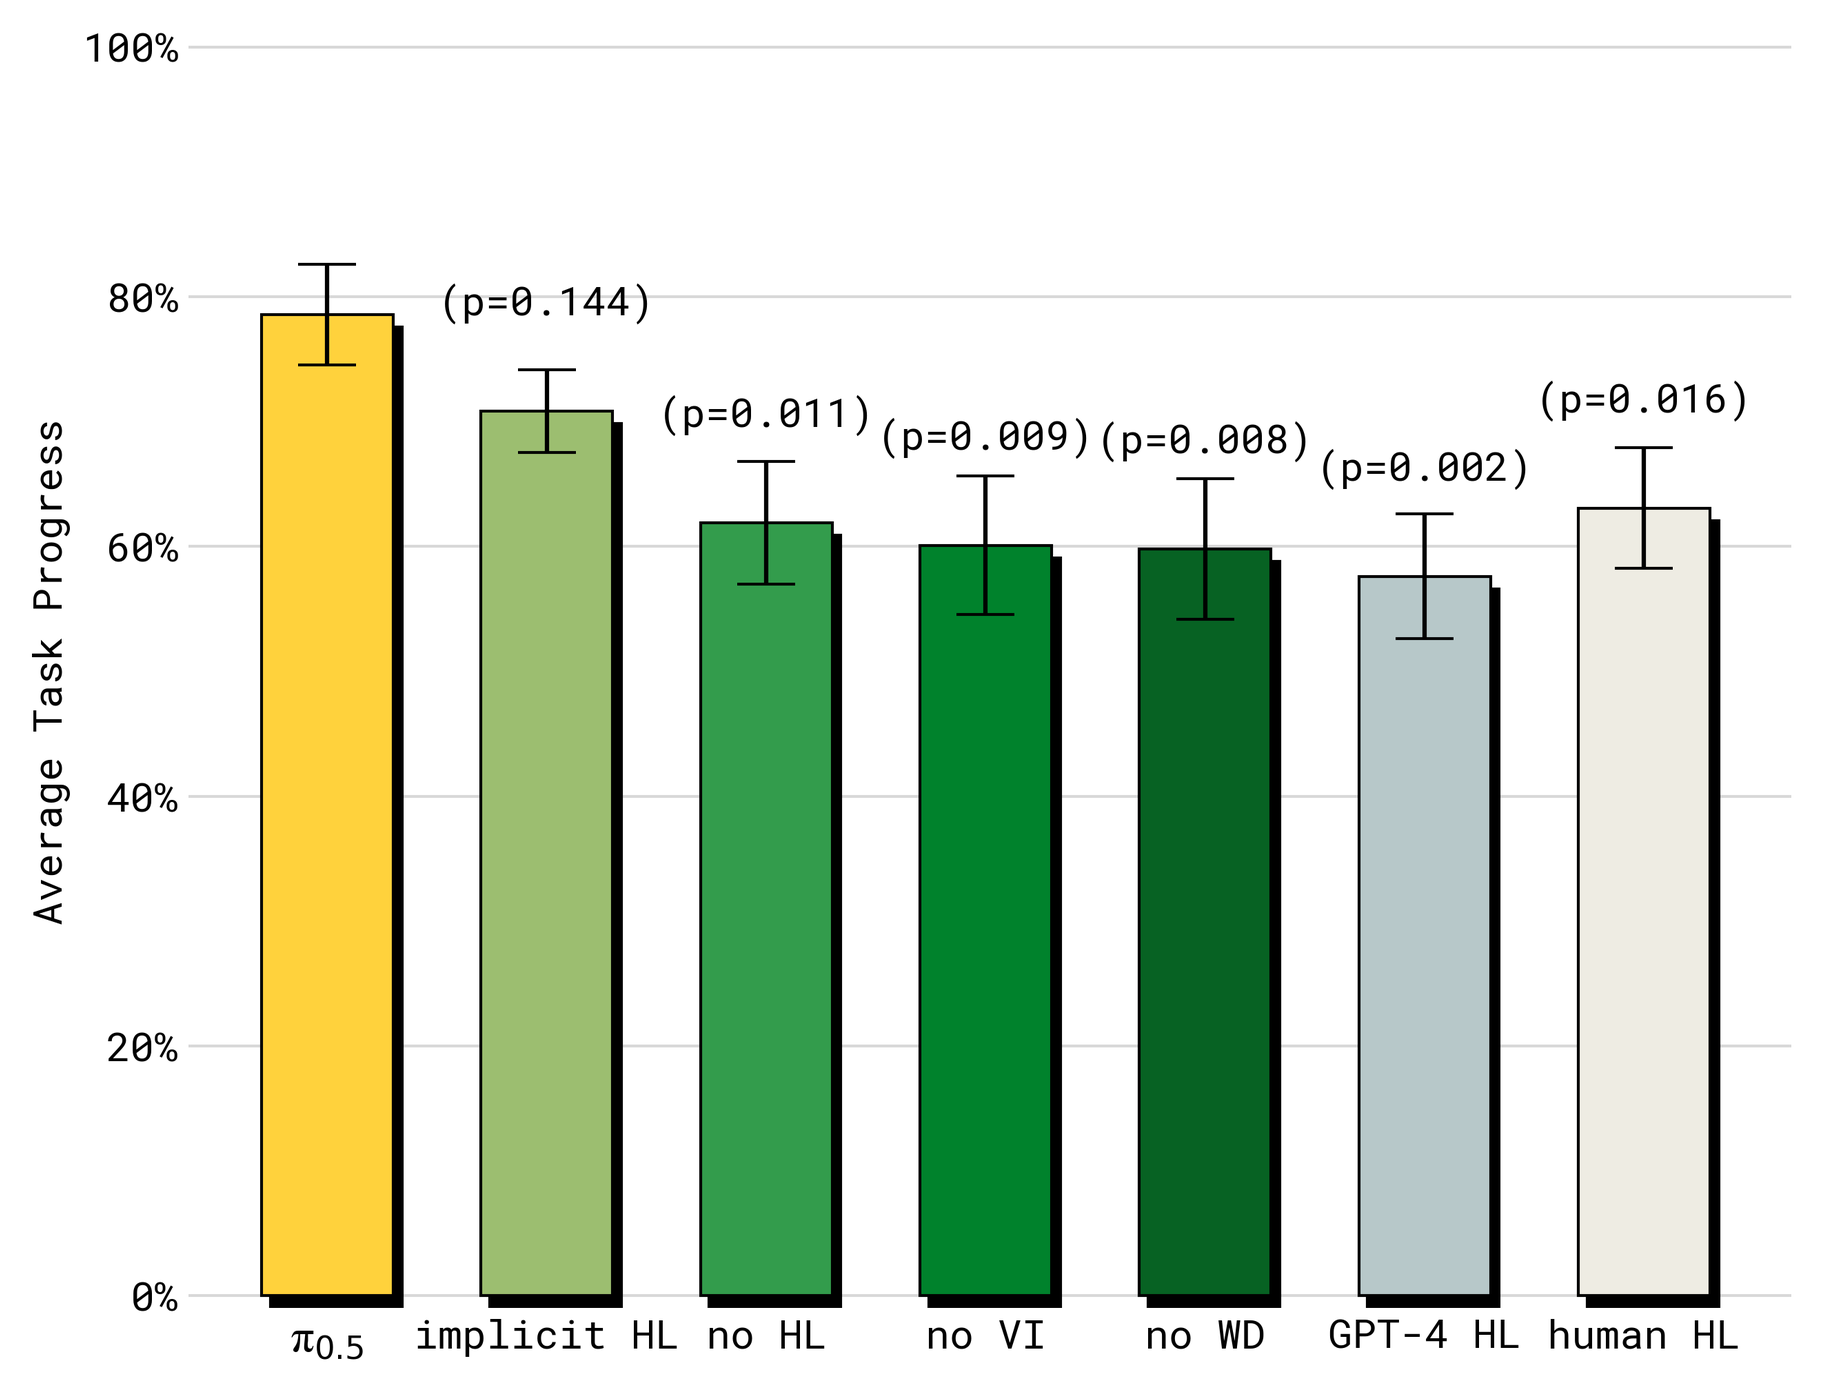
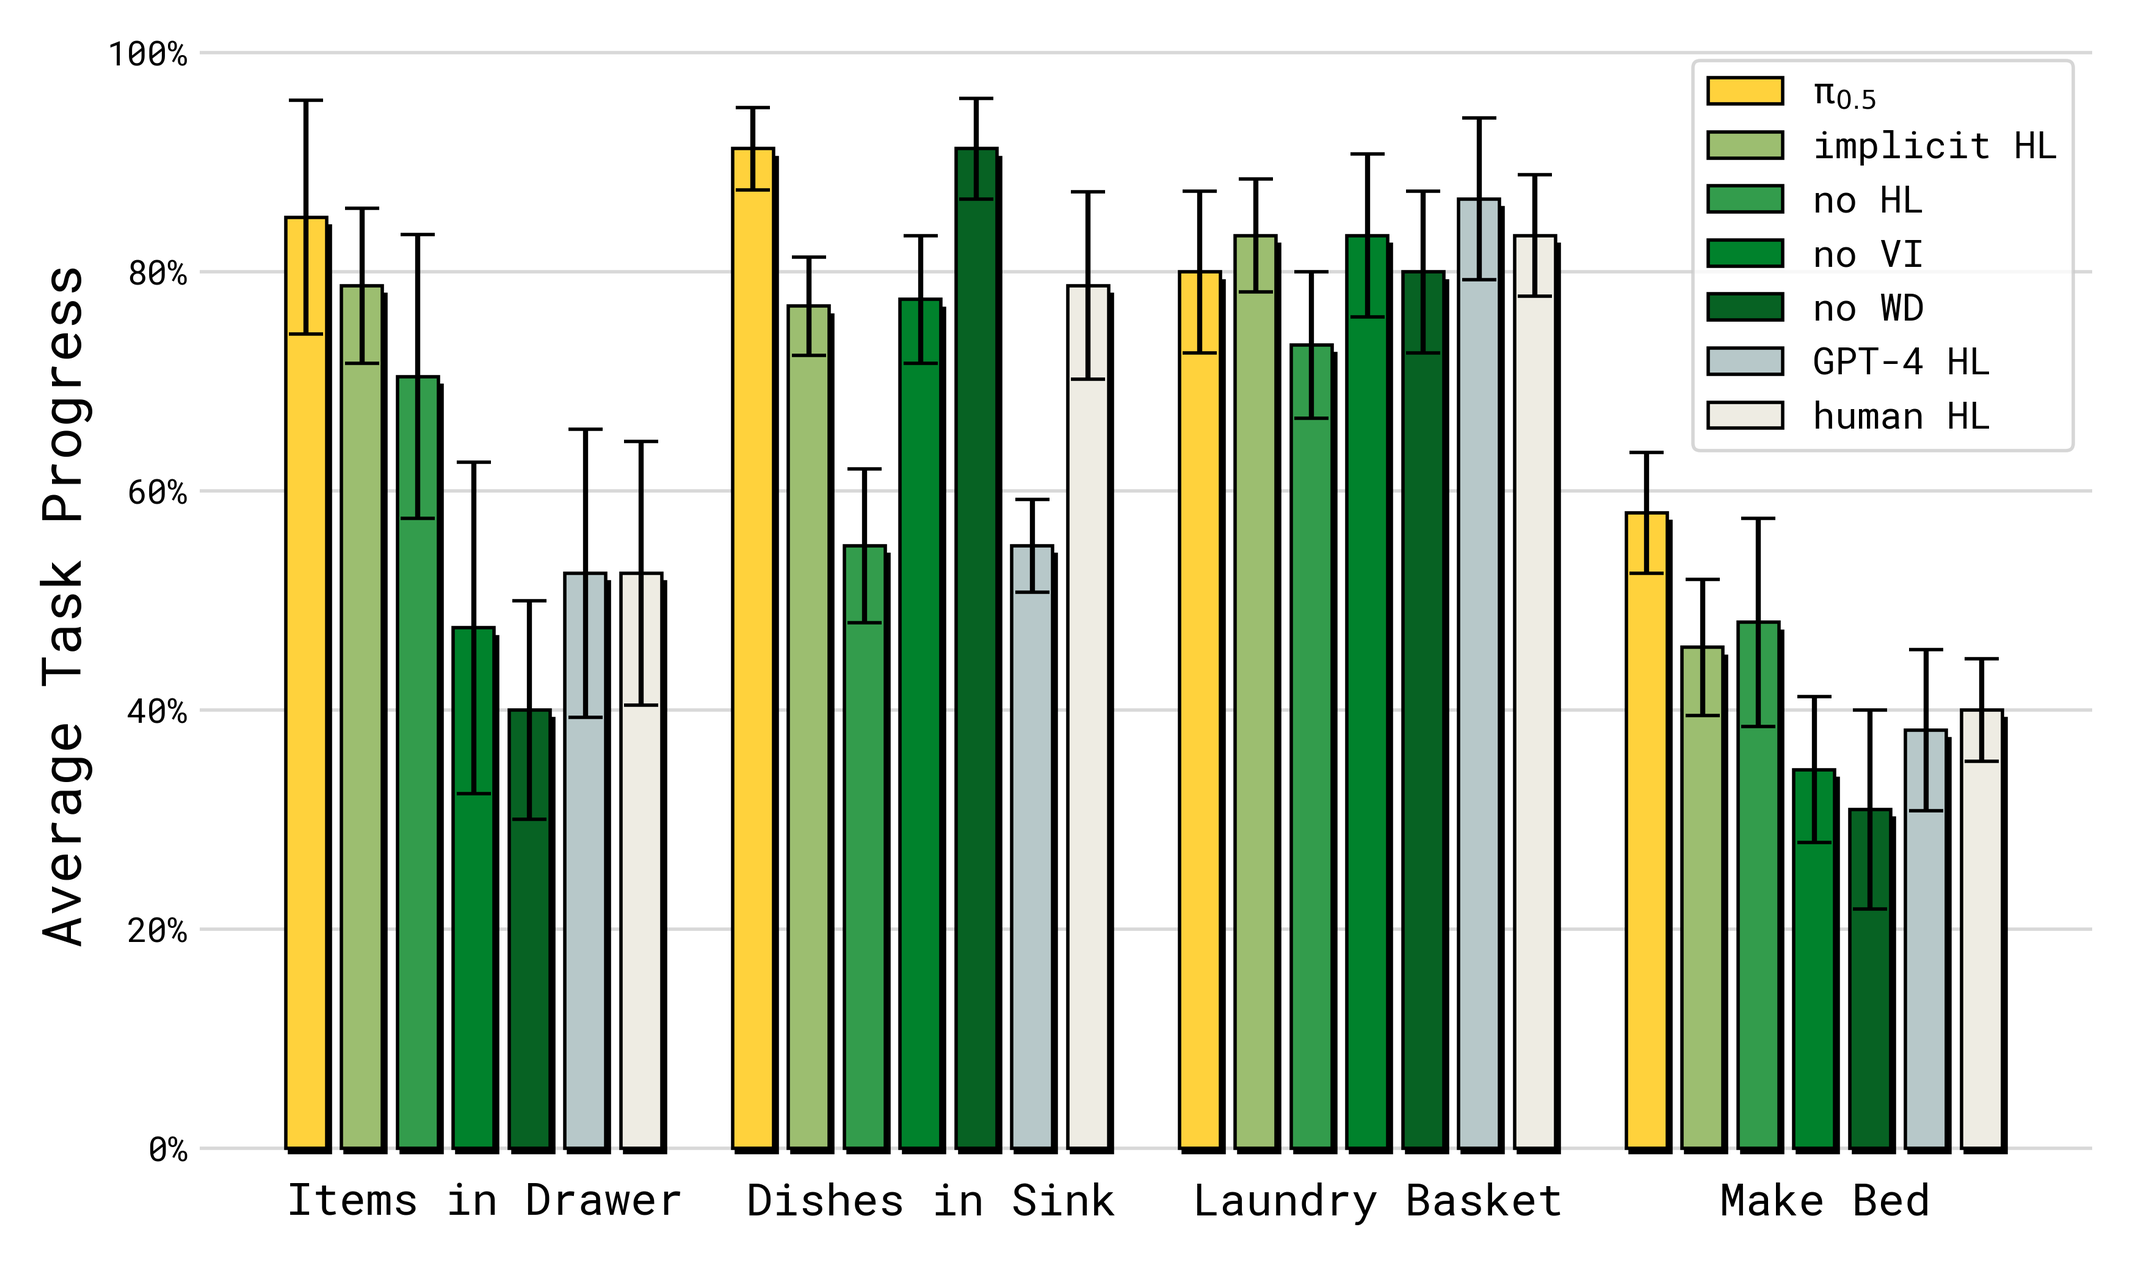
原图怎么读: 图13,原论文图注与图像。把完整高低层推理、只用低层但保留高层训练、去掉高层相关数据分开看。这样才能区分高层监督改善表示与部署时显式规划的贡献。
| 实验 | 变化与对照 | 指标/预算 | 回答的问题 |
|---|---|---|---|
| 未见真实家庭 | 三个真实家庭的厨房与卧室 | 分阶段进度,通常每任务10次 | 是否能离开训练家庭 |
| 场景数量 | 3、12、22、53、82、104个训练地点 | 简化训练配方,后训练40k步;控制抽样数量 | 环境覆盖是否独立于样本数起作用 |
| 数据组成 | 移除网页、静态多环境、实验室跨形态数据 | 受控模拟家庭任务与语言测试 | 哪类监督服务哪类能力 |
| VLA对比 | π0、FAST+Flow与完整模型 | 相同机器人数据、可比训练步数 | 联合配方的价值 |
| 高层替换 | 无高层、隐式高层、GPT-4、人类高层等 | 保持完整低层执行过程 | 显式子任务与高层训练分别贡献多少 |
基础移动操作数据约400小时;这不是模型的全部经验。主配方包含280k步离散预训练和80k步后训练,场景数量实验采用简化流程,不能把其曲线当成完整最终模型的精确缩放律。(§IV-C—D、V-B)
附录A-B说明任务进度按评分规则计算,并交错执行不同策略以降低环境变化影响;部分由于机器人故障、时间限制等取消的回合被移除。排除规则可能影响部署可靠性解释,因此完整系统评估还应把取消原因和次数作为单独指标保留。本文未逐项核实所有模型的训练种子、总 GPU 小时和每张图的原始数值。
五组证据:不要把一个“泛化”拆错
图7:真实家庭结果。 比较相似任务在新家庭的执行进度,支持跨环境转移。定量回合多为数分钟,介绍中的更长演示不能全部混成同一个统计样本。图中纵轴是任务进度,不能读成整回合二元成功率。
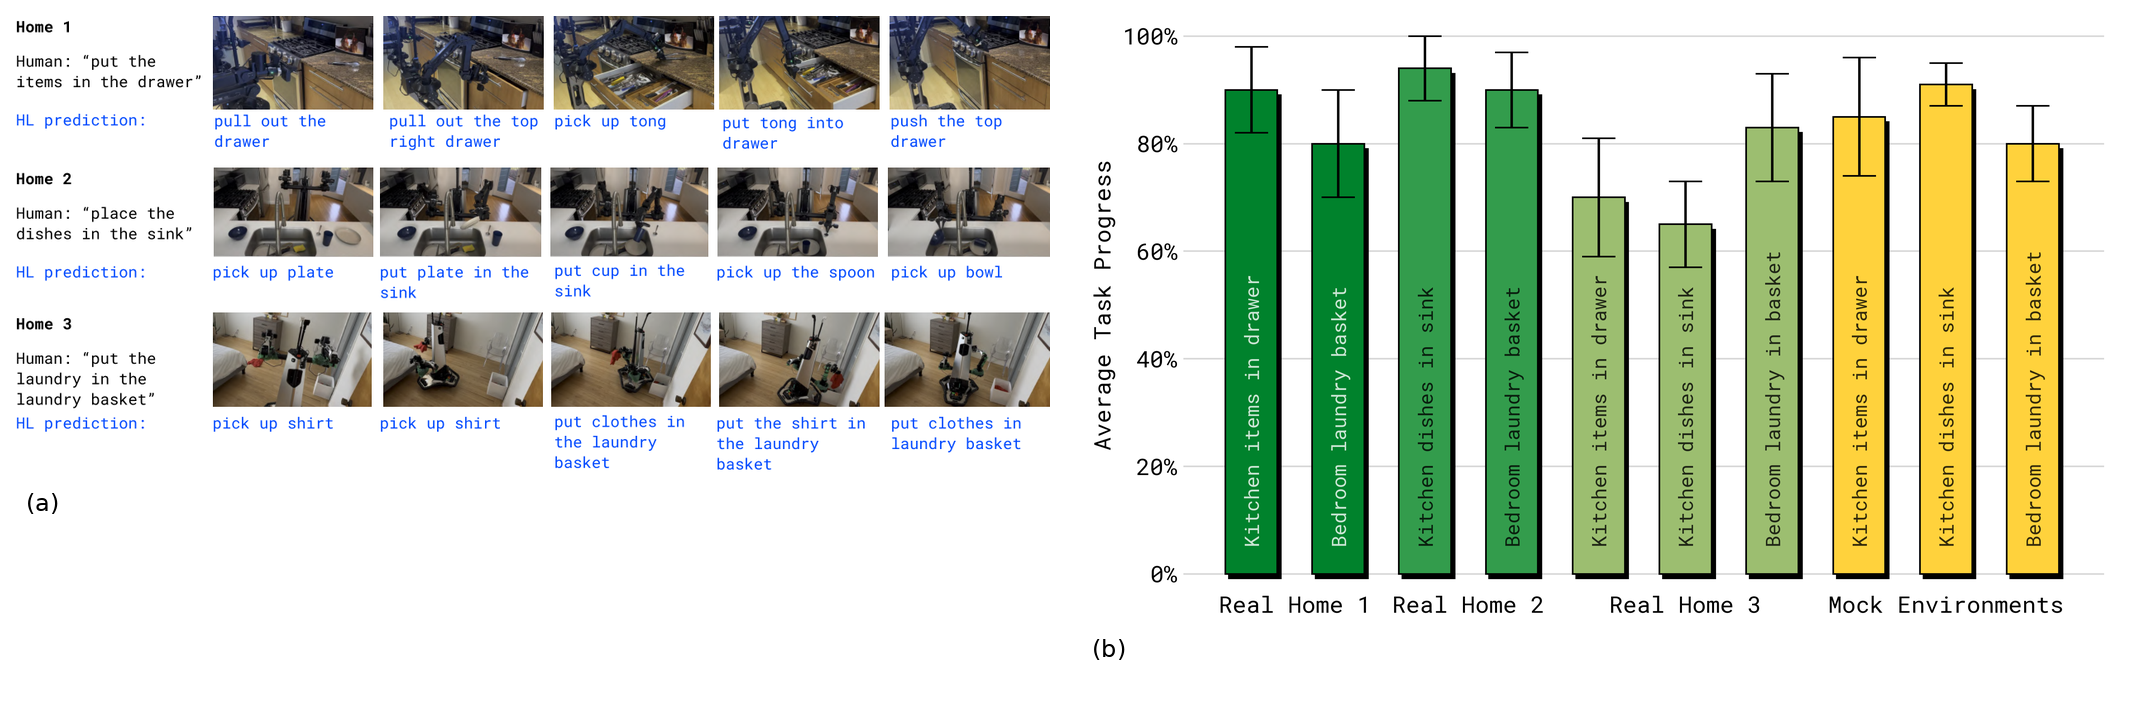
图8、图9:地点数量与语言跟随。 地点增加通常带来更好的新环境表现,且物体类别外泛化更困难。作者控制训练抽样数量,支持覆盖多样性的作用;但地点增加也带来对象、布局等同时变化,尚不能分离其中哪一个是根本因素。模型接近见过测试家庭的对照,也不等于对任意家庭不存在泛化差距。
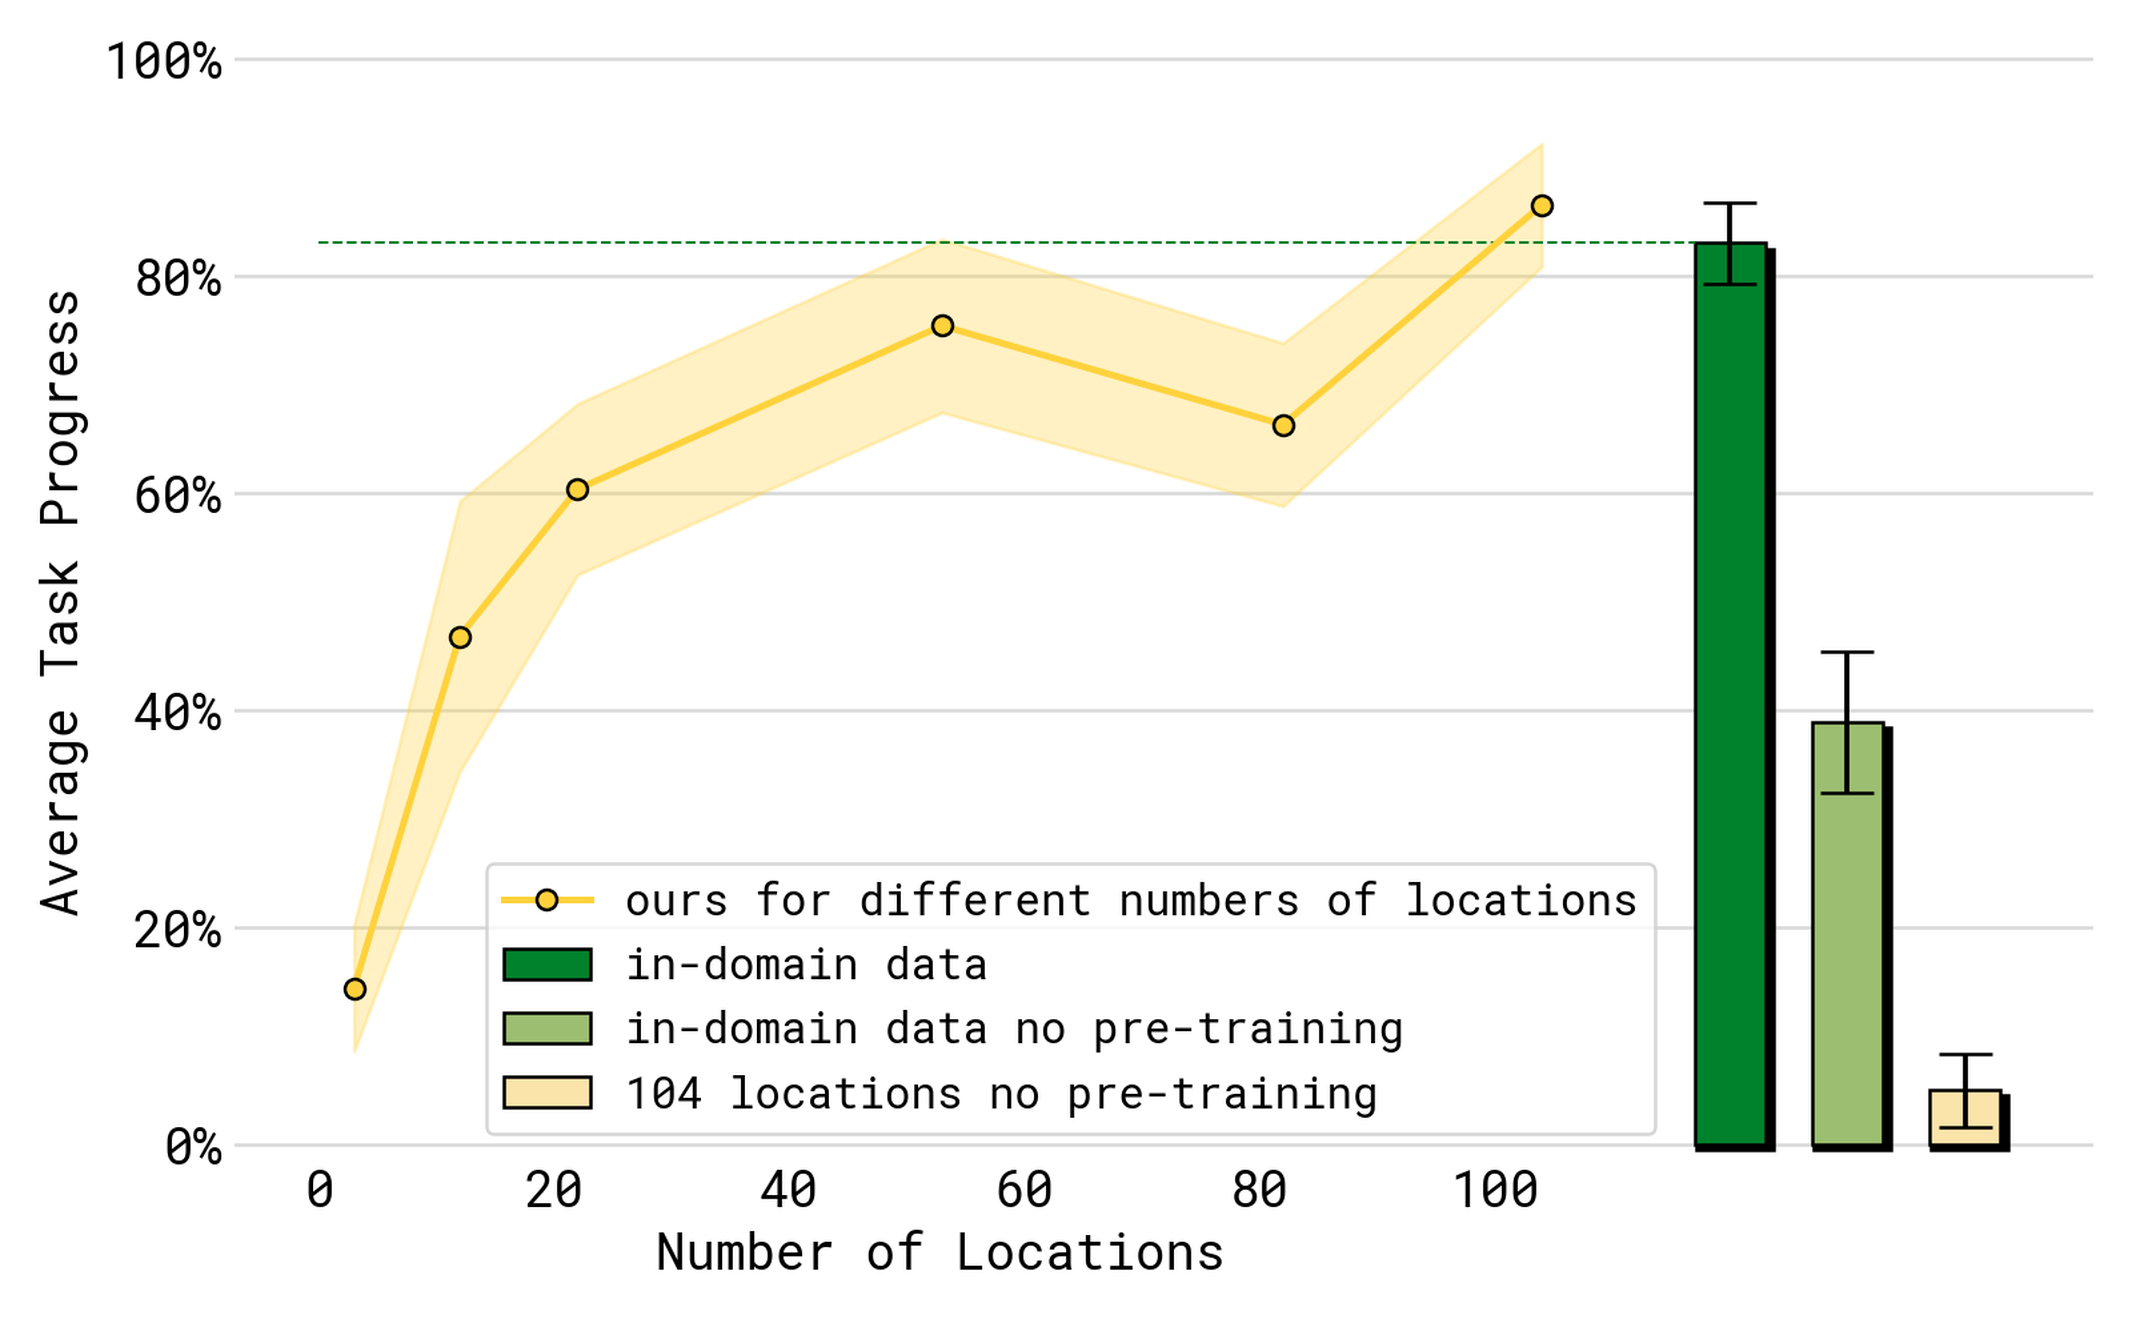
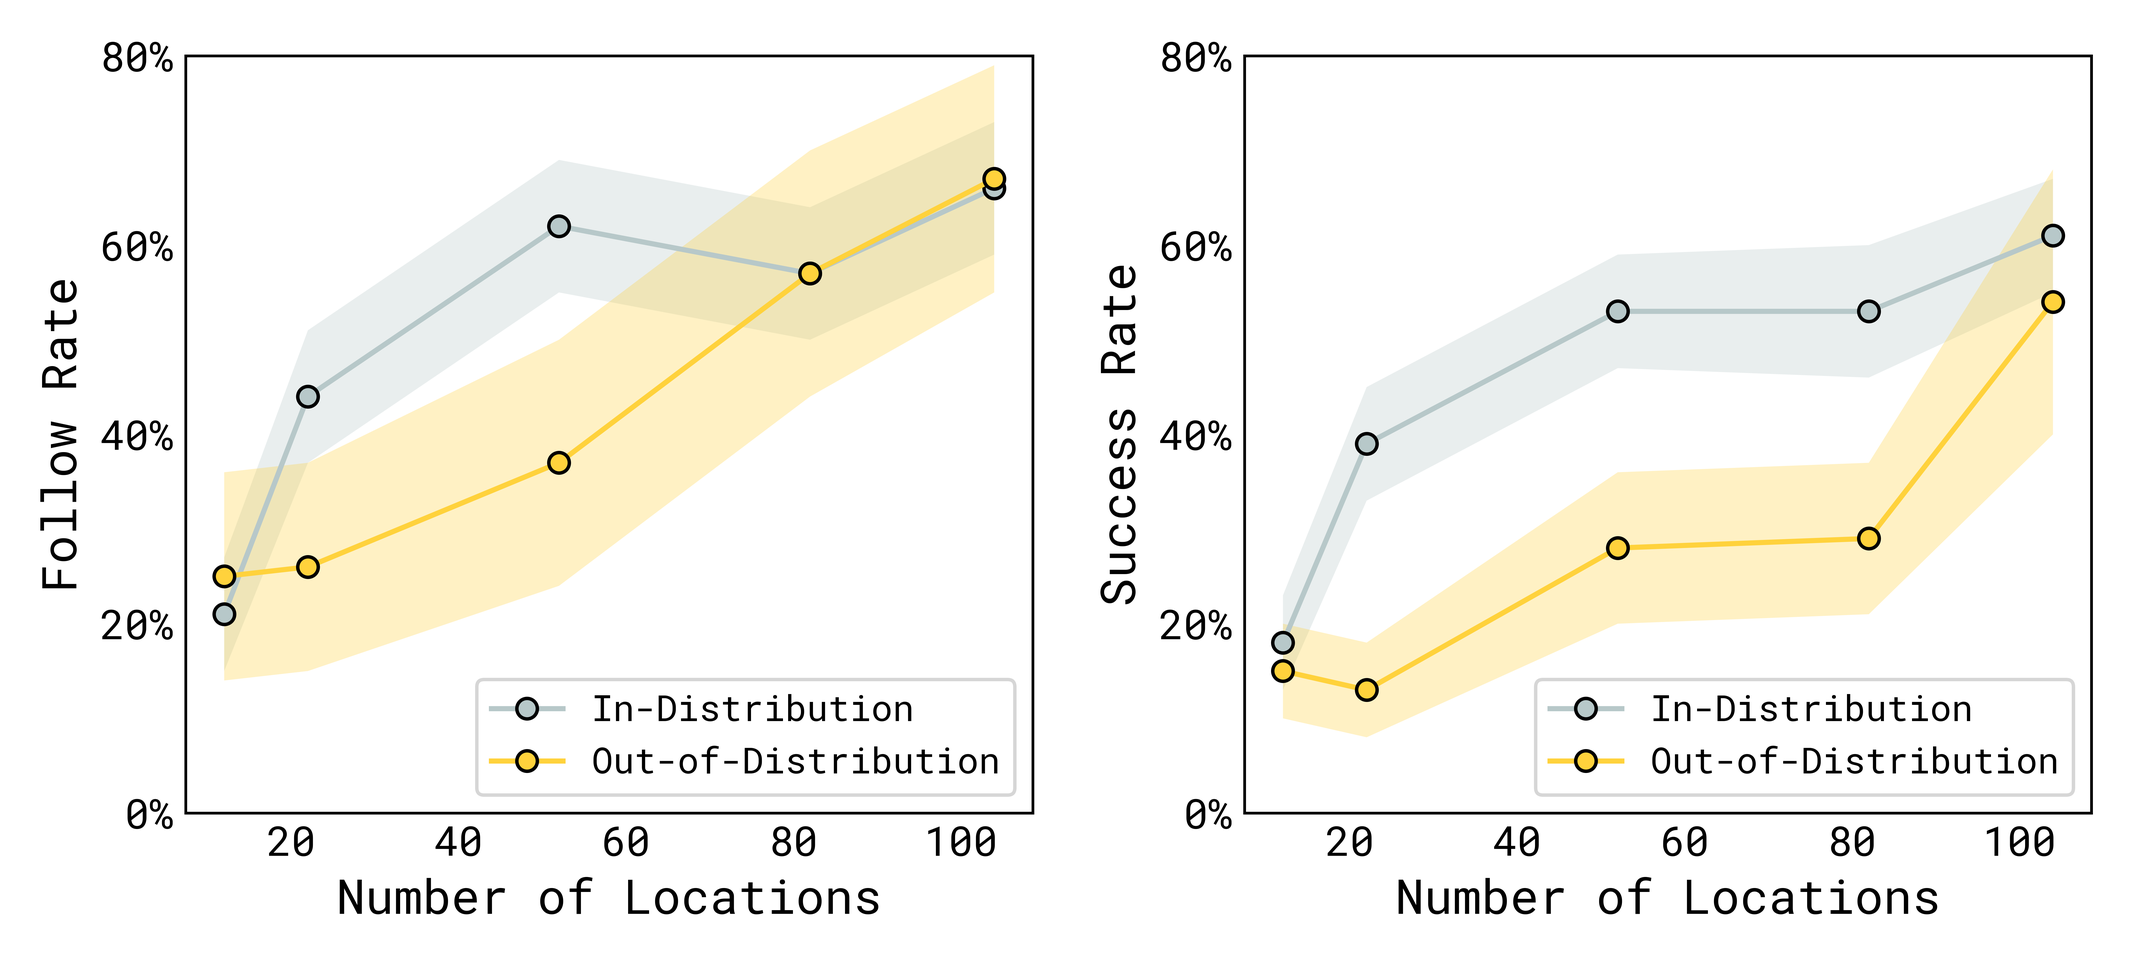
图10、图11:网页数据作用具有任务依赖性。 去掉网页数据,在整体模拟家庭任务上的差别不显著,但新类别对象的语言跟随下降。它支持“语义监督特别影响某些能力”,不支持网页数据对所有动作都必不可少。跨形态数据则在多种评估中带来更广泛收益。
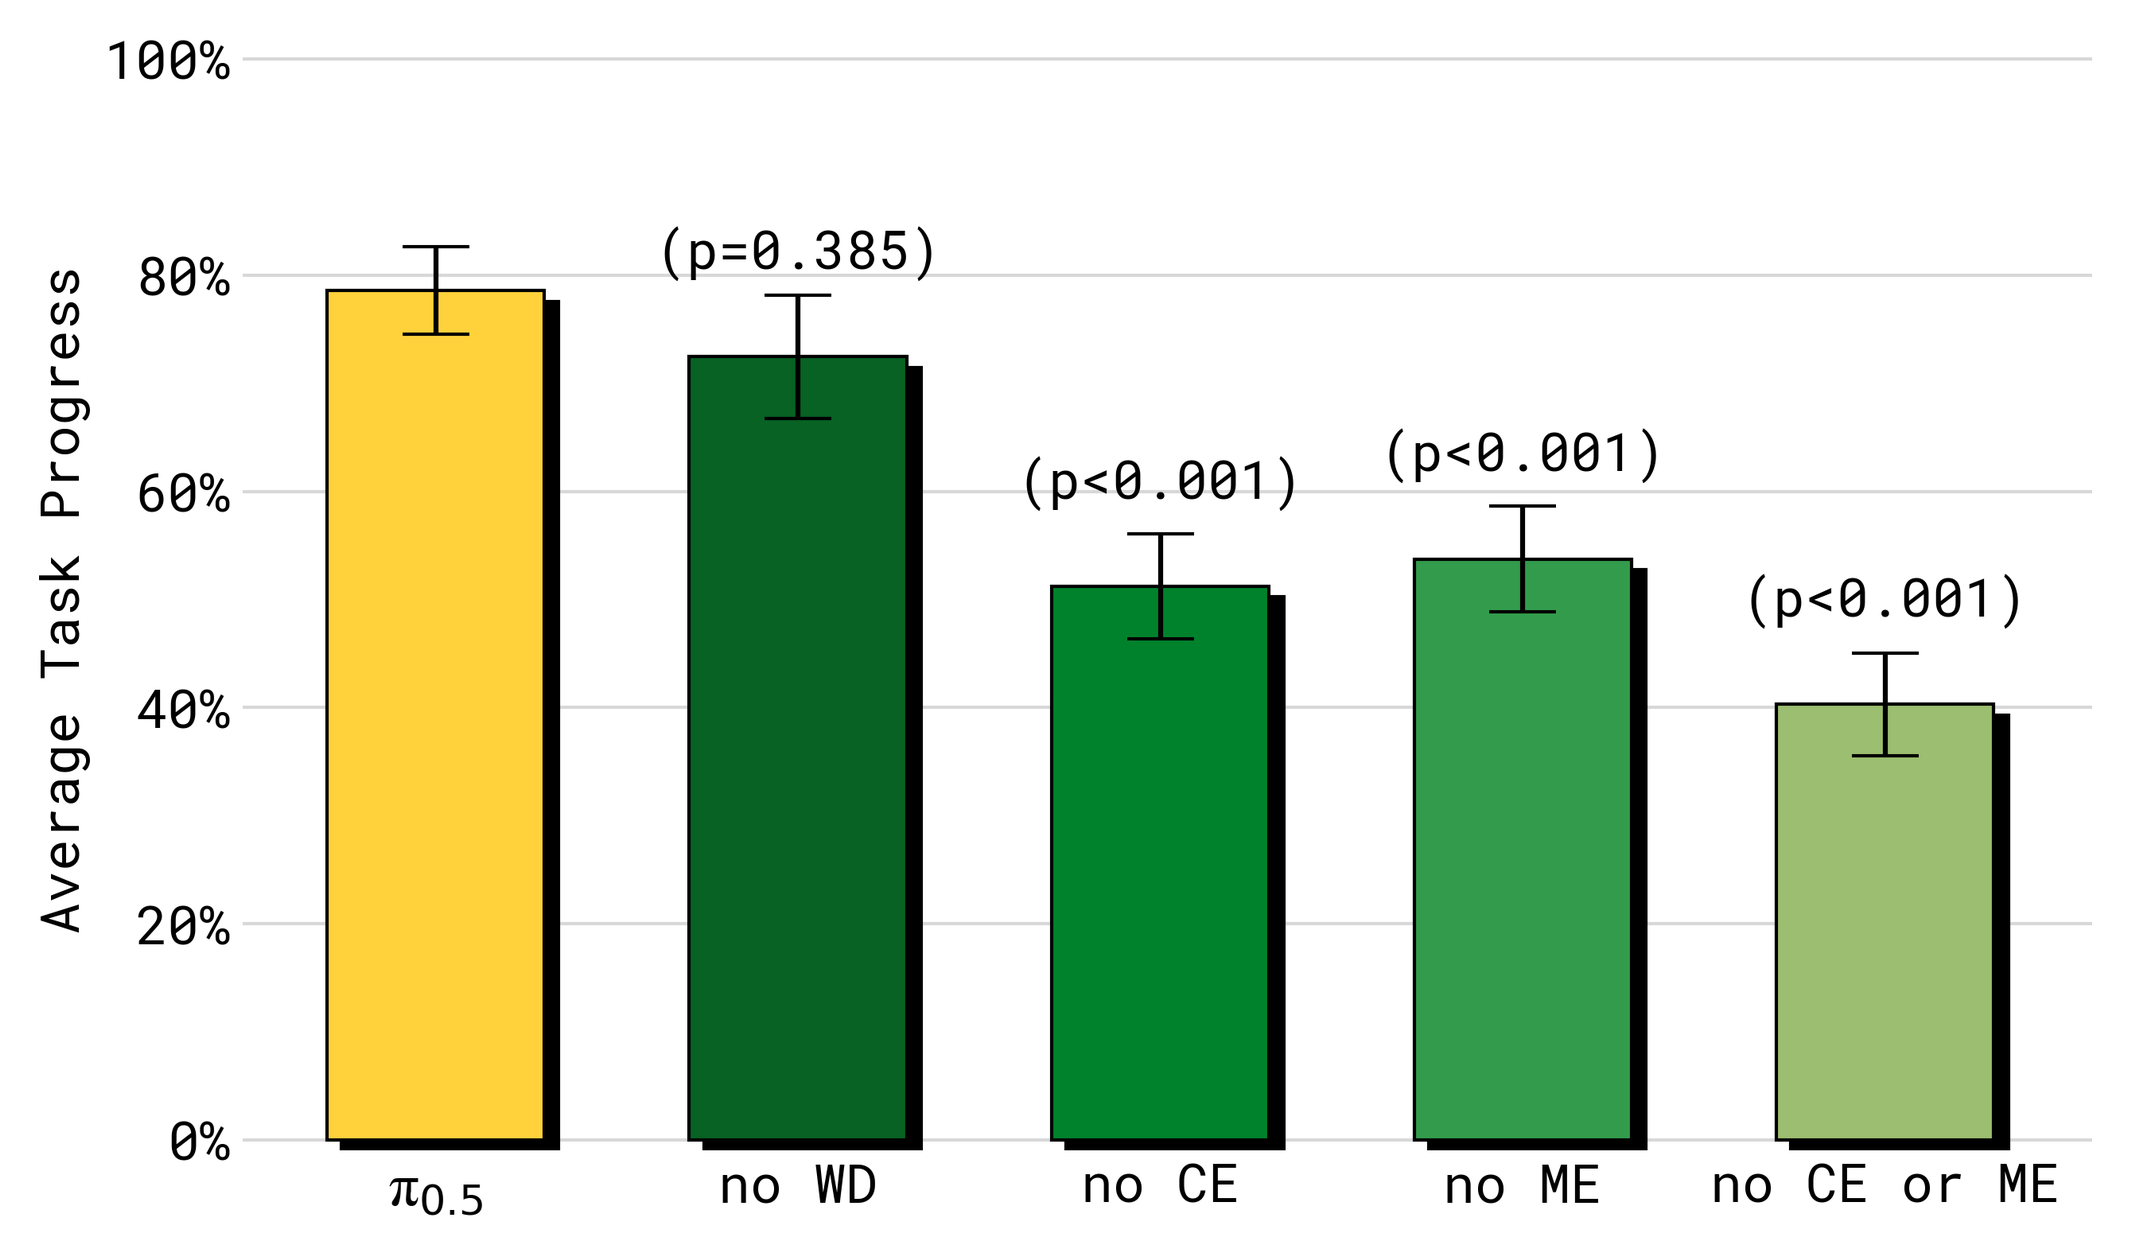
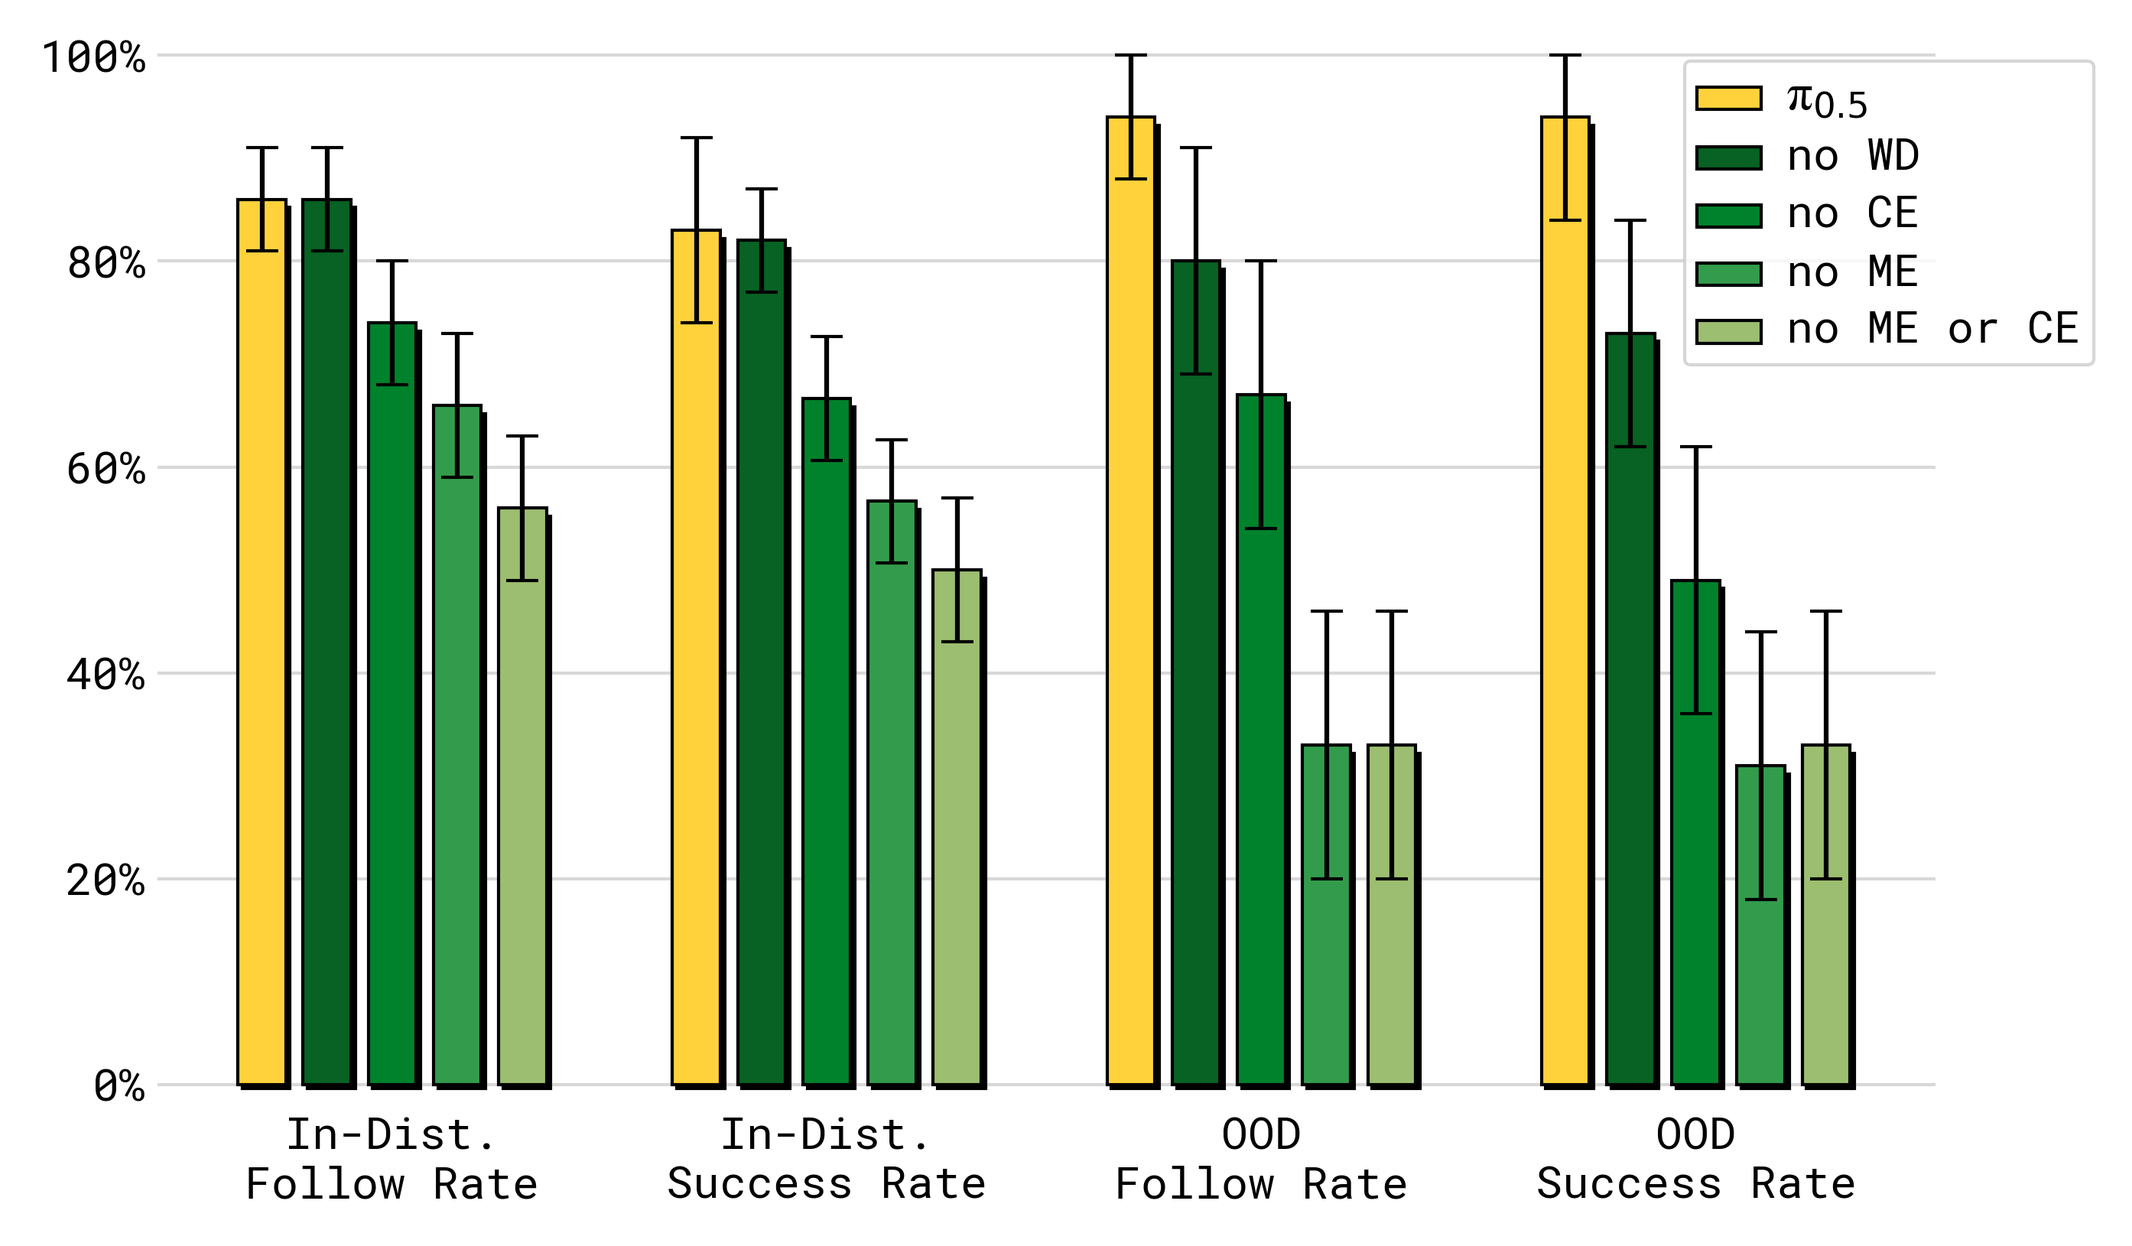
图12:配方不只是动作解码器替换。 FAST+Flow 已有混合动作表示,完整模型仍更好,说明高层和视觉语言共同训练有额外价值。然而参与比较的额外监督不同,应理解为训练方案比较,而不是纯粹固定全部信息下的网络结构比较。
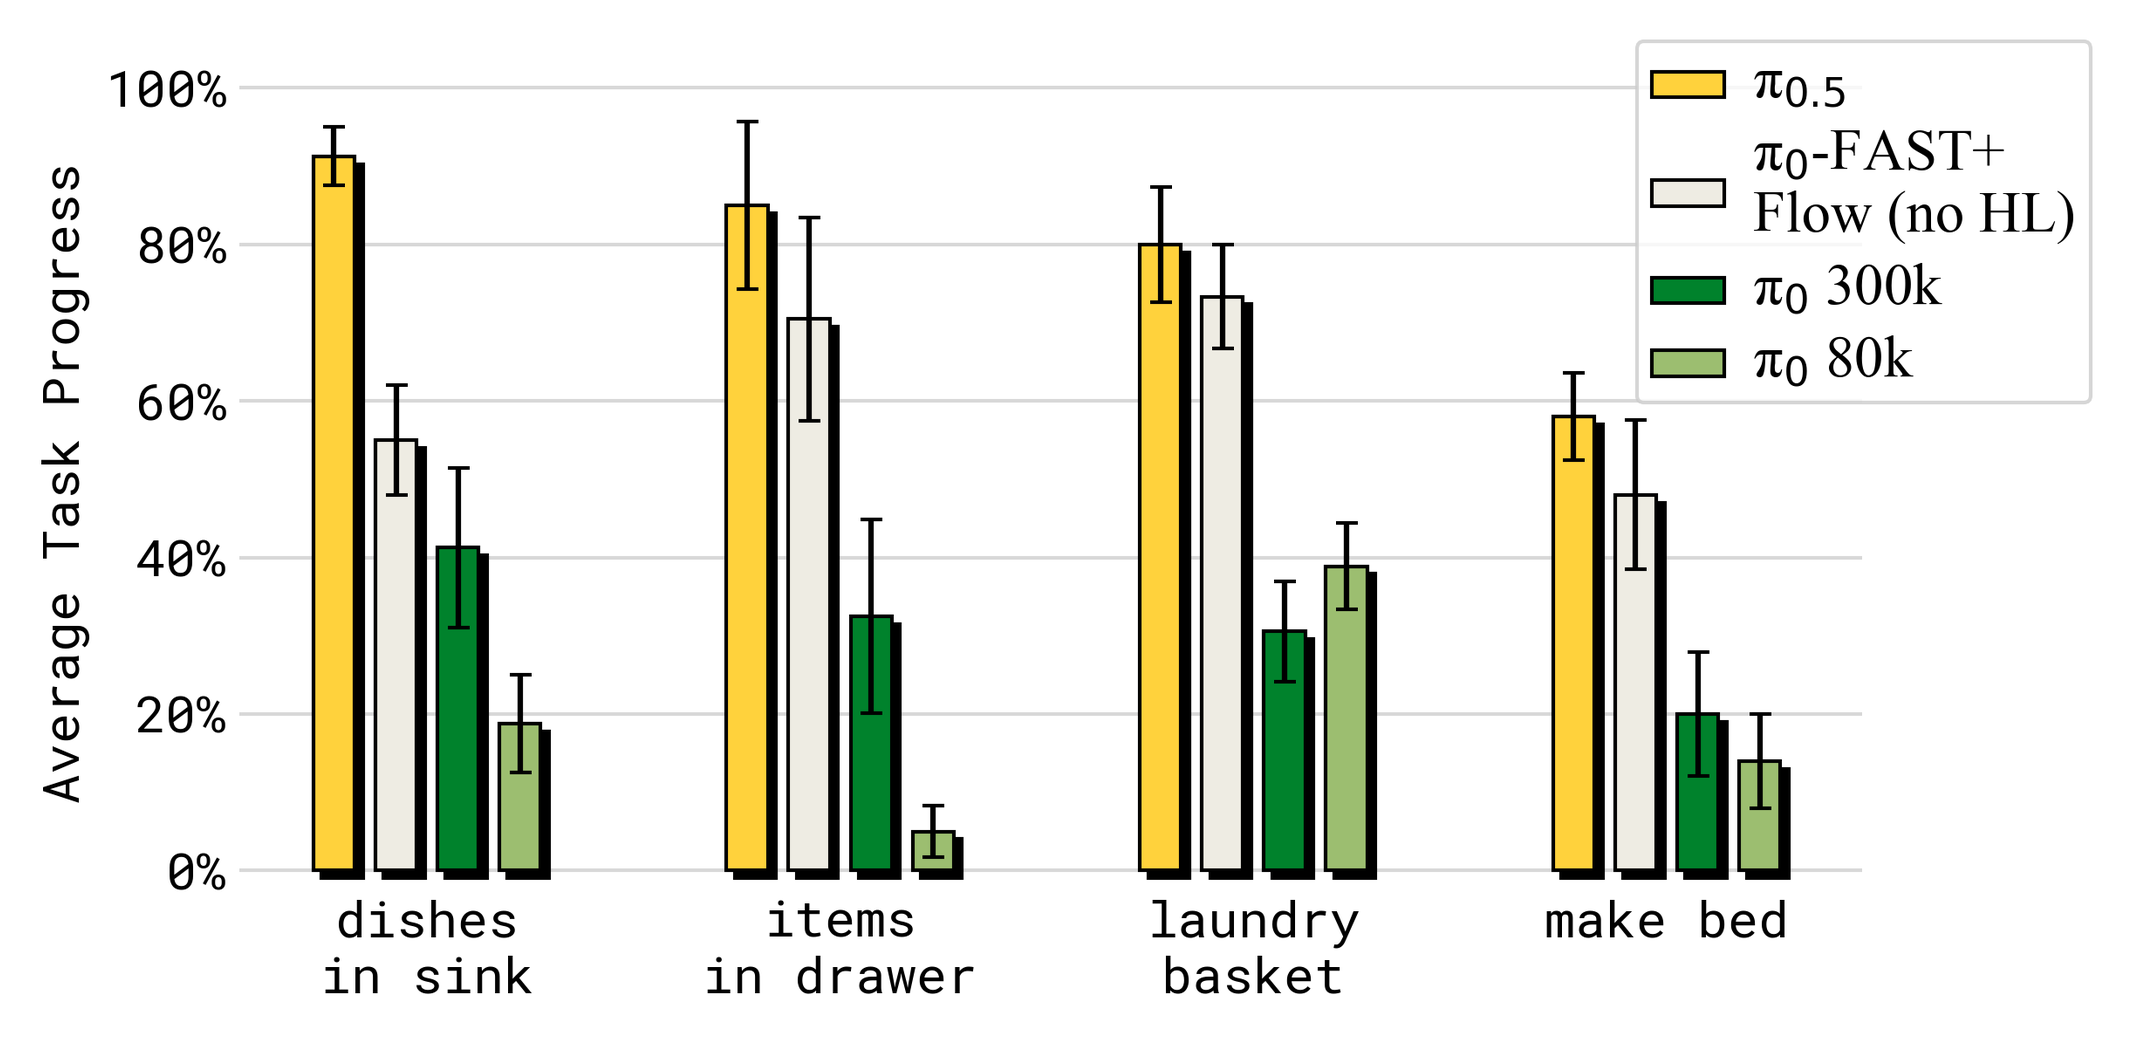
图13与附录图17:高层监督可以通过两条路起作用。 显式高层最好,隐式高层仍取得较好表现,表明子任务监督也改变了模型内部表示。完整模型超过给定人类高层的结果,不证明机器规划超过人类;这个“oracle”只是特定人类提示接口,对低层模型而言未必是最适合的指令分布。
五、层级决策仍依赖数据覆盖与重规划时机
真正的贡献是把大规模机器人经验、视觉语言知识与高层示范放进相互兼容的训练流程,并通过新家庭测试展示实用转移。动作专家与 FAST 分别服务推理效率和训练效率,说明最适合训练的数据表示未必最适合实时部署。
代价除了算力,还包括多环境采集、语义分段、定位标注与语言指导。后训练过滤较短成功轨迹,会改变策略看到的失败与恢复分布;是否能从严重失败中自主恢复,需要另外验证。
作者指出有限上下文难以处理跨房间记忆,简单指令也不能覆盖复杂偏好。我的推断是,分层语言接口会同时带来可检查性与瓶颈:它使“选错任务”和“动作执行失败”更容易区分,但子任务不能表达全部约束时,错误也会沿层级传递。未来加入记忆不能只比最终成绩,还应检查状态更新是否可靠、何时重规划。
追问:高层子任务合理但迟迟不切换时,怎样定位失败?
参考答案:需记录高层判断、低层完成信号和重新调用时机。错误可能是完成状态没被识别,也可能是高层调用太慢或低层无法结束。固定动作策略后改变高层更新日程,可帮助区分语义错误与调度错误;长任务平均分本身不能定位这条接口。
六、沿机制关系继续读
π0.5直接承接π0动作专家路线,并组合FAST作预训练动作表示;与SayCan有层级控制的教学联系,但这里不是外置语言模型乘固定技能价值。
七、自测三题与参考答案
问题1:为什么既预测 FAST 动作又训练连续动作,不是重复劳动吗?
答案: 二者服务不同瓶颈。离散预测方便与文字监督共享训练流程;连续动作专家减少部署时的自回归生成开销,并直接表示精细动作。联合训练必须阻止两种动作答案互相读取,否则连续分支可能依赖部署时不存在的信息。
问题2:implicit HL 表现好,是否说明高层推理毫无意义?
答案: 不能。它说明高层训练数据的收益不只来自推理时显式输出文字,也来自表示学习。显式推理仍有额外价值。应比较无高层监督、仅训练有高层监督、训练与推理均有高层三种情况,才能分离作用。
问题3:一个新家庭测试成功,如何判断是新任务泛化还是新场景泛化?
答案: 要检查训练任务语义与动作技能是否已出现。若训练中学过收餐具,只是换厨房,主要是场景泛化;若出现新物体类别,还包含对象语义泛化;只有任务目标或必要技能也未出现,才涉及更强的新任务问题。论文的定量家务任务主要属于前两类。