096|Xiaomi-Robotics-0:实时执行约束下的通用动作模型
原论文:Xiaomi-Robotics-0: An Open-Sourced Vision-Language-Action Model with Real-Time Execution,Xiaomi Robotics,2026。论文。
先接住前作的问题
SmolVLA用异步队列减少等待,但新旧动作衔接还可能引入不连续或过度承诺。Xiaomi-Robotics-0进一步研究前缀条件:已承诺动作怎样帮助衔接,又不让模型忽视新图像;这是实时接口问题,不只是推理加速。
五个前置概念
五个前置概念:
- KV缓存:复用视觉语言特征,避免每次动作去噪重复计算骨干。
- Winner-takes-all:仅用最匹配示范的候选承担动作回归。
- 动作条件化:把已承诺的动作作为未来生成条件。
- 注意力窗口:限制每个token直接读取的动作历史范围。
- 吞吐:单位时间完成的有效工作量,不等于单次成功率。
一、问题设定:动作块怎样接得上又能及时改变方向
机器人在等待大模型推理时停住,会降低效率;继续执行旧动作又可能与新动作不连续。已有实时分块方法把“已经承诺执行的动作”作为下一块的前缀,使新预测顺着旧轨迹衔接。Xiaomi-Robotics-0 进一步指出:前缀也可能成为捷径,模型只复制原有动作,不再充分看图像与指令。
模型输入当前多相机图像、语言和本体状态,输出连续动作块。整个方案基于离线轨迹监督,没有通过真实回报在线更新的强化学习环,也不预测可供规划的世界状态。
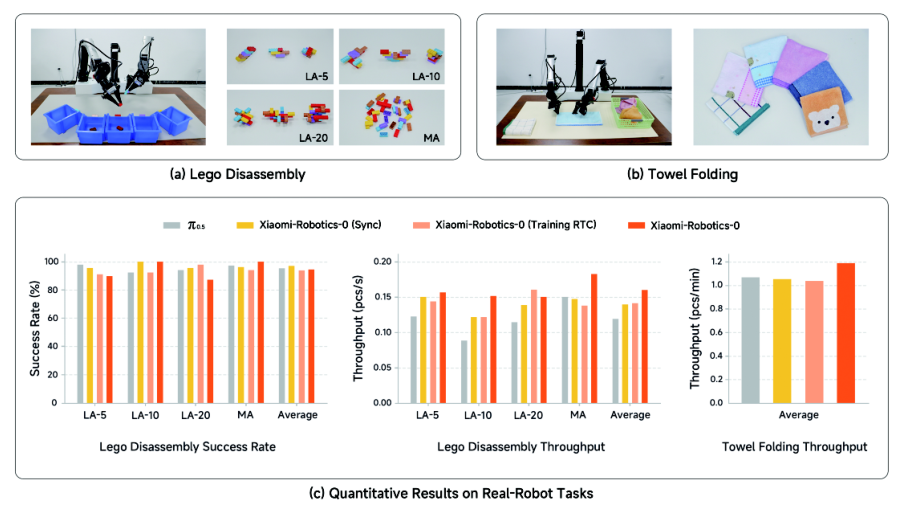
真机为双臂平台,研究乐高拆解分类和毛巾折叠。前者考验接触受力与精细配合,后者考验可变形对象的展开和重抓。两者都可能因旧动作持续过久而失败:积木被拉飞、毛巾抓住多层却仍重复抖动。
设模型生成下一块要80毫秒,控制周期约33毫秒,那么计算期间身体已经前进两到三步。返回的第一步动作实际上对应过去,不能直接从头执行。因此必须区分动作块的观测起点、已承诺前缀、返回时刻和实际执行索引。
“30Hz执行”表示控制命令节拍,不是每秒30次完整视觉语言推断;“80毫秒推理”也不包括所有潜在通信与传感器时间偏差。论文按时间戳重采样输入,有助于对齐,但不能消除传感器原有延迟。(§2.3)
二、联合干净前缀、局部注意力与时间对齐
论文因此同时处理两个问题:预训练时保留视觉语言能力,后训练时让动作既连续又具有反应性。其核心是多阶段训练、干净动作前缀、局部注意力窗口与严格时间对齐,而不是简单把一个大模型推理得更快。
真机实验中毛巾折叠吞吐从若干比较方法约1件/分钟到1.2件/分钟;乐高任务异步版本吞吐最高,但同步版本的正确分类比例略高。效率和精度并未自动同时最大化。(§3.2)
1. 预训练的两个步骤
第一步在VLM上共同训练视觉语言任务和动作预测。动作不是单一回归,而是多个候选块与相应分数:只对最接近示范的候选执行动作回归更新,分数根据各候选误差学习。这个 winner-takes-all 机制允许保留多种动作模式,避免把不同可行轨迹平均成一条不可行轨迹。
第二步冻结VLM,训练DiT流匹配动作专家,读取VLM的KV缓存。此时第一步动作候选用的额外 token 不再作为VLM输入,VLM主要提供图像语言条件。不能把候选选择误写成部署时仍运行的搜索器。(§2.2.1)
教学上可把第一阶段写成
另加候选误差评分监督与视觉语言交叉熵。第二阶段学习从噪声到示范动作的速度场。若插值 ,一致的教学目标为 。论文式1用一般目标场 表示,应以具体实现确认完整细节。
2. 用前缀约束衔接
后训练将已经承诺的干净动作放到带噪动作前,生成器预测剩余部分。它知道机器人在模型计算期间将怎么走,从而减少新旧块冲突。训练中随机化前缀长度,模拟不同推理窗口;有前缀时还按预测误差重加权,强调偏差较大的样本。
这是一种条件动作生成,不是把前缀当新鲜的真实状态。若之前预测已经错了,继续以它为条件仍可能放大偏差,因此当前视觉不能被前缀完全取代。
3. Λ形注意力
原先因果注意力允许远期动作看到全部前缀,容易利用邻近动作相似性。新掩码让每个动作只读取最近若干动作,以及视觉语言条件、状态和sink token。前缀附近仍能平滑衔接,较远部分需要更依赖观测。
这限制的是直接注意力边。多层网络仍可能间接传播前缀信息,不能说远期动作完全不知道旧动作;也不能仅凭结构就保证它一定正确使用图像。位置编码偏移帮助区分干净前缀与带噪动作,属于类型辨识技巧。
4. 部署的时间对齐
设每轮先执行 步,再启动新预测;新预测前缀覆盖 步,实际推理期间消耗 步,需要 。返回后从新块对应的第 步开始执行,跳过已经过去的动作。
这里的关键不是“多开一个线程”,而是让训练条件对应部署时的时间语义。若推理延迟超过前缀支持范围,仍需明确队列耗尽的处理。
局部注意力的间接感受野会逐层扩大。教学设每层只允许读取前3个动作位置,经过4层,沿动作token传播的信息最远仍可来自12步之前;这里暂不计全局条件通道。因此一个动作看不到前缀的直接边,不代表它在多层后完全不受前缀影响。
这不使Λ形掩码失效,它改变的是使用近邻复制捷径的难易程度。真正的反应性实验应在前缀保持一致时改变目标物位置或语言,检查未承诺的后续动作是否及时改向,并计入视觉与网络延迟。原文前缀长度随机化、位置偏移和掩码消融提供经验支持,不构成信息隔离或安全保证。原文§2.2—2.3
教学例子与前置概念
下面是未运行的例子。机器人正把毛巾向上提,下一块前缀仍包含两步上提,但新图像显示毛巾缠在托盘边。如果整个后续块都照抄前缀,机器人持续拉扯;局部注意力可以让近端保持连续、远端更有机会改成放松和重抓。
这只是为什么方法可能有效的说明,实际网络是否学到重抓仍取决于示范。注意力限制不能凭空创造数据中没有的恢复技能。
三、用已承诺前缀生成后续块并对齐执行索引
新块计算期间旧块已向前执行,返回后必须跳过过时动作。局部注意力限制前缀影响范围,但是否真正利用新图像还需要数据与对照支持。
预训练1:
    共同学习视觉语言任务与多候选动作预测
预训练2:
    冻结VLM,用其KV特征训练流匹配动作专家
后训练:
    采样已承诺动作前缀长度
    将干净前缀与带噪未来动作输入动作专家
    使用局部动作注意力、位置偏移与误差加权

异步部署:
    执行当前块前段后,采集时间对齐的新观测
    把计算窗口中将执行的动作作为下一块前缀
    模型推理时继续执行旧块
    返回后按实际已过时间跳过过时动作
    检查前缀覆盖与剩余队列,再衔接后续执行
四、分开精细拆解和毛巾吞吐证据
原图怎么读: 图6,原论文图注与图像。先看乐高拆解与毛巾折叠的装置和任务定义,再读各自定量子图。两个任务的成功判据、速度收益不同,不能用毛巾吞吐替代精细拆解可靠性。
| 实验 | 设置 | 指标 | 验证目标 |
|---|---|---|---|
| LIBERO | 四套件联合训练,动作块10 | 套件与总体成功率 | 多任务操作能力 |
| CALVIN | ABC→D及ABCD→D,1000条五任务链 | 连续完成数与链长 | 新环境及长序列 |
| SimplerEnv | 真实轨迹训练、仿真测试;Google/WidowX | 各视觉配置成功率 | 视觉域转移 |
| 乐高 | 5/10/20块结构与34块混合设置 | 正确分类块比例、每时间处理量 | 接触精度与吞吐 |
| 毛巾 | 六类毛巾,每方法两次30分钟运行 | 单次超2分钟判失败,成功件数/时间 | 可变形物体长期吞吐 |
| VLM基准 | 预训练后VLM与原骨干对比 | 问答、定位相关分数 | 视觉语言能力保留 |
训练包含约200M机器人时刻和超过80M视觉语言样本,真机两项任务各有数百小时采集。不能将成绩描述成少量示范即获得。真机适配使用相同下游训练设置比较π0.5,但预训练来源、骨干与整体历史计算并不相同。
正文给出预训练40k步、批量32768,乐高后训练40k步、毛巾80k步、批量2048;两步预训练的细分总计算、全部随机种子和图中原始误差数据没有在本文逐项核实。仿真排行榜的不同模型也不构成严格固定数据、固定算力的架构消融。
结果:五处证据
表1——接近饱和的成功率。 LIBERO平均98.7%,对OpenVLA-OFT的97.1%增加1.6个百分点。差值小而基线较强,值得关注,但不能忽略两者联合训练方式、预训练和评估随机性的不同,更不能以此推断任意真机成功率。
表2——新环境与已见环境需分开。 ABC→D平均链长4.75,ABCD→D为4.80。前者才测试未在该下游训练中出现的D环境。平均链长不是单个任务独立成功率,五任务全完成比例需要单独看第五列。
图6——吞吐优势与精度代价。 乐高同步方法正确分类比例略好,异步方法更快;论文把部分失败归因于反应较慢导致高拉力和积木飞离工作区。这支持系统取舍,不能只摘最高吞吐而省略精度变化。
图6及§3.2.3——折叠收益与行为解释。 1.2对1件/分钟是约20%相对吞吐提升。Training RTC出现重复抖动的案例,与动作前缀捷径假说一致,但这是行为解释;没有仅凭该案例就完全排除训练分布或其他模块造成问题。
表3——知识保留并非所有维度无损。 ERQA为40.8对骨干40.0,但ChartQA为59.2对76.8,ScienceQA为79.4对92.7。因而“匹配原VLM”应理解为部分能力较好保留,不能说全面不降。其他VLA接近零分还可能涉及输出格式与任务适配问题,不能仅凭外部测验断言内部视觉表示完全消失。
五、前缀约束不能创造未见恢复行为
代价是模型、数据、训练阶段和运行时逻辑都更复杂。视觉语言保留测试在预训练后进行,不自动保证后续完全解冻的任务微调仍保留同等通用能力。真机两任务展示了精细操作,但还不足以证明广泛家庭泛化或未见技能迁移。
我的分析是,动作窗口、前缀长度与延迟分布需要联合选择。窗口过短可能衔接不足,过长可能惯性复制;前缀过长更能覆盖延迟,却会延后反应。最有价值的后续实验是固定模型,在不同延迟与物体扰动下画出成功率—吞吐曲线,而非只给一个最高点。
追问:只在块边界施加扰动,会不会高估实时反应性?
参考答案:会有这种风险,因为模型恰好即将获取新观测。应让扰动覆盖块内不同相位,记录从变化发生到有效纠正的延迟,同时检查衔接是否平滑。块边界成功和任意时刻可恢复不是同一个结论,平均吞吐也无法替代这项时序测试。
六、沿机制关系继续读
本篇与SmolVLA共享异步控制问题,组合训练时动作前缀与局部注意力来减少旧动作捷径;与ACT有动作块衔接的教学联系,但前缀条件生成不同于对重叠预测直接加权平均。
七、自测三题与参考答案
问题1:为什么新动作块不能从第一个动作开始执行?
答案: 第一个动作对应发出请求时的状态,推理结束时机器人已经执行了若干旧动作。重新从头执行会把时间倒回去,造成不连续或重复。必须按已经过去的控制步跳过过时部分,并让前缀覆盖该窗口。
问题2:Λ掩码是否保证模型不会复制旧动作?
答案: 不保证。它减少远期动作直接读前缀的通路,但多层仍可间接传递信息,训练数据也可能鼓励重复。需要扰动视觉、打乱前缀或测量恢复行为来检验实际依赖。
问题3:毛巾吞吐更高,为什么不能直接宣布机器人更可靠?
答案: 吞吐综合了速度与成功件数,可能容忍更多单次失败。可靠性还需要失败率、干预次数和异常恢复成本;乐高实验恰好显示同步更准确、异步更快,两者属于不同目标。