018|BERT:隐藏部分输入,才能联合学习左右上下文
论文:Jacob Devlin 等,BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,2018 年预印本、NAACL 2019。原文 · PDF。本文以原版 MLM、NSP 与任务微调为对象;后续 RoBERTa 的训练结论不倒写成原论文实验。
先接住前作的问题
GPT在每个位置只用左侧前缀,ELMo把两个方向分别训练再组合。共同留下的是:怎样在同一深层表示里持续融合左右信息,同时避免预测词直接出现在输入中?BERT改变自监督问题,通过部分破坏输入训练双向编码器,是与因果生成不同的预训练路线。
五个前置概念
五个前置概念是破坏式自监督、双向注意力、特殊 token、任务微调和抽取式问答。理解它们可以避免把 BERT 当成只会填空的玩具,也避免把所有文本生成能力无条件归给它。
一、问题设定:怎样联合利用左右语境而不把原词直接当答案
有些词义需要后文才能确定,但直接让双向网络预测未改动的当前位置会给它抄答案的机会。两个单向模型输出拼接也不等于多层持续融合左右线索;本篇因此先破坏部分输入,再恢复被选位置,使深层双向计算获得可训练任务。
解决方法是改变监督问题。选中的位置被替换、扰动或保留,但监督只针对选中集合;模型不能把整个输入都当成未破坏答案。原版选择 15% token 作为预测位置,并按 80% MASK、10% 随机、10% 原词处理选中项。这里的比例条件是“被选中位置内部”,不能误读成全语料 80% 都被遮盖。
保留部分原词与随机替换用于缓解预训练与微调输入差异,但并不能完全消除差异。微调通常不含 MASK,而预训练监督稀疏,后续工作正会研究这些效率与配方问题。
被选中但保持原词的位置确实可能提供容易复制的局部样本;它只是训练混合的一小部分,不能因此推断整个目标退化为恒等复制,也不能声称每个预测位置都完全看不见其真实词。
二、定义被选位置,再推导破坏输入上的监督范围
设破坏后输入为 ,选中位置集合为 :
模型同时读取整段破坏输入,输出各选中词概率。这个损失不是标准自回归联合序列似然,不能把它直接当作按链式分解的文本困惑度。
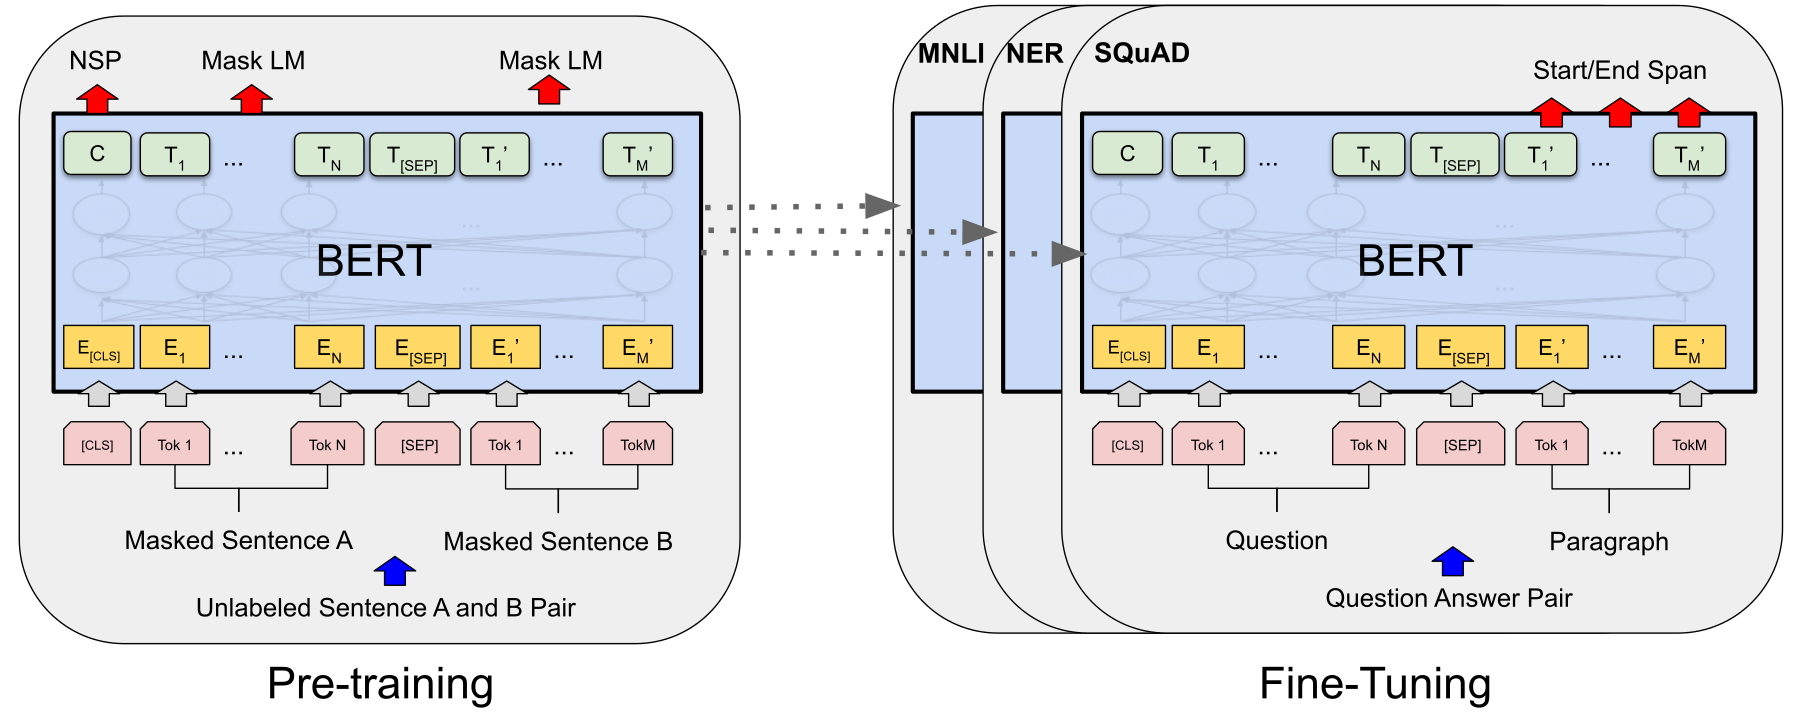
NSP 使用句段对,判断第二段是否为第一段的真实后续。输入包含 CLS、SEP、位置和句段嵌入。句段标记提供边界,不是语言学句法树,也不保证模型学到深层篇章推理。
微调时根据任务选择输出:CLS 表示用于分类,token 表示用于标注或抽取式问答。骨干和任务参数联合更新。问答的起止位置预测意味着答案通常取自输入片段,这与开放生成答案的能力边界不同。
15%与80/10/10对应不同分母
设原序列为 、被选预测位置集合为 、损坏序列为 ,MLM项为 。集合M先按15%选出,再决定选中位置如何损坏;未改变输入的选中位置仍计算损失。未选位置虽无直接词预测损失,仍通过注意力影响选中位置,所以它们的表示与参数并非没有梯度。双向性指对损坏输入的访问范围,不是把完整答案交给每个预测位置。
构造“这家[MASK]批准了贷款”。模型利用“批准贷款”与前文恢复目标词。若输入直接保留目标词且每个位置都监督自己,网络可能只复制当前嵌入,学不到所需上下文关系。破坏输入迫使它利用其他线索。
从掩码损失回追未选位置的梯度
未被选作预测目标的位置不直接贡献词表交叉熵,却可作为键和值被掩码位置读取,因此仍可能通过注意力收到梯度。检查时把“是否进入损失”与“是否参与计算图”写成两张掩码;若把所有未选位置都detach,就额外改变了原BERT训练,而非仅实现15%的目标选择。
教法联系:Lilian Weng的The Transformer Family。算例为本文自构。
三、分别执行MLM、句段任务与带标签微调
预训练:
    构造连续或非连续句段对
    选15%位置,并按原版比例遮盖、替换或保留
    用双向Transformer编码破坏后的输入
    计算选中位置MLM损失与句段NSP损失
    更新预训练参数
微调:
    按任务加入分类或token级输出层
    用真实任务标签更新骨干与输出层
测试:使用对应任务格式和独立评价数据
数学目标是两个预训练损失与后续监督目标;机制是深层双向编码;实验指标包括准确率、F1、相关等。所谓“理解”需要由这些具体任务支撑,不是一个单独被直接优化的量。
教学算例。 1000个token平均选150个监督位置,其中120个替换成MASK、15个随机词、15个保持原样,其余850个不直接计算MLM词损失。说“80%的所有token被遮盖”把条件概率分母换错了;说“仅MASK位置有监督”又漏掉30个位置。一次抽样数量会波动,这些是期望而非每个batch必然精确计数。
四、从主结果走向方向和NSP的受控比较
在说明监督与微调预算后,再区分跨系统主结果和原条件下的目标消融。
| 项目 | 原文范围 |
|---|---|
| 预训练语料 | BooksCorpus 与英文 Wikipedia |
| 模型 | BASE、LARGE,层数与隐藏规模不同 |
| 下游 | GLUE、SQuAD、SWAG 等任务 |
| 微调 | 各任务使用标签,开发集选择学习率;小任务可多次重启选模型 |
| 主对照 | 既有系统与原 GPT;另用更受控目标消融 |
| 指标 | 任务不同,GLUE 表中平均明确排除 WNLI,不能视为完全相同官方聚合 |
| 不确定性 | 最佳重启选择不是随机种子均值,应保留模型选择预算 |
证据一,第 3 节与图1。预训练和微调接口展示了模型如何统一接入任务。它支持架构通用性,不表示一个微调模型同时解决所有任务。 原图从左到右分别展示预训练与任务微调;不同任务复用初始化,但微调会更新全部参数。图中的箭头表示信息与训练流程,不是效果排名。
证据二,表1、表2、表3、表4。多任务结果提供广泛经验支持,但与原 GPT 的比较包含预训练数据和配方差异,不能全部归因于注意力方向。表1 的聚合指标也有特定口径。
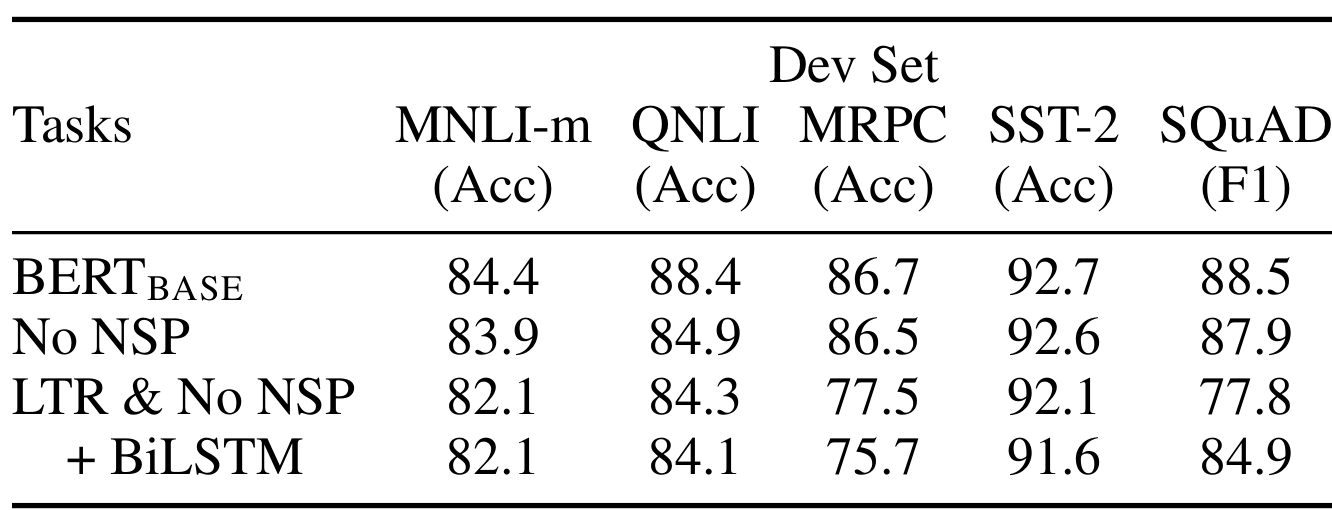
证据三,表5。BASE 的 SQuAD 开发 F1 为 88.5,去掉 NSP 为 87.9,改为左到右且无 NSP 为 77.8;这是更接近机制隔离的比较,但仍限于原文训练条件。不能据此证明任何规模和数据下 NSP 都不可删除。
原文说明小数据微调有时不稳定,并做不同初始化和数据顺序重启后选开发集最好者。报告单个最终成绩时,若省掉这一过程,会低估复现成本,也高估一次训练就达到相同结果的概率。
五、掩码接口不保证因果生成或事实校验
但上下文可能允许“银行”“机构”等多个合理答案,训练只给一个真实词。模型拟合的是文本分布,不是逻辑上唯一正确的填空规则。高预测概率也不保证句子陈述真实,常见错误表达仍可能获得高概率。
抽取式问答例子中,输入写“甲于 1998 年成立”,模型预测年份片段位置。若原文事实错误,模型可以忠实抽取错误年份,得到相应任务分数。文本匹配和事实校验是不同能力,必须另外评价。
限制包括预训练监督稀疏、MASK 分布差异、长度、数据偏差和小任务稳定性。它没有提供标准因果文本生成接口,也没有显式事实数据库。
六、把本篇机制再推进一步
1. 没有直接MLM损失的850个位置,是否可以在反传时全部丢掉?
参考答案:不能据此判断。它们仍作为被选位置的上下文,通过注意力参与预测,损失可沿这些路径影响其表示与共享参数。监督稀疏指直接预测项稀疏,不代表计算图只有选中位置;要降低计算还需额外算法设计。
七、重审配方、增加监督位置,再对照掩码生成
掩码训练的设计与实现预算可以分别改变。RoBERTa重检训练配方,ELECTRA改为判别替换token;前者不应被称为新骨干,后者也不是简单把掩码比例调大。
自测与参考答案
1. 15%、80%、10%、10% 各指什么?
先选择全部 token 中的 15% 作为预测集合,再在该集合内部决定 MASK、随机词或原词的比例。监督只计算选中位置,不能把比例相加成全输入的破坏率。
2. BERT 的 MLM 损失能否直接当作标准自回归文本概率?
不能。它在破坏输入条件下预测选中位置,不是逐位置仅依赖前缀的链式分解。若需要文本概率或困惑度,必须明确另行定义的计算协议。
3. 表5 能否证明 NSP 永远必要?
不能。它说明在原文相同数据与配方下删除 NSP 的效果。其他训练量、数据组织和目标组合可能改变结果,需要后续受控实验,而不是把一张消融表提升为普遍定理。