023|RoBERTa:在提出新目标之前,先把旧模型训练充分
论文:Yinhan Liu 等,RoBERTa: A Robustly Optimized BERT Pretraining Approach,2019。原文 · PDF。本文的重点是受控训练配方分析,不把最终大规模结果简单归为删除 NSP 一个改动。
先接住前作的问题
BERT提供有效双向预训练,XLNet又提出目标变化;但跨论文同时变化的数据和训练预算让“目标更好”难以判断。本篇直接重审BERT配方,把尚未解决的比较问题变成控制变量实验。
五个前置概念
五个前置概念是控制变量、动态遮盖、文本打包、等token预算和中位数汇总。掌握这些,读者不仅能理解 RoBERTa,也能更严格地阅读任何声称“新方法优于旧方法”的论文。
一、问题设定:新目标胜过BERT,还是旧基线尚未训练充分
BERT与XLNet等模型可能看过不同语料、训练步数和硬件预算。新方法分数更高,未必来自新目标;本篇先固定BASE架构研究遮盖、文本打包和batch,再扩大训练形成最终模型,分别回答机制归因与可达到的质量。
另一个关键是“移除 NSP”与“改变输入组织”常同时发生。若仍保留短随机句段配对,只删除损失,与采用连续完整句子不完全相同。输入覆盖的上下文关系会改变,即使网络与标签数量看起来接近。
二、保留MLM并拆开遮盖、文本组织与批量干预
核心损失仍是选中位置的掩码预测:
动态遮盖每次使用文本时重新抽取模式,使同一内容能产生不同预测任务。静态预处理也可以存多份遮盖,二者差异不是“有随机性”和“完全没有随机性”,而是模式更新方式与训练覆盖。
论文比较带 NSP 的片段对、单句对、不带 NSP 的完整句子打包、单文档句子等方案。完整连续内容有助于保留较长关系,但文档边界与变长 batch 也影响效率。最终选择不仅依据质量,也考虑与其他方法比较的便利。
较大 batch 配合学习率等调整,更多数据与更多训练步提高拟合程度。分词方案也有变化。每一项都可能改变结果,因此复现不能只把 BERT 的 NSP 权重设零后自称 RoBERTa。
动态遮盖改变的是重复曝光的监督多样性
把一个位置每轮独立入选的概率近似为 ,经过r次曝光至少被预测一次的概率为 。静态遮盖重复同一破坏样本时,没有这种新增覆盖;原BERT也预先制作多份mask,所以不能把静态基线画成“永远只有一份”。这是覆盖的教学近似,不代表不同token损失独立或更高覆盖必然带来同幅性能增益。
构造一个实验,把 NSP 删掉同时将每条训练样本从两个短句改成长连续文档。模型看到的跨句关系、每batch token数和计算利用率都改变。即使分数提升,也不能单独归因于 NSP 的监督有害。
算清重复曝光后仍未成为预测目标的比例
若每轮独立以0.15概率选某位置,重复4轮后至少被选过一次的概率为1−0.85⁴,约47.8%;固定同一掩码则仍只有最初15%的位置被选。这个算例只比较目标覆盖,未说明训练损失一定改善,也没有计入被选位置中保持原词或随机替换的进一步分支。
三、按实际token曝光记录训练配方
准备清洗后的训练文本与固定分词器
按连续完整句子规则打包到长度预算
每次取样时动态生成MLM破坏模式
用双向Transformer计算选中位置损失,不加入NSP
按选定batch、学习率和训练步数优化
先在固定架构数据上比较配方,再进行规模扩展
对下游任务微调,多次运行按原协议汇总
输出:预训练模型与可追踪的训练配置
教学算例。 独立动态采样10次后,至少一次入选概率为 ,而不是 。另一方面,batch翻倍且步数不变会让总token预算也翻倍。比较大batch时,应先算 ,再谈优化效应。
四、用受控表格检验单项,再读扩大训练的结果
这里真正值得学习的创新,不必是一条全新损失公式,而是把此前容易混淆的因素拆开测量。
先读动态mask的涨跌与NSP/打包组合,再把最终大模型成绩放到扩大预算的层面。
表1比口号更克制。 动态相对静态在SQuAD为78.7对78.3,在MNLI-m为84.0对84.3,在SST-2为92.9对92.5,均为5个随机初始化的中位数。结论应是相近或略有改善,不是所有任务一致上升,更不能将最终RoBERTa全部增益归给动态mask。
| 项目 | 原文范围 |
|---|---|
| 控制阶段 | 固定 BERTBASE 架构,比较遮盖、输入和batch |
| 数据阶段 | 原始 BooksCorpus/Wikipedia 与更大混合语料分开 |
| 下游 | GLUE、SQuAD、RACE 等 |
| 重复 | 表1、表2 报告五次随机初始化的中位数,不是最佳单次 |
| 预算 | 同步数不一定同token数,短句条件通过batch调整匹配 |
| 最终结果 | 更多数据训练后的大模型,需要单独计入总计算 |
证据一,表1。动态与静态遮盖表现相近:例如 SQuAD 2.0 从 78.3 到 78.7,但 MNLI 从 84.3 到 84.0。它支持动态遮盖可行且便于扩展,不支持“动态遮盖单独大幅提升所有任务”。
证据二,表2。不同句段组织与 NSP 配置比较显示,不带 NSP 的连续文档设置有较好结果。因为输入组织同时变化,更准确的结论是这套训练设置无需 NSP,不能把全部差异归给删除一个损失。
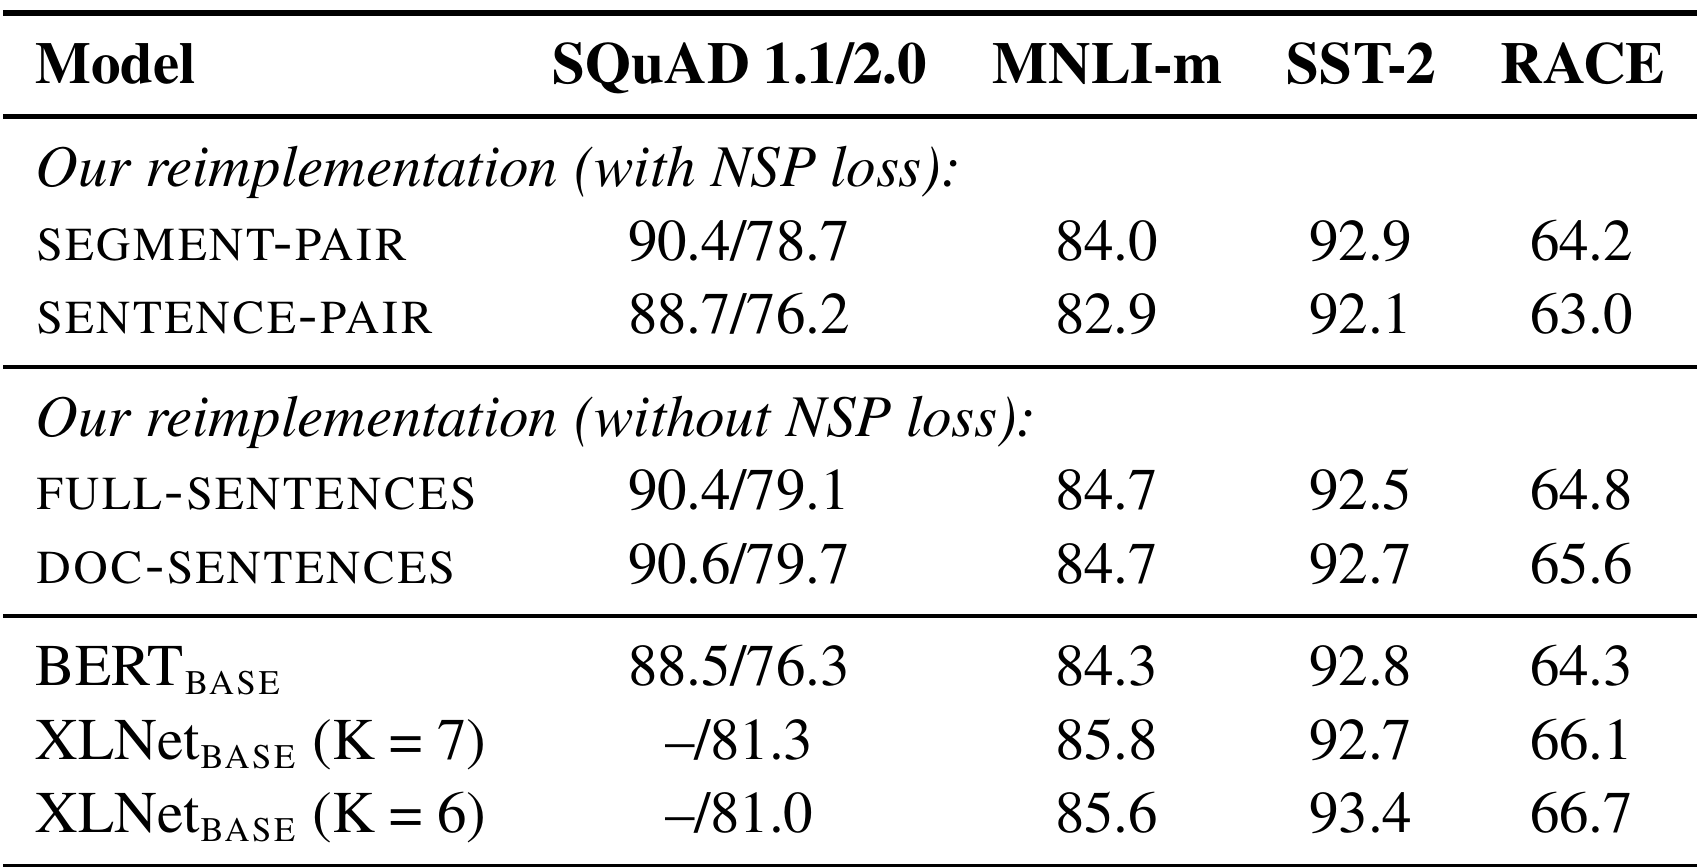
证据三,第 4.3 节、表3 及后续规模实验。batch、数据与训练量研究说明原架构仍有提升空间。最终强结果支持建立充分训练基线,但资源增加与配方改进要分别说明。
这些结果还提醒我们,中位数对异常运行不敏感,却不等于完整不确定性描述。若要讨论可靠性,最好看运行分布、方差和失败次数;论文报告何种统计,就按何种统计解释。
更严格的设计至少有四组:保留/删除 NSP 与原句段/连续文本交叉组合,尽量匹配总 token 和训练预算。这样才可能观察交互效应。论文未必穷尽所有组合,阅读者应明确已有证据支持到哪一层。
五、强基线提高归因标准,不提供无限扩展保证
再比较动态遮盖与静态十份模式。若只训练一个 epoch,两者覆盖差异可能很小;训练很久后,动态方案可提供更多模式。方法收益随训练长度变化,因此不能脱离预算为一个预处理选择给出永久排名。
若弱基线让所有新方法显得有效,领域可能投入大量复杂机制,却忽略更直接的数据与训练因素。强基线减少这种误判,让真正有效的结构改动更容易被识别。它不会取消创新,而是提高归因标准。
同时,充分训练并不意味着无限训练。重复数据可能带来收益递减、过拟合或额外成本。最终选择应基于质量—资源曲线,而不是谁使用最多设备。后续规模定律会进一步把这种资源配置问题形式化。
限制是仍依赖昂贵预训练、有限领域和下游微调,未解决生成、事实验证或数据偏差。其结论也不能推断每一种辅助目标都没有价值。
可以把最终配方看作一个实验结论集合:哪些变化在小规模条件下有效,哪些主要改善扩展效率,哪些只有组合后才体现收益。这样记录比列一串超参数更有用,因为迁移到新数据或硬件时,读者能够知道哪些结论需要重新验证。
六、把本篇机制再推进一步
1. 动态mask训练更久后覆盖增加,能否据此预言任务分数同幅提高?
参考答案:不能。覆盖公式只计算一个位置至少被监督一次的概率,不保证这些监督独立、同样有用或被充分学习。正文表1还出现不同任务方向不同的结果;应把覆盖当机制解释,把受控任务评价当效果证据。
七、将受控迁移比较扩展到统一文本接口
更充分训练后,参数效率与监督密度仍是不同问题。ALBERT共享参数,ELECTRA让更多位置参与判别;沿这两条平行路线,应分别控制容量、运行次数与有效监督量。
自测与参考答案
1. 为什么动态遮盖不等于每次都会显著提升表现?
它改变监督模式覆盖,收益取决于重复次数、数据量与训练充分程度。原文小规模比较中部分指标接近甚至略低,应据此保留条件,而非将最终大模型收益全部归给它。
2. 删除 NSP 的实验为什么要检查文本打包?
输入组织决定模型看到哪些跨句关系和序列长度。如果它也改变,结果包含交互影响,不能单独判断 NSP 损失的因果作用。
3. 两个方法训练步数相同,预算是否一定相同?
不是。batch大小、序列长度、有效token、模型计算和硬件利用率都影响成本。应至少同时记录token量和计算或时间,避免把相同步数误称为等预算。