022|XLNet:改变预测顺序,让自回归目标学习双向信息
论文:Zhilin Yang 等,XLNet: Generalized Autoregressive Pretraining for Language Understanding,2019。原文 · PDF。本文引用的修订 PDF 包含后续扩展比较,年份按首次公开计;不把修订版所有榜单结果当作最初版本已有内容。
图表来源:Zhilin Yang 等,2019,原文;CC BY 4.0。本篇展示做了图形区域裁切,图中数据与标签未改动。
先接住前作的问题
BERT通过损坏输入获取双向表示,却留下预训练输入差异与目标依赖问题。本篇提出平行的排列自回归路线,并组合Transformer-XL的片段记忆。它改变概率因子的条件顺序,不能理解成把自然句子随意打乱再训练。
五个前置概念
五个前置概念是概率因子化、排列掩码、查询流、内容流和信息泄露。理解它们后,可以把“自回归”看成条件分解原则,而不仅等同于固定左到右顺序。
一、问题设定:不用同样的MASK方式,怎样让预测使用两侧内容
给定原句 ,按 因子顺序先预测第二词,再用它预测第一词,最后预测第三词;原位置与句意没有变。这样某位置可使用原句两侧已揭示内容,难点是让模型知道要预测哪里,同时看不到该位置真实答案。
二、从排列因子化推到目标位置可知、内容不可见
设 为位置排列集合, 为采样排列:
排列决定哪些位置已经可见。问题是,预测位置需要知道目标位置身份,但不能读取其真实 token 内容。普通单流表示若包含该词,会泄露答案;若完全没有位置身份,又不知道要预测哪里。
内容流保存已知内容的上下文化表示;查询流仅使用目标位置与允许的先前内容来形成预测表示。两者使用不同可见关系。双流不是正向和反向各一个语言模型,也不是教师与学生网络。
实现为效率只预测排列中的部分位置,并结合片段循环与相对位置。部分预测会改变实际监督密度,循环机制会改变上下文范围,因此公平比较要记录这些细节,而不只对齐参数数。
一个排列对应一套可见性,而非打乱句子
长度3的文本保持位置 不变,若因子顺序为 ,其目标是 。最后一项同时用原位置左侧与右侧信息。查询流只能携带目标位置及已观察内容,内容流才包含当前位置token;若预测 的查询表示也读入 ,多层网络便可抄答案。
设句子为“猫喜欢鱼”,要在某个排列下根据“猫”和“鱼”预测中间位置。查询流知道目标是第二位置,能看允许的两侧内容,却不能把“喜欢”的输入嵌入当作自己的预测特征。内容流则可在其他预测步骤需要时携带该词。
把三位置排列写成可见集合
原句位置保持1、2、3,取预测次序2→1→3。预测位置1时可读位置2的内容,却必须隐藏位置1自身;预测位置3时可读1和2。若把“原位置”与“预测先后”当成同一索引,就会错误移动位置编码,或让query流读到自己的标签。两流机制正是为同时保留目标位置与遮住目标内容。
教法联系:Lilian Weng的The Transformer Family。算例为本文自构。
三、逐层验证双流权限,并记录部分预测和片段记忆
输入:保留原位置的文本片段
采样位置因子化顺序,确定允许预测的目标子集
构造内容流与查询流的不同注意力掩码
内容流:编码已允许读取的token内容
查询流:使用目标位置身份与先前可见内容,排除本位置答案
对目标子集计算条件词概率并累加损失
按Transformer-XL协议使用跨片段缓存
预训练后,按任务格式微调并独立评价
教学诊断。 对“甲、乙、丙”按上述顺序预测乙时,可见甲和丙;把乙替换成丁但保持已观察位置不变,预测分布在看到标签前应完全不变。若分布已变,说明掩码或查询流泄漏。这个测试比只检查attention矩阵是否三角形更有针对性,因为三角形应定义在因子顺序上。
如果错误让查询流访问本位置内容,训练损失可能极低,但那是抄答案。相反,若不给目标位置任何身份,在多个空位时模型可能无法判断究竟预测哪个词。双流正是同时满足位置可知与内容不可见。
四、先读WikiBooks控制实验,再比较大规模配置
排列平均提供不同上下文条件,不直接保证模型会进行组合推理或在任何任务超过 MLM。
预训练目标、片段记忆与更多数据可能同时贡献收益,受控表格应先于总榜结论。
| 项目 | 原文修订版范围 |
|---|---|
| 数据 | WikiBooks 控制配置与更大混合语料配置分开报告 |
| 模型 | BASE、LARGE 及 Transformer-XL 相关组件 |
| 任务 | 问答、阅读理解、分类、GLUE、文档排序等 |
| 受控比较 | 表1 对齐 BERT 的数据与主要训练设置 |
| 扩展比较 | 后续表格包含更大训练与其他当时模型,不等于只改目标 |
| 重复 | 修订版表5 开发集报告十次运行中位数,测试榜单与集成另列 |
证据一,第 2 节和双流图。说明怎样避免目标内容泄露。读者必须能沿查询流追踪允许的信息,否则仅背“排列语言模型”不足以实现算法。
证据二,表1。WikiBooks 受控配置与 BERT 变体比较,例如 RACE 从所列 BERT 的 75.1 到 XLNet 的 77.4。它比跨不同语料的大模型总榜更适合讨论方法差异,但仍需考虑骨干机制。
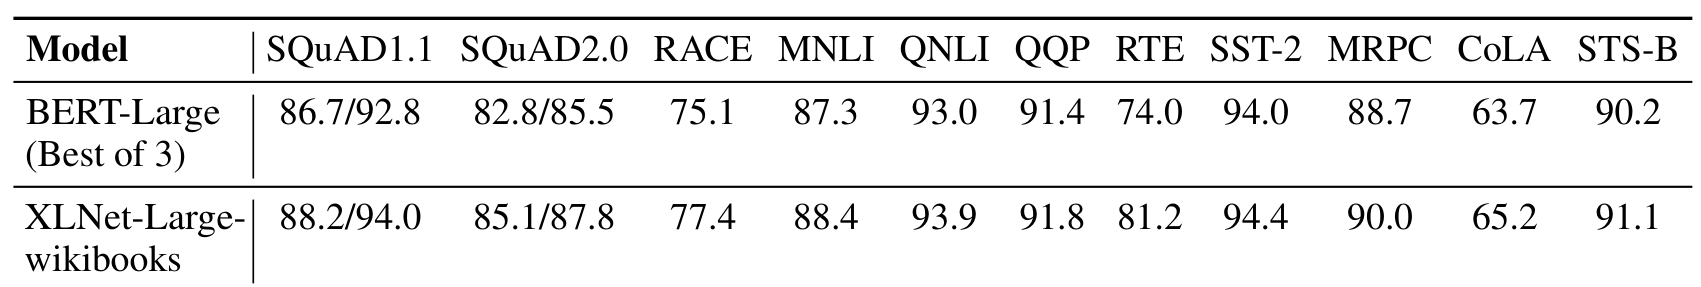
证据三,第 3.4 节消融与表5。消融分别研究排列目标、Transformer-XL 和实现选择;表5 也存在部分任务并非优于 RoBERTa 的情形。结果支持一套有效方案,不能概括为每个理解指标全面领先。
大规模配置使用更多语料和计算,论文修订版还明确讨论与不同规模模型比较的困难。阅读时间线时,最好区分初稿主张与修订表格,避免把后来比较误当作 2019 年最早实验的直接证据。
五、复杂可见图仍会泄露答案或混入预算收益
再将排列固定为从左到右,会接近普通因果条件结构,双向条件的多样性随之减少。这可以作为理解目标的极端情况,但完整实现仍有循环、位置和部分预测差别,不能说完全自动等同于 GPT。
双流与排列掩码增加实现和调试复杂性,错误的可见关系尤其难发现。训练也需要处理目标子集、缓存及位置关系。更多结构可能提升表示,但不能只看参数量评估成本。
此外,任务微调仍需要标签,模型不能因为预训练条件更丰富就自然成为对齐聊天助手。排列目标的收益也依赖训练配方,后续 RoBERTa 对 BERT 训练不足的研究说明,目标比较必须放在相当资源条件下。
实现双流时可以设计一个直接的泄露检查:固定查询位置和允许上下文,仅替换该位置真实token,当前查询预测在相应掩码条件下不应直接随答案内容改变;再替换一个允许位置,预测则可以变化。这个自构检查检验信息图,不代替下游评价。还应核对缓存中是否已经间接含有目标内容,因为只检查当前层掩码不足以排除多层绕路泄露。排列训练的难点就在于信息权限必须在所有层保持一致,而不仅是在输入序列上画一条箭头。
六、把本篇机制再推进一步
1. 查询流当前层遮住目标词,为什么还要检查缓存?
参考答案:目标内容可能已经进入某个允许读取的中间表示,再通过后续层绕回查询。直接掩码只约束一条边;应固定允许上下文并替换目标真实token,追踪所有层与缓存中的依赖,才能检查信息图是否始终满足因子顺序。这个诊断不代替下游评价。
七、用更强BERT配方检验目标比较
排列目标提供另一种预训练条件,但训练配方也能改变结果。并读RoBERTa以区分目标与预算因素,再读T5看任务接口怎样统一为文本生成;不把目录次序当作架构继承。
自测与参考答案
1. XLNet 是否把句子词序随意打乱后训练?
不是。原位置含义保留,变化的是预测因子顺序与允许的条件集合。通常通过掩码实现,而非把打乱句子当作正常文本。
2. 查询流为什么不能直接使用目标词嵌入?
它的任务是预测该词,使用真实内容会泄露答案。查询流需要位置身份和已允许上下文,内容流则承担保存已知 token 信息的角色。
3. 大模型成绩优于 BERT,能否全归给排列目标?
不能。数据、计算、Transformer-XL、部分预测和微调也会变化。应优先读受控表与消融,分别判断目标和其他组成的贡献。