027|T5:把不同语言任务变成同一种文本输入输出接口
论文:Colin Raffel 等,Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer,2019 年预印本、JMLR 2020。原文 · PDF。这是一篇包含大量受控研究的长论文;本文定向讨论统一接口、span corruption、数据与训练比较,不声称穷尽全部附录实验。
先接住前作的问题
GPT和BERT让预训练服务多任务,但输入转换、任务头和目标同时变化,容易妨碍比较。本篇组合Transformer编码解码与去噪思路,把输入输出统一为文本,提供控制这些选择的实验接口。
五个前置概念
五个前置概念是条件生成、任务前缀、span corruption、哨兵标记和控制变量。理解它们,就能区分“格式统一”“参数共享”和“无监督获得所有任务”三个不同主张。
一、问题设定:怎样统一任务接口以比较预训练,而不抹去任务差异
分类生成标签、翻译生成句子、问答生成答案,能否都写成同一条件文本生成接口?若改变预训练目标时还换任务头与数据处理,差异难以归因。本篇用任务前缀和文本标签减少接口变化,但输出长度、标签合法性与评价标准仍然按任务规定。
文本输出并不意味着评价只看字符串完全相同,也不意味着生成任何近义标签都自动算对。解码与任务映射必须固定。
预训练数据 C4 来自对 Common Crawl 的清洗。过滤策略决定哪些文本被保留,也可能排除某些语言或风格。因此数据集不是背景附件,而是方法和可复现性的核心部分。
二、由缺失片段与哨兵推导输入输出长度
T5 的常用 span corruption 将连续片段替换为特殊哨兵 token,目标只生成被移除片段及相应哨兵,而非总是重建整段文本。设输入为 、破坏函数为 、目标缺失片段序列为 :
每个哨兵标识一个缺口,解码器据此输出相关内容。连续片段被单一哨兵替换,输入和目标长度可以较短,影响训练速度。破坏比例与平均片段长度控制任务难度及计算。
编码器双向读取破坏输入,解码器因果生成目标。下游同样使用编码解码结构,只将输入换成任务文本。预训练目标和监督任务共用条件生成形式,不代表它们具有相同数据分布。
论文还比较仅解码、前缀语言模型、不同去噪和迁移方式。最终选择应理解为其研究范围内有效组合,而非数学上唯一最优。尤其一些去噪变体质量差异不大,计算长度可能成为选择依据。
哨兵同时定义输入缺口和输出协议
设损坏前长度为n、删除m个token并组成k段。每段用一个哨兵替换后,编码器长度约为 ;目标包含m个被删token、k个片段起始哨兵与额外结束哨兵,约为 ,忽略常规EOS。相比重建全文,解码器主要为缺失内容付费。哨兵是例内不同片段的身份标记,并非“原位置数字”的直接编码。
合并教学例。 原序列为 A B C D E,遮住B与D后,输入是 A <extra_id_0> C <extra_id_1> E,目标是 <extra_id_0> B <extra_id_1> D <extra_id_2>,另按约定处理常规EOS。两个缺口共用一个mask会丢失逐段定位接口;把完整原句作为目标又会改变去噪任务。对应前面的长度账本,n=100、m=15、k=5时输入为90、目标约21;相同15%删除率若每token各成一段,哨兵更多,计算量和缺口难度都改变。
三、固定任务前缀、标签映射与条件生成
预训练:
    从清洗语料取文本
    选连续破坏片段,以不同哨兵替换
    将缺失片段按顺序组织成目标文本
    编码破坏输入,解码目标,计算条件生成损失
下游:
    添加任务前缀并把标签或答案转换成文本
    按选定迁移策略训练
    解码并按任务规则还原预测,再使用原任务指标
分类教学例子中,输出“positive”本身只是标签编码。若换成无意义标记,只要训练映射一致,模型仍可学习;自然语言标签可能提供额外先验,但这需要控制实验,不能仅凭词义直觉判断。
四、在相同文本和计算口径下读架构及span实验
不能因为训练统一,就把 GLUE、翻译 BLEU 与摘要 ROUGE 混成一个没有定义的总准确率。
| 项目 | 原文范围 |
|---|---|
| 数据 | C4 及不同预训练语料/数据量比较 |
| 架构 | 编码解码与其他架构控制研究 |
| 目标 | 语言建模、去噪、不同破坏方式与span长度 |
| 迁移 | 微调、多任务等策略,按实验单独控制 |
| 任务 | 理解、问答、翻译、摘要等统一文本接口 |
| 不确定性 | 表1 明确基线均值与标准差;不能将其自动套到所有后续模型 |
| 预算 | 小规模受控实验与最终大规模模型分层阅读 |
证据一,统一框架与第 3 节研究设计。固定接口让架构、目标与数据比较更清楚。它是实验组织贡献,不是证明所有任务具有相同统计难度。
证据二,表1。基线均值、标准差与无预训练对照说明不同任务受预训练影响并不相同。某些任务差距大、某些小,反映数据与任务条件,而不是一个恒定迁移收益。
证据三,表7 与第 3.3.5 节。不同平均span长度的效果较接近,较长片段在部分任务略差;作者强调不同目标造成的序列长度和速度差异。这支持同时比较质量与计算,不能只追逐一个微小分数差。
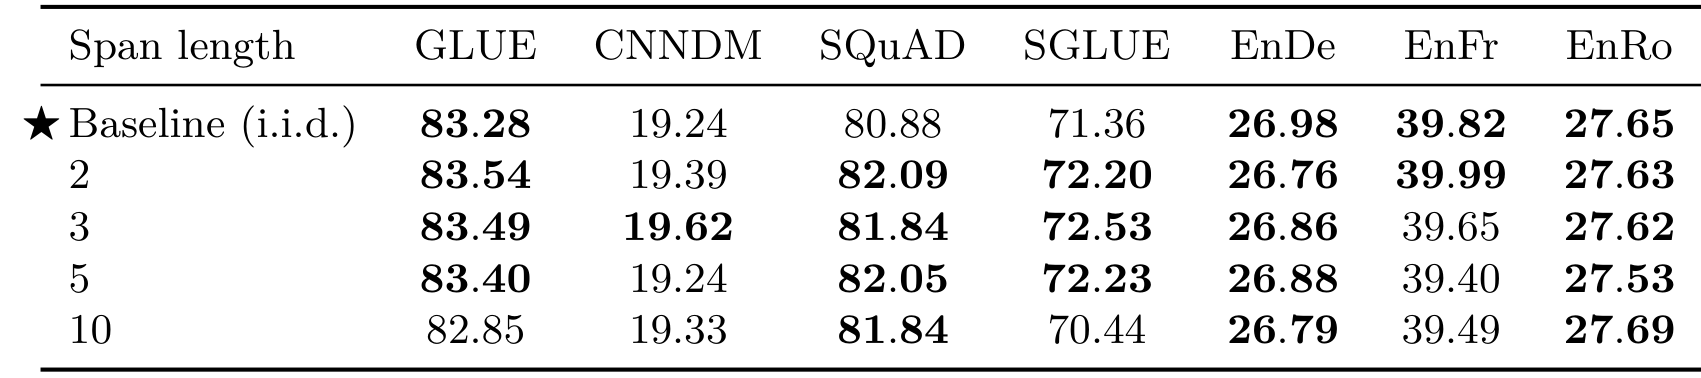
论文最后扩展模型和训练规模,成绩包含多种有效选择。不能拿最终大模型对小基线的差距,声称某一个哨兵设计带来了全部提升。长论文的受控研究与最终配方应分开引用。
同样步数下,不同破坏目标可能有不同输入输出 token 总量,因而计算不同。若只固定 batch 条数,质量更高可能来自更多有效监督或更长计算。应记录编码和解码长度,比较相同计算或相同原始文本覆盖下的结果。
数据清洗同样需要完整说明。删除重复、模板或不符合规则的页面可能改善质量,也可能改变领域分布。评价某种清洗的收益,应查看任务分组,而不是只报告整体更好并忽略被削弱的内容类型。
五、统一生成格式仍有标签、结构约束与数据偏差
与重建整句相比,只生成缺失部分减少目标长度,但也改变监督位置:已知片段不直接在目标中重复。若任务需要学习完整文本流畅生成,去噪形式与下游仍有差异,因此不能说压缩目标永远无损。
T5 将通用迁移学习的多种选择放在一致平台上,推动文本到文本成为常用接口。限制包括编码解码成本、任务格式依赖、数据偏差和昂贵规模扩展。统一接口也可能把数值或结构化任务的精确约束变成生成错误,需要额外验证。
统一生成标签还引入解码空间问题。一个三类分类任务可以限制只在三个合法标签中打分,也可以自由生成后再解析;前者不会输出非法标签,后者可能产生同义词或额外解释。两种评价并不等价,应在实验中固定。若模型生成正确语义却字符串不合法,错误属于接口或解码协议,不能简单归为完全不懂任务。
六、把本篇机制再推进一步
1. 分类时自由生成标签与只给合法标签打分,可以直接比较吗?
参考答案:需要分开记录。前者可能输出近义词或额外解释而被解析为错,后者先限制了答案空间。即便语义判断相近,两种接口的错误类型和计算不同;应固定映射、解码与判分,再讨论预训练目标优劣。
七、继续比较指令任务混合与模板稳健性
统一文本接口后,数据任务混合和提示表达仍影响迁移。FLAN与T0继续研究指令与多模板监督;可沿哨兵例子的做法,逐项检查输入、目标和留出条件是否真的一致。
自测与参考答案
1. 所有任务写成文本,是否意味着不用任务监督?
不是。监督标签只是转换为文本输出,来源仍然存在。统一的是接口与损失形式,数据获取成本和任务定义并未消失。
2. 为什么不同去噪目标应比较输入输出长度?
它们决定编码和解码计算,以及每步监督量。相同步数不一定等计算,较短目标可能在质量接近时更便宜。
3. 哨兵为什么需要区分不同缺口?
它建立输入缺口与输出片段的对应关系,帮助解码器按顺序恢复。如果所有标记不可区分,多个缺口的目标组织会更含糊。