028|BART:用双向编码器读破坏文本,用因果解码器恢复原文
论文:Mike Lewis 等,BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension,2019 年预印本、ACL 2020。原文 · PDF。重点是去噪编码解码预训练及目标比较,不把摘要指标直接解释为事实忠实度。
先接住前作的问题
BERT训练双向编码,GPT训练因果输出;两者留下如何在一个预训练接口中结合的问题。本篇组合编码器与解码器,以损坏文本为条件恢复全文;与T5只生成缺失片段的常用目标是同期平行比较,监督长度不同。
五个前置概念
五个前置概念是去噪自编码、编码解码、文本填充、教师强制与ROUGE。理解这些即可比较 BART、BERT 和 T5 的监督位置与执行成本,而不只凭它们都有 Transformer 判为相同。
一、问题设定:双向读取与因果生成怎样放在同一去噪任务里
编码器可合法读取完整损坏输入,解码器则只能读取已给定的目标前缀,两种方向并不矛盾。问题是用怎样的破坏把它们连接起来:让双向编码帮助自回归恢复全文,同时避免未来目标原文泄漏到解码器。
与 MLM 只在选中位置输出词相比,BART 解码完整原文,训练了更直接的序列生成接口。与 T5 常用只输出缺失片段的目标相比,它承担更长的重建输出。差异影响监督和计算,不应仅以“都是去噪”忽略。
二、用噪声分布区分遮盖、删除与片段填充
设原文为 ,噪声函数为 :
编码器双向处理 ,解码器在训练时用真实目标前缀,推理时用自己的输出。噪声函数确定预训练任务,网络负责学习恢复。原文比较多种破坏组合,不是所有噪声都同时无条件启用。
文本填充抽取连续片段并用单个 MASK 替换,使模型还要推断缺口长度;句序打乱改变文档组织。二者组合在摘要相关实验中有用,但句序打乱单独使用在部分表格中明显较差,不能当作通用增强总是有效。
下游生成直接微调条件序列模型;分类或抽取可以使用适当位置表示和输出层。模型既有编码器也有解码器,比较参数和计算时应包含两部分,而非只看单侧层数。
噪声分布决定模型必须学习什么
目标可写为 ,其中 从训练语料分布取样, 是人为选择的破坏过程, 为损坏输入, 是参数为 的重建模型。遮盖保留缺口位置;删除要求推断内容与缺失位置;句子打乱要求恢复篇章次序。编码器双向读的是损坏输入,解码器因果读的是原文前缀,两种可见性并不矛盾。改变q会改变预训练技能分布,不是无关紧要的数据增强开关。
教学算例。 原文“A B C D”,逐token遮盖B、C得到“A MASK MASK D”,泄露缺失长度2;span infilling得到“A MASK D”,解码器还得判断应补几个token;删除则是“A D”,连缺口标记都没有。三种输入可通向同一正确输出,训练难度却不同。全文重建还会为已见A和D计算输出损失,区别于只预测缺口的T5。
原文“昨天小猫安静地坐在门口”,遮盖某词为 MASK 会保留缺失位置;直接删除会让模型连少了多少内容都不确定。片段填充进一步允许一个 MASK 对应多个词。恢复任务因此不仅是选词,还涉及长度和结构。
用同一缺口比较输入长度的变化
若连续三词被压成一个mask,编码器输入少两个位置,而解码器仍要恢复三个词;若三个词各留一个mask,输入暴露了被删长度。两种破坏即使遮住相同内容,也给出不同条件信息。对照噪声方案时,应同时记录被遮比例、缺口长度分布和破坏后输入长度。
三、编码损坏输入,按正确前缀重建完整原文
从语料抽取原文 x
按选定噪声方案产生 corrupted_x
encoder_states ← 双向编码器(corrupted_x)
decoder_states ← 因果解码器(移位的原文, encoder_states)
loss ← 原文每个目标token的交叉熵之和
更新全部预训练参数
下游按摘要、问答或分类接口微调
生成任务使用约定搜索和长度规则评价
四、先读噪声对照,再检查摘要与理解成绩
低重建损失不能直接证明模型会在摘要中只陈述源文支持的事实。
噪声图解释接口,受控表1检验选择;最终大模型摘要成绩另外包含训练配方。
| 项目 | 原文范围 |
|---|---|
| 受控比较 | 同等相近规模、1M步下比较多个预训练目标 |
| 噪声 | token遮盖、删除、text infilling、句序打乱、文档旋转 |
| 任务 | SQuAD、MNLI、ELI5、摘要、对话等 |
| 最终大模型 | 更多预训练配方与数据,和base目标研究分开 |
| 指标 | 理解任务F1/准确率、生成PPL以及摘要ROUGE |
| 成本 | 编码破坏输入并解码完整原文,长度直接影响开销 |
| 不确定性 | 未给所有目标统一多种子区间,微小差异需谨慎解释 |
证据一,方法与噪声图。不同破坏方式对应不同恢复问题,说明框架灵活性。可支持任意噪声不代表任意噪声都适合任务。
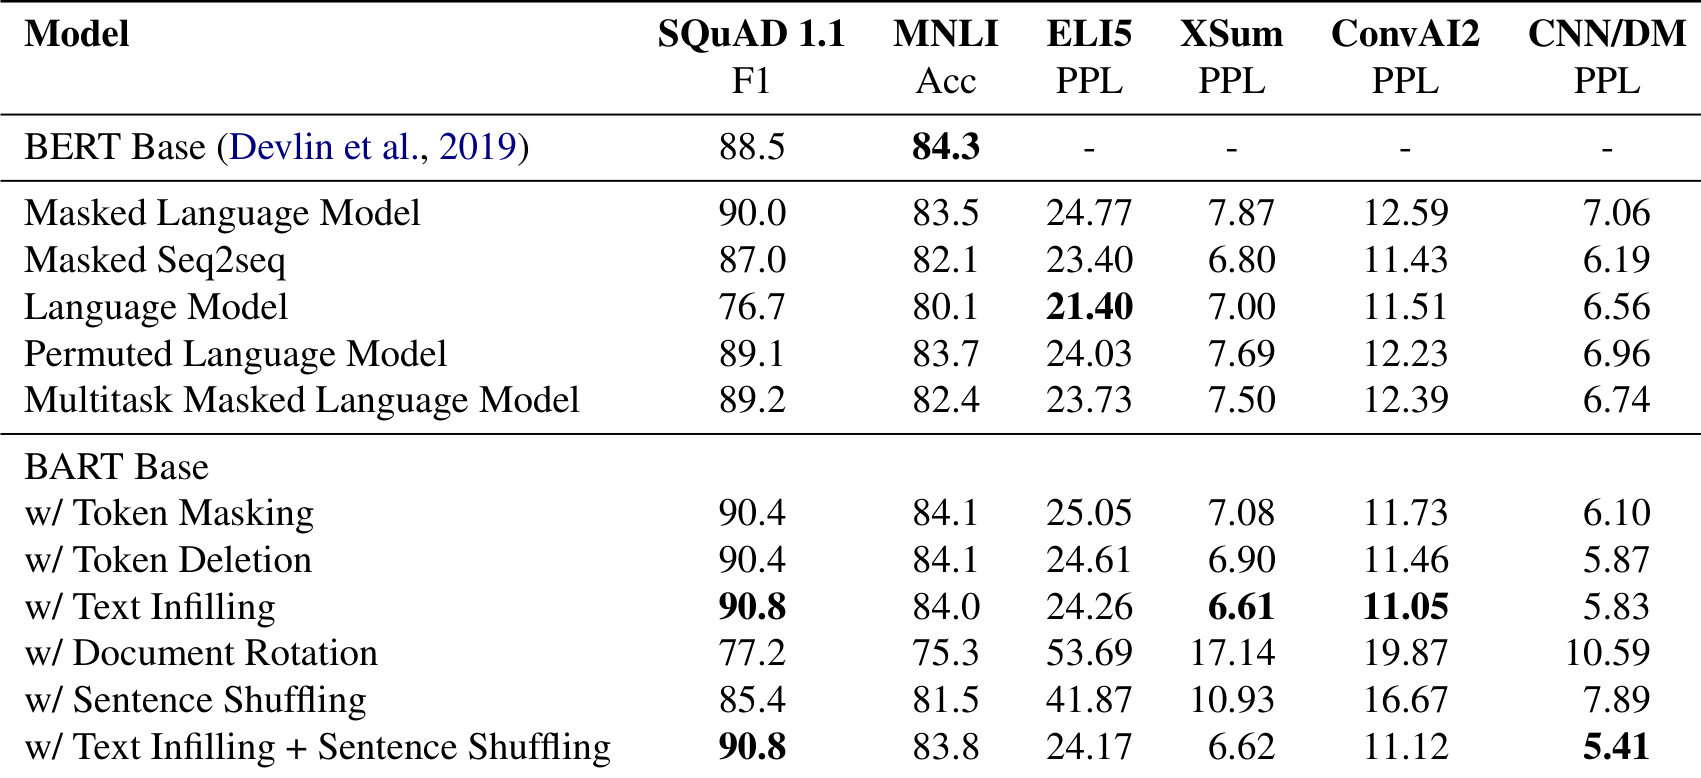
证据二,表1。SQuAD 中 text infilling 达到 90.8 F1,而 document rotation 为 77.2;生成任务的各类 PPL 也不一致。该表直接说明噪声方案是实质设计,而不是可随意替换的训练装饰。
证据三,表2、表3。大模型在理解任务保持竞争力,摘要表中 XSum ROUGE-1 为 45.14、ROUGE-2 为 22.27、ROUGE-L 为 37.25。它支持摘要词面重叠质量,不是事实一致性的独立验证。
原文最终训练还包含关闭末段 dropout 等安排。若只复现目标却忽略优化配方,不能期待完全相同分数;反过来,也不能把所有最终收益都归因于文本填充。
两个摘要可能共享很多参考词,但实体、数量或否定关系不同。ROUGE 对词面重叠有用,却可能漏掉这种错误。更完整的实验应检查源文支持、信息覆盖和人工偏好,并记录生成长度。
搜索策略也影响摘要。较长输出可能获得更多重叠,却更冗余;长度惩罚和重复约束改变结果。模型与解码协议共同定义被评价系统,不能只报告检查点名称。
五、全文重建不保证摘要忠实,ROUGE也不够
如果破坏太轻,模型可以大量复制输入,学习压力有限;破坏太重,则很多答案无法由剩余文本唯一推断。适度破坏在可学性和挑战之间折中,但最佳比例依数据和下游任务决定。
摘要时,输入是完整文章,目标是较短摘要,与恢复原文仍不同。预训练提供语言与重组能力,下游监督再教会压缩。没有机制保证摘要不混合或捏造事实,因此需要事实性评估。
限制包括长重建目标成本、噪声任务与下游差异、教师强制分布偏移和事实性缺口。它没有因重建原文而自动学会可靠压缩或验证。
一个有价值的自构消融是固定总编码加解码token预算,而非固定样本条数,比较完整重建与只恢复缺失片段。前者监督更多已知文本,后者可能把预算集中到困难位置。观察生成任务、抽取任务和训练时间,可以判断额外重建是在提供信息还是重复容易预测的内容,而不是只凭目标名称作结论。
六、把本篇机制再推进一步
1. 完整重建比只生成缺失片段多监督位置,是否就更数据高效?
参考答案:未必。额外位置可能提供有用生成监督,也可能主要重复容易复制的已见内容。应固定总编码加解码token预算,再比较生成、抽取和时间;只固定样本条数会让更长目标获得更多计算,无法隔离监督方式。
七、从去噪生成器接到外部检索
编码—解码去噪为任务提供通用初始化,但视觉输入仍不在接口里。Prefix-Tuning可用来比较冻结骨干的任务适配;Flamingo则展示连接外部视觉表示的另一种模块组合。
自测与参考答案
1. BART 与 BERT 的主要预训练输出有何不同?
BART 用因果解码器恢复完整原文,BERT主要在选中位置预测原词。二者监督位置、输出长度与生成接口不同。
2. 为什么删除比逐词MASK更难?
删除不显式保留每个缺失位置,模型需要推断内容和数量。更难可能促使结构学习,也可能丢失过多信息,因此不能假定总有益。
3. 摘要ROUGE提高是否证明更少幻觉?
不能。词面重叠可以提高而事实关系仍错误。需要源文一致性、实体数量和人工评价等独立证据。