044 · Prefix-Tuning:把任务知识放进每层的虚拟上下文
返回目录 · 上一篇:CLIP · 下一篇:Prompt Tuning
论文:Xiang Lisa Li、Percy Liang,Prefix-Tuning: Optimizing Continuous Prompts for Generation,2021。原始论文。
先接住前作的问题
GPT与BART通过微调迁移生成任务,却需要为每任务保存大量变化。本篇提供平行的冻结骨干方案:学习各层前缀状态,改变可读取上下文而非主权重。Prompt Tuning随后研究更受约束的输入层接口。
五个前置概念
五个前置概念:条件生成用输入约束输出分布;教师强制用真实历史token训练下一步;KV缓存保存注意力可读取的键和值;参数冻结禁止更新权重但不必阻断输入梯度;重参数化通过另一组变量生成实际被使用的参数,以改善优化。
一、问题设定:冻结生成模型时,逐层连续状态能承担多少任务适配
输入 可以是线性化表格或新闻,输出 是描述或摘要。任务仍用目标序列似然训练、按终止符和解码限制结束;问题是能否共享GPT-2或BART主干,只为每个任务学习一小段逐层连续控制状态。
全量微调更新预训练参数 ,每个任务都需要独立权重。Adapter只添加较小模块,但模块仍嵌入计算路径。Prefix-Tuning选择另一种控制位置:让输入与输出token都能够注意到一组可学习的“历史状态”。它沿用主模型的注意力、前馈层和语言建模输出头,改变可训练参数及条件信息的提供方式。
关键假设是预训练模型已经具有足够生成能力,小规模连续控制就能调用这些能力。冻结权重可能减少小数据过拟合,但也可能限制对新任务的改造幅度;这是需要实验判定的取舍,不是先验保证。
二、把前缀写成各层可读取的键和值
对自回归模型,设 是包含各层前缀状态的矩阵,普通位置的隐状态仍由冻结网络产生:
这里的 汇总各层状态;在实现注意力缓存的视角下,前缀提供每层的key/value。它不是仅在最底层加几个可训练词向量:后者的高层状态仍完全受冻结模型映射约束,论文把它作为较弱的消融。
一种便于理解的单层表达为:
是前缀, 是正常上下文,分号表示沿序列维拼接。后续词既可读取真实输入,也可读取任务前缀。这个表达说明控制如何进入注意力,并非把论文所有编码器、解码器接口压成完全相同的实现。
目标仍是:
§4还使用较小向量经过MLP生成完整前缀的重参数化以利优化。训练后可以只保存生成出的前缀并去掉MLP。因此训练期间参与优化的参数与最终每任务存储量要分别计算,不能只拿部署前缀大小推算训练内存。
前缀改变每一层可读取的记忆
对某层真实查询Q,键值扩为 、,其中下标 表示前缀产生的键和值,下标 表示真实输入的键和值,分号表示沿序列维拼接;前缀 提供可训练的连续状态,语言模型权重冻结。真实token的损失仍需经过冻结网络反传到P;冻结权重不等于关闭整个计算图。原文用小矩阵经MLP重参数化前缀改善训练,训练后可保存生成的前缀状态,因此训练参数和部署保存参数也需分别统计。
教学算例。 假设12层、每层总键和值宽度均768、前缀长20,直接保存全层KV需要 个数;若只训练输入层20个768维向量,则仅15360个,但约束也更强。两者不能只用“20个软token”概括。前缀还增加每步注意力读取量。
自构例子: 输入为“店名=青禾;菜系=川菜;价格=中等”。两个任务共享GPT-2:一个前缀学到简短介绍,另一个学到只列菜系和价格。前缀不应储存每家店的事实,而应改变如何使用当前表格。若输出捏造“可停车”,说明调节生成风格没有保证事实约束,需在评价中单独检查槽位覆盖和错误添加。
逐层前缀不必对应同一串可读词
输入层词嵌入必须经过主干才能产生各层K/V;逐层前缀则直接提供各层可读取的连续状态。即使前缀长度相同,两者可控制的中间量也不同。检查任务增量时应逐层列出前缀张量,而不是把所有状态当成一份输入词表向量,更不能以“没有真实token”推出它不占注意力读取成本。
教法联系:Sourab Mangrulkar、Sayak Paul的Parameter-Efficient Fine-Tuning。算例为本文自构。
三、经冻结网络反传到前缀,并区分训练与部署参数
输入:预训练模型 φ、训练对 (x,y)、前缀长度 m
冻结 φ,初始化前缀生成参数 θ
重复:
  P = MLPθ(较小前缀表示)
  为所需注意力层构造前缀 K/V
  将前缀与输入状态组合,教师强制预测 y
  loss = 目标 token 的负对数似然
  梯度穿过冻结网络,但只更新 θ
训练完成后保存 P;推理时加载同一 φ 与任务 P
输出:按指定 beam search 解码的描述或摘要
冻结网络并不意味着可以把所有前向过程都放在无梯度模式中:损失必须经网络传回前缀。节省主要来自任务参数、梯度与优化器状态,而不是把大模型的运算全部删掉。
四、对照表格生成、摘要和输入层提示消融
先按任务拆开收益和损失,再看已见/未见类别与前缀长度,避免把0.1%参数结论推广到全部生成任务。
| 项目 | 原文设置 |
|---|---|
| 表格生成数据 | §5.1,E2E约50K样例、WebNLG约22K、DART约82K;这些是论文的数据集规模口径 |
| 摘要数据 | XSUM约225K,BART-large;输入截断至512个BPE token |
| 主对照 | 全量微调、只调顶部两层、Adapter;0.1% Adapter用于接近参数预算比较 |
| 前缀训练配方 | 表5,E2E为5 epoch/批量10/长度5;WebNLG为5 epoch/批量5/长度5;DART为10 epoch/批量5/长度10 |
| 摘要配方 | 表5,30 epoch、批量14、前缀长度100、学习率5×10⁻⁵ |
| 墙钟报告 | §5.3,22K样例每epoch前缀约0.2小时、全量约0.3小时;指定TITAN硬件上的局部结果 |
| 解码 | 表格任务beam=5;摘要beam=6并使用长度归一化 |
| 低数据与泛化 | 抽取小训练集并用开发集选参;WebNLG训练9类、测试另5类,XSUM另构造主题变化划分 |
不同方法表5的epoch、批量和学习率并不完全相同,不能把主表称为逐步数、逐算力严格等预算试验。BLEU和ROUGE衡量与参考文本的匹配,不能单独证明没有漏写或幻觉;附录的定性实例也提示这两种失败仍存在。
证据一:表1,GPT-2 medium表格生成。 E2E BLEU全量微调68.2,Prefix为69.7,差1.5分;WebNLG总体BLEU为46.5对55.1。更值得拆分的是已见类别64.2对62.9,未见类别27.7对45.6:总体优势主要不能解释为训练分布内一律更好。0.1% Adapter的E2E为66.3,说明放置可训练自由度的位置也重要。
证据二:表2,XSUM摘要。 全量ROUGE-L为37.25,2%前缀为36.05,0.1%前缀为35.05。对应绝对下降1.20和2.20分。作者讨论任务复杂度与数据量可能影响结果,但这些因素没有被完全独立控制,不能说已经证明“摘要需要多少参数”的普遍规律。
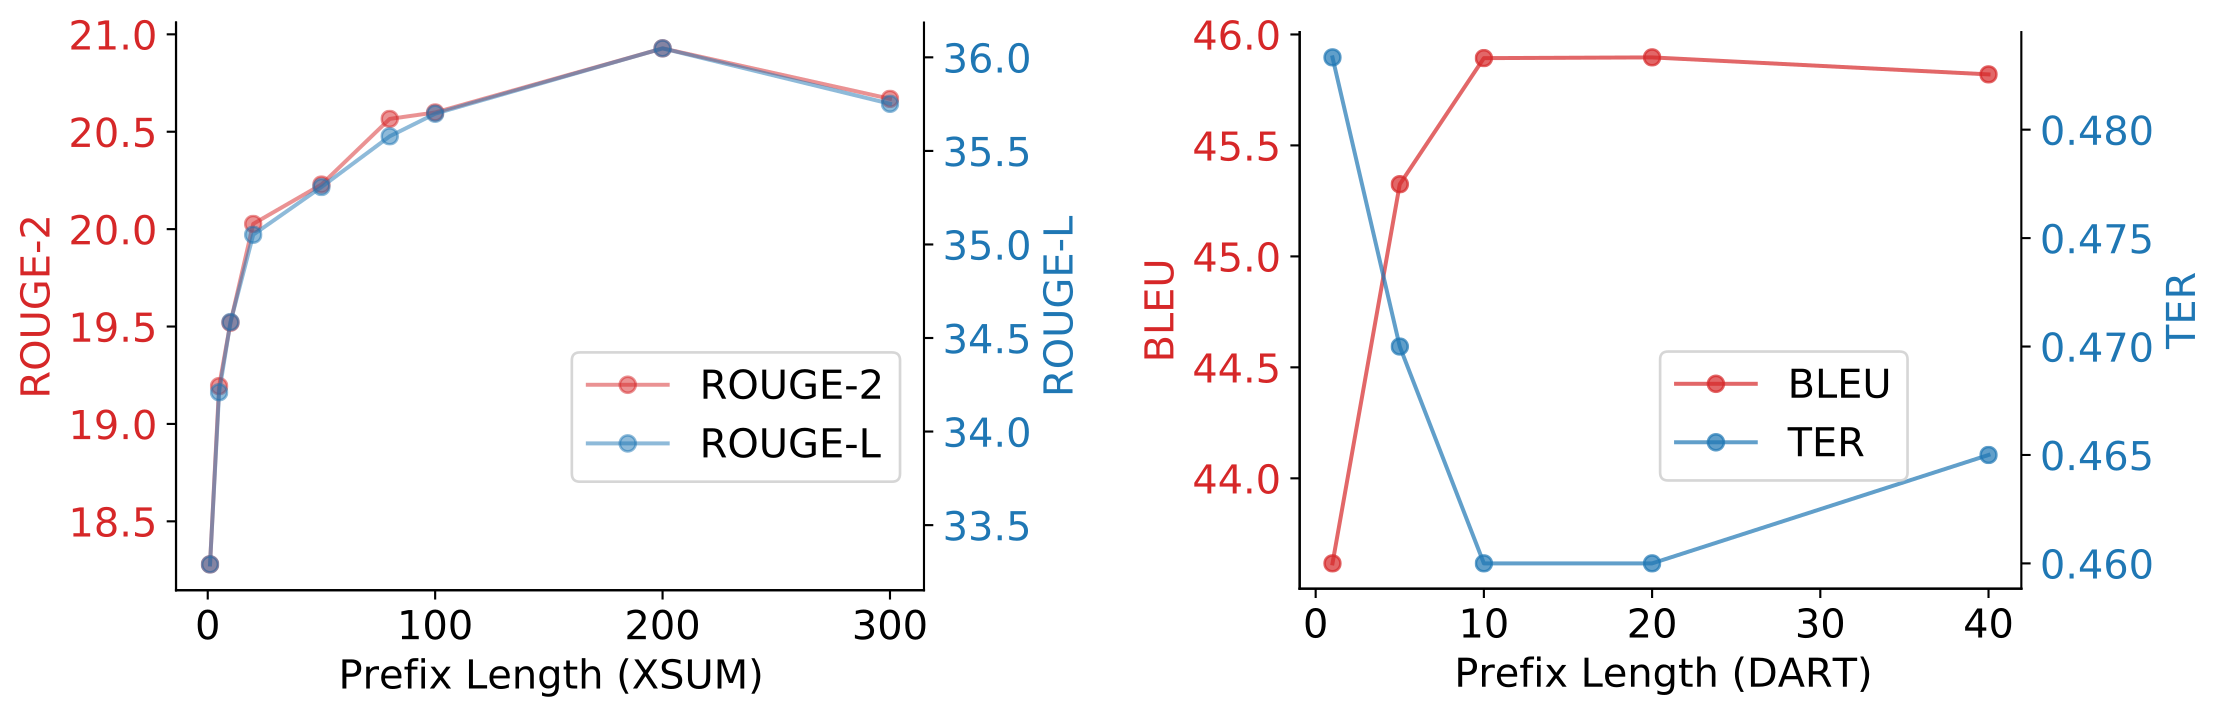
证据三:表4与图4,结构消融。 E2E完整前缀BLEU69.7,仅调10个输入嵌入为62.2。图4显示前缀长度增加到一定程度后测试表现略降,即使训练损失更低。支持逐层干预和容量选择在这些配置中重要;不能据此断言输入层提示在更大模型上永远无效,下一篇恰好研究这一规模条件。 前缀长度图的两种指标使用两条纵轴;同一曲线内看长度变化,不能直接比较两条曲线的高度来判断指标谁更好。
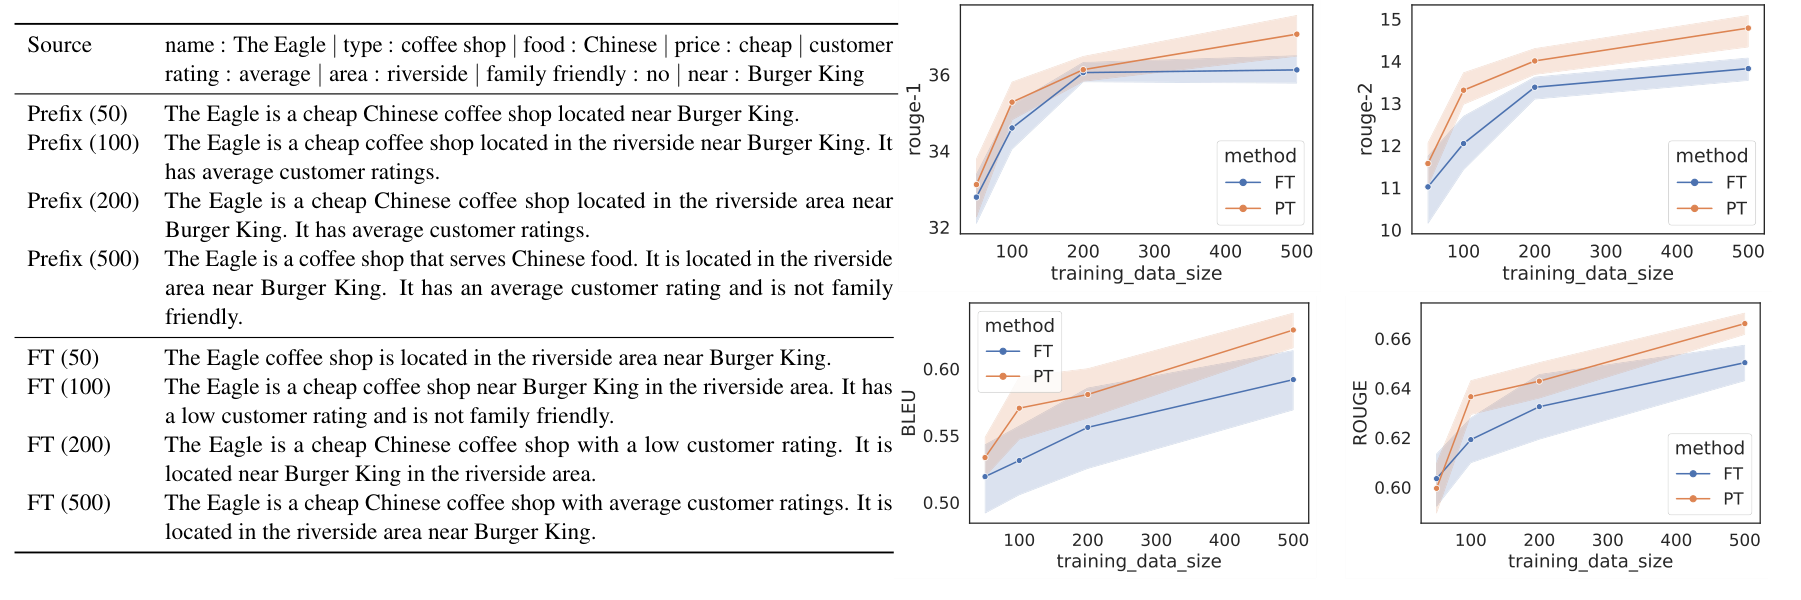
证据四:图3、表3与附录A.4。 小数据曲线偏向前缀;XSUM新闻到体育的ROUGE-L为31.51,全量为30.26。外推改善有真实主题划分依据,但附录指出前缀仍会遗漏表格内容,全量微调则常出现不符事实的生成。高自动指标并不能消除这两类风险。
五、前缀长度与受限表达会影响质量和读取成本
新意是把任务适配变成可学习的逐层条件状态,而不是换一种输出损失。作者提出的保留预训练参数有利外推,是与实验相符的解释;参数冻结、参数数量和优化路径同时变化,尚不能把收益完全归于单一原因。
六、比较输入提示与低秩权重改动
逐层前缀之外,Prompt Tuning把可训练入口限制到输入层,LoRA则改变权重方向。可固定任务和预算比较控制位置,避免把不同表达能力混成一个参数百分比。
自测与答案
1. Prefix-Tuning和只学习几个输入词向量为什么不相同?
输入向量只能经冻结层逐层传播;Prefix-Tuning直接为多层注意力提供可训练上下文,拥有不同的控制自由度。表4在GPT-2表格生成上显示差异,但不构成所有规模和任务上的优劣定理。
2. 可训练参数只有0.1%,训练就会快1000倍吗?
不会。大模型仍需前向计算,且需要将梯度传到前缀。0.1%还涉及任务参数的统计口径,重参数化训练模块与最终存储不同。论文局部计时是每epoch约0.3小时到0.2小时,远非千倍。
3. 怎么判断前缀在WebNLG上改善的是记忆还是泛化?
分开看训练出现的9类和未出现的5类,而不是只看总体。medium结果已见类别略降、未见类别明显上升,支持该类别变化下的外推收益。仍需检查类别难度、内容覆盖和事实错误,不能把这一个划分推广为任意领域迁移。