045 · Prompt Tuning:模型越大,任务接口能否越小
返回目录 · 上一篇:Prefix-Tuning · 下一篇:RoFormer
论文:Brian Lester、Rami Al-Rfou、Noah Constant,The Power of Scale for Parameter-Efficient Prompt Tuning,2021。原始论文。
先接住前作的问题
Prefix-Tuning在多层提供连续前缀,本篇把同类控制进一步限制在T5输入端。未解问题是这种限制在大骨干上是否仍足够,而不是更小接口天然优于逐层干预。它仍用任务标签训练提示,区别于few-shot推理。
五个前置概念
五个前置概念:软提示是可训练连续向量;标签词把分类标签转成生成目标;LM adaptation改变共享模型的生成习惯;领域迁移在输入分布变化后评估同类任务;集成结合不同预测以减少部分误差。它们分别对应参数接口、输出接口、准备阶段、评估条件与推理策略。
一、问题设定:只改输入嵌入,任务适配差距怎样随模型规模改变
多个任务共享一般语言能力,却因全量微调保存多套权重。只在输入前学习小矩阵可降低任务切换与存储成本;本篇要检验随着骨干变大,这一受限入口与全量微调的质量差距如何变化,并计入共享模型适配的训练。
论文以T5的text-to-text接口处理分类、问答等任务。输入是文本,输出可以是“蕴含”等标签词,也可以是答案片段。训练监督是正确目标序列,没有强化学习环境、奖励模型或策略优化。通过把类别变成文本,论文不需要为每个分类任务另学输出头。
需要特别区分三件事:人工提示在词表中选离散token;Prompt Tuning直接优化连续嵌入;Prefix-Tuning还在中间层加入可训练状态。这些方法的参数自由度不同,却不能只按自由度多少断言质量高低,因为基础模型本身决定输入控制能够传播多远。
二、推导软提示梯度怎样穿过冻结主干
设输入有 个token,嵌入维度为 ,冻结词嵌入得到 。学习 个软提示向量 ,把 输入T5编码器:
为任务训练集, 包含所有原模型权重。只有 个任务参数。提示不必等于任何真实词的嵌入,不能假定训练后可无损翻译成一句人类指令。
论文还有一个容易漏掉的前置阶段。T5.1.1原先做片段恢复,习惯输出哨兵token;冻结后很难单靠提示改掉这种输出偏好。因此作者比较直接使用原模型、给任务答案添加哨兵,以及先做额外的自然文本续写式LM adaptation。默认配方采用最后一种,主模型在这个共享适配阶段会更新,之后才冻结以训练各任务提示。
只有输入可训练,梯度仍经过整个模型
设软提示矩阵为 、固定输入为 ,冻结模型输出为 ,目标损失为 。将张量展平后,; 是模型输出对提示的 Jacobian, 为冻结权重。冻结 只取消参数更新,不取消把下游误差传回提示的需要。由输入影响深层特征,是该方法的强约束;模型规模更大可能提供更丰富的可调用特征,但这是经验解释,不是仅凭参数量推导的定理。
自构例子: 同一个冻结模型服务“情感判断”和“文本蕴含”。每个请求前拼接各自100个向量;假设嵌入维度为1024,每任务增加102400个数。这个数是教学计算,不是论文所有T5规格的参数量。两任务可放同一批次共享权重,但序列变长,注意力开销仍存在。如果每条都要五提示投票,工作量也高于单提示。
共享主干的两条任务在batch里怎样共存
设任务甲和乙各有5个可训练提示位置,真实输入长度分别为12和20。合批后可补齐张量,但padding位置应被正确掩蔽,两个样本分别读取自己的提示矩阵;共享的是主干权重,不是把甲的提示拼到乙的上下文里。小检查点节省存储,也仍需保留任务标识与提示加载关系。
教法联系:Sourab Mangrulkar、Sayak Paul的Parameter-Efficient Fine-Tuning。算例为本文自构。
三、记录共享LM适配、任务提示和批处理接口
输入:T5.1.1、无监督自然文本、某任务标注集
共享准备:
  按论文默认设置做 100K 步 LM adaptation
  固定得到的模型 θ,供多个任务复用
每任务训练:
  初始化 100 个软提示向量 P
  把标签词嵌入用于部分初始化,其余从词表采样
  对训练样本嵌入 X,拼接 [P; X]
  用教师强制计算目标序列交叉熵
  反向传播到 P,只更新 P
  按开发集指标选择检查点
部署:加载共享 θ 与目标任务 P,正常生成标签或答案
数学损失并未改成新的任务目标;算法机制是训练变量与输入条件的改变;衡量收益则要同时看任务分数、任务参数量、共享准备成本和推理吞吐。减少20,000倍任务参数,不意味着计算量或训练时间也减少20,000倍。
教学算例。 提示长100、嵌入宽度1024时,只增加102400个可训练数。相对于十亿参数约为0.01024%,但训练仍要运行十亿参数骨干。若两任务各存一份prompt,切换时只换小矩阵;若要同时批处理,两条样本必须使用各自提示并正确处理padding,不能把它们混成共享提示。
四、结合规模误差条、迁移方向和集成成本读结果
规模曲线属于特定T5配方;误差条、领域迁移的反向退步和五提示集成各有独立分母。
| 维度 | 原文设置及证据意义 |
|---|---|
| 基础模型 | T5.1.1从Small到XXL,最大约11B;并非只在一个规模下试验 |
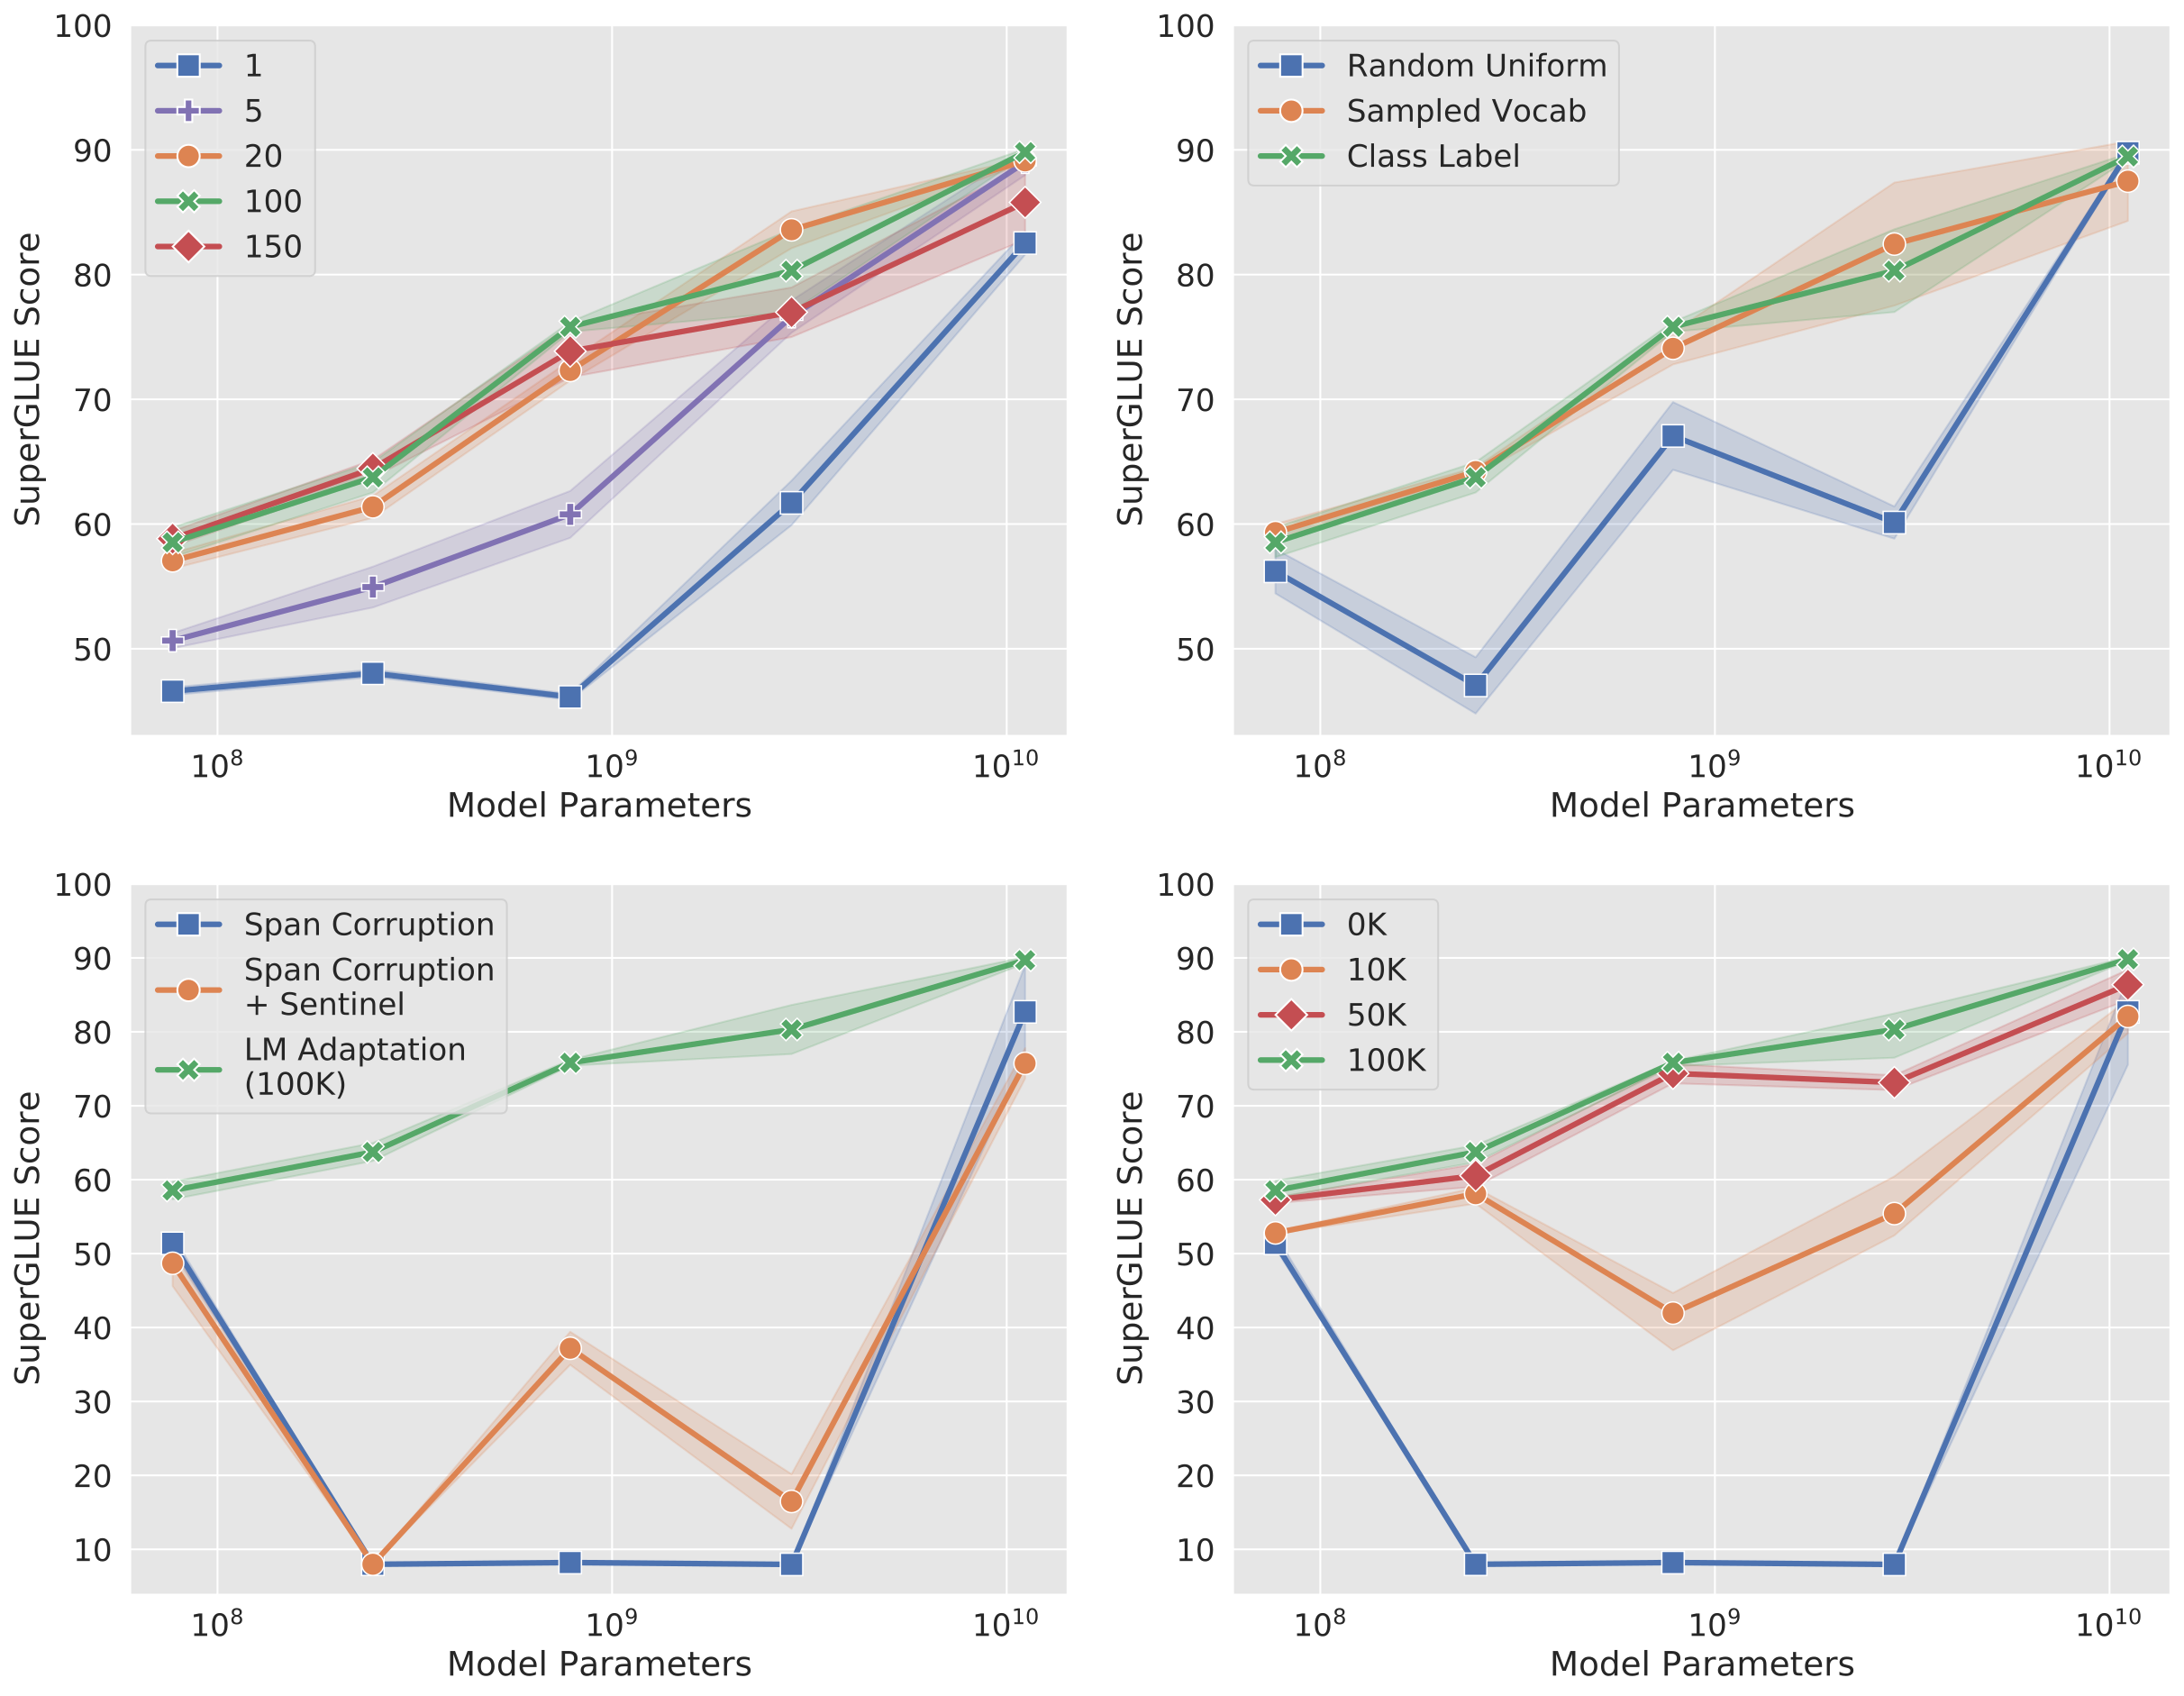
| 共享准备 | 默认100K步LM adaptation;图3单独比较适配步数和预训练目标 |
| 每任务训练 | 30,000步,批量32,恒定学习率0.3,Adafactor;开发集早停选检查点 |
| 提示设置 | 默认100个向量、类别标签初始化;消融长度1、5、20、100、150 |
| 任务数据 | SuperGLUE八个任务分别训练,未混合;表7如BoolQ训练9427、CB250、ReCoRD100730 |
| 对照 | 单任务全量微调、多任务全量微调,以及引用的GPT-3人工few-shot结果 |
| 硬件 | 附录A,Small/Base用4块TPU v2芯片,较大模型用16块TPU v3芯片 |
| 重复与调参 | 主配置和消融各3次,报告均值与标准差;77次搜索试验中提示40次、单任务全量37次 |
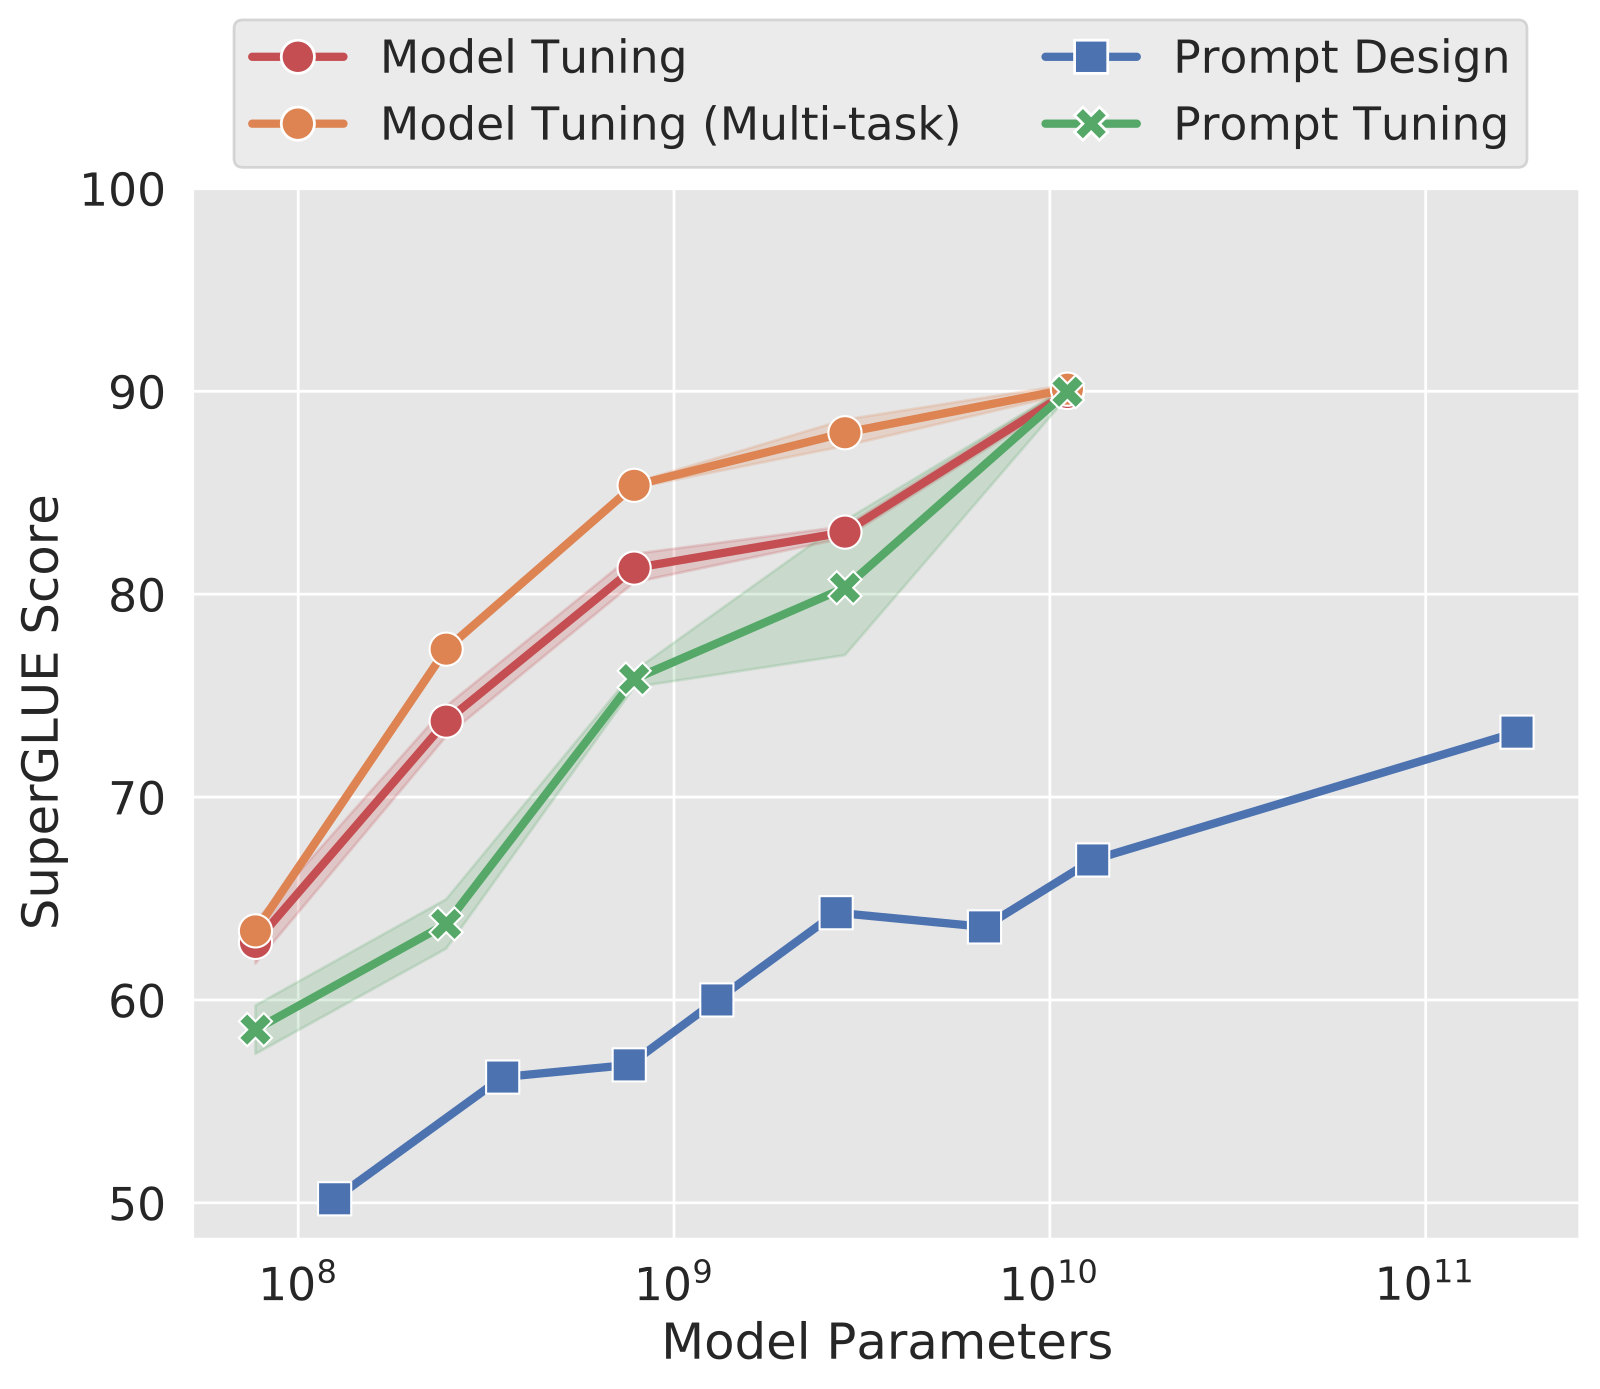
主结果使用开发集,且该集合也参与早停和选参,因此不能把它写成从未用于任何选择的最终隐藏测试结果。多任务基线还使用混合训练与额外DPR数据;引用GPT-3结果时,任务标注暴露、架构、预训练语料也不同,不能据此声称小T5具有普遍超过大GPT-3的能力。
证据一:图1与§3.1。 随T5变大,Prompt Tuning与全量微调的SuperGLUE差距缩小,XXL接近多任务微调基线,任务参数少超过20,000倍。这里支持的是该模型族的经验趋势,没有证明任意任务、任意预训练目标都随规模自动追平。 规模曲线的误差条来自三次运行;大模型更接近全模型微调,并不表示所有规模、所有任务都已达到相同质量。
证据二:图3。 较小模型对提示长度、初始化、预训练目标更加敏感,XXL对这些选择更稳健;超过约20个提示后的平均收益变小。额外LM adaptation对多数配置有用。实验说明“冻结哪个检查点”与“如何初始化”是方法的一部分,也解释了为何不能直接用前一篇小模型输入嵌入消融否定本篇结果。
证据三:表1,SQuAD训练后的领域迁移。 域内F1全量94.9±0.2、提示94.8±0.1;迁移到TextbookQA时为54.3±3.7和66.8±2.9,提示高12.5分。但DuoRC为68.9对67.7,DROP为68.9对67.1,提示反而下降。冻结限制可能抑制过拟合,是作者解释;表格支持部分迁移改善,未建立全部领域优越的定理。
证据四:表3,五提示集成。 单提示平均SuperGLUE开发分90.5,最佳单提示91.0,五提示多数投票91.3。相对平均提升0.8分,相对最佳提升0.3分,两个比较不能混写。共享主干减少模型副本存储,多提示可批处理,但仍对每个样本执行多个提示条件的计算,不能描述为单提示同等FLOPs。
表2还显示迁移方向的不对称:QQP到MRPC的F1从81.2提高到84.3,反向从70.9降到69.7。哪种数据覆盖哪种任务关系,会影响“冻结更泛化”的实际结果。
五、小任务矩阵不保证可读指令或恒定计算
本篇的主要贡献是实证揭示极小任务接口与模型规模之间的联系,并给出共享部署、提示集成和初始化分析。它没有创造新的语言建模损失,也没有证明软提示储存了可读的任务规则。
§7用最近邻词检查提示,能看到一些语义相关词簇,却没有得到连贯可解释指令。最近邻分析只是表示空间的观察:把向量替换成最近真实词会改变实际输入,必须重新测性能才能判断是否保留功能。
六、把输入接口与模块、权重增量放在同一成本账本
输入层控制是否足够依赖骨干规模与任务。LoRA改为可合并权重增量;并读Prefix-Tuning则可检查更多层接口增加了什么表达能力和读取成本。
自测与答案
1. “模型从头到尾冻结”是否准确描述论文默认方法?
不准确。每个任务的提示学习阶段冻结主干,但默认先做100K步LM adaptation,更新共享模型。可把这项成本在多个任务间摊销,却不能在复现预算中省略。
2. 为什么本篇不与Prefix-Tuning的输入嵌入消融矛盾?
两篇测试的模型规模、基础架构、任务和准备阶段不同。本篇研究规模增长后输入层控制是否足够,发现11B模型更有利;前篇只说明其GPT-2生成设置下逐层前缀更强。跨设置结论需要限定条件。
3. 五提示集成只保存一个主模型,能否说推理成本不变?
不能。参数副本存储减少,但同一输入需要在五组提示条件下计算并投票。批处理可能改善硬件利用率,却不能消除额外算术、激活和延迟。应同时测存储、吞吐与每请求延迟。