047 · LoRA:冻结大矩阵,只学习低秩改动
返回目录 · 上一篇:RoFormer · 下一篇:Codex
论文:Edward J. Hu等,LoRA: Low-Rank Adaptation of Large Language Models,2021年公开,ICLR 2022。原始论文。
先接住前作的问题
Adapters增加串行模块,Prefix-Tuning增加可读状态,二者节省任务参数却仍有执行代价。本篇是平行适配路线:在线性权重旁学可合并的低秩增量,追问任务变化是否只需少数方向。
五个前置概念
五个前置概念:矩阵秩衡量独立方向数;低秩分解用两个瘦矩阵表示更新;优化器状态是Adam等为每参数保存的历史统计;参数合并把线性增量提前加入权重;验证集选模选择适配配置而非提供无偏最终测试结论。
一、问题设定:任务改动能否限制在可合并的少数权重方向
全量微调要为原权重保存梯度与优化器状态,adapter增加推理模块,连续提示又占用上下文。LoRA把任务变化放进两个小矩阵的乘积,并可在部署前加回原线性矩阵;节省的是更新表示与任务检查点,完整骨干仍需运行。
论文的任务包括分类、表格描述、文本转SQL和对话摘要,均使用监督任务数据。没有新的RL奖励;LoRA是一种参数化方法,理论上可配合不同训练目标,但原文这些结果不能直接证明它在后来RL对齐中同样好。
原文主要研究注意力投影矩阵,冻结前馈模块。后来常见的“所有线性层都加LoRA”属于具体训练配方的扩展,不能倒灌成原始实验的统一设置。
二、推导低秩增量及非对称零初始化的梯度
设原矩阵 ,定义:
是秩上限, 控制增量尺度。对输入 :
训练参数从 变为 。低秩的是 ,原权重与合并后权重都不必低秩。LoRA也不是先完成全量微调再做SVD,而是从训练开始就在因子化空间优化。
原文将 随机初始化、 初始化为零,使初始增量为零,保留预训练函数。如果两者都设零,链式求导会让两者初始梯度都为零,无法启动这条分支;只将一个因子置零可避免这一问题。
设训练样本为 ,任务损失仍是负对数似然或相应分类损失:
所谓低“内在秩”是对有效更新的经验假设。论文用不同秩及子空间分析支持它在部分任务中的合理性,没有证明所有任务的最优更新都天然低秩。
为什么一边随机、一边为零
令输入为 、输出为 、冻结权重为 ,低秩因子为 ,秩为 、缩放超参数为 ,损失为 。记上游对输出的梯度为 ,,其中 ,则 、。原初始化B=0、A随机使初始增量为零,但B仍能收到非零梯度;若A、B同时置零,两边梯度都为零,支路会卡住。这一对比比笼统说“零初始化更稳定”更能指导实现。
教学算例。 取秩1、。首步 ,B梯度为 ,A梯度为零;更新B后下一步A才通常开始学习。低秩约束落在增量BA上,不表示冻结的 本来低秩。
合并前后用同一输入核对权重方向
设输入列向量为x,低秩支路计算B(Ax),合并矩阵应加BA而不是AB。即使两者在方阵特例下尺寸都合法,数值通常也不同。用非方形A、B做测试更容易暴露顺序错误;再比较合并前后多个输入的输出,才能确认缩放系数与转置约定一起被正确保存。
教法联系:Sourab Mangrulkar、Sayak Paul的Parameter-Efficient Fine-Tuning。算例为本文自构。
三、冻结主权重、训练因子并核对合并结果
输入:预训练模型、目标线性层集合、秩 r、系数 alpha
冻结主模型
每个目标矩阵 W0:初始化 A 为随机值,B 为零
重复抽取任务样本:
  用 W0*x + (alpha/r)*B*(A*x) 进行前向计算
  计算正常任务损失
  反向传播,只更新 A、B 及明确声明的任务参数
按验证集选检查点,保存低秩因子与配置
单任务部署可合并:Wdeploy = W0 + (alpha/r)*B*A
输出:具有任务能力的完整模型,或可加载的任务增量
合并等价基于线性加法,推理时需关闭训练dropout并使用正确缩放与基础权重。若同时服务多个任务,预先合并一个任务并不能自动让同一矩阵处理其他任务;保留分支动态选择会改变性能取舍。
自构例子: 一个1024×1024投影有1048576个参数,秩8的两个因子共16384个参数,约为原矩阵的1/64。若模型只需增强少数与情感判断相关的方向,这种限制可能足够;若需要大幅改造所有语言表示,局部低秩调整可能不够。这里的维度与解释是教学构造,不是论文特定模型测得的有效秩。
四、按参数预算、目标投影与rank分别读对照
先在相同参数预算下看改哪些投影,再看rank;小分数差和跨论文引用不能当作统一单变量胜出。
| 项目 | 原文报告 |
|---|---|
| 模型 | RoBERTa base/large、DeBERTa XXL、GPT-2 medium/large、GPT-3 175B |
| 数据任务 | GLUE理解任务,E2E/WebNLG/DART生成,WikiSQL、MNLI、SAMSum |
| GPT-2训练 | 附录D.3与表11:5 epoch、批量8、AdamW、学习率2×10⁻⁴、预热500步;Q/V秩4,alpha32 |
| GPT-2解码 | 表11:beam10、长度惩罚按数据集设置;不是与所有引用基线完全相同的解码配方 |
| GPT-3训练 | 附录D.4:2 epoch、批量128、权重衰减0.1;长度WikiSQL384、MNLI768、SAMSum2048 |
| 重复报告 | GPT-2为3随机种子均值;175B只给任务典型标准差,而非每行独立误差条 |
| 特殊对照条件 | 表2带†运行匹配Adapter的长度128与初始化口径;其他微调基线可能先经MNLI适配 |
| 数据规模边界 | 任务数据集名称与版本应按原附录锁定;主结果表没有统一逐任务token消费量,不能假装严格等token |
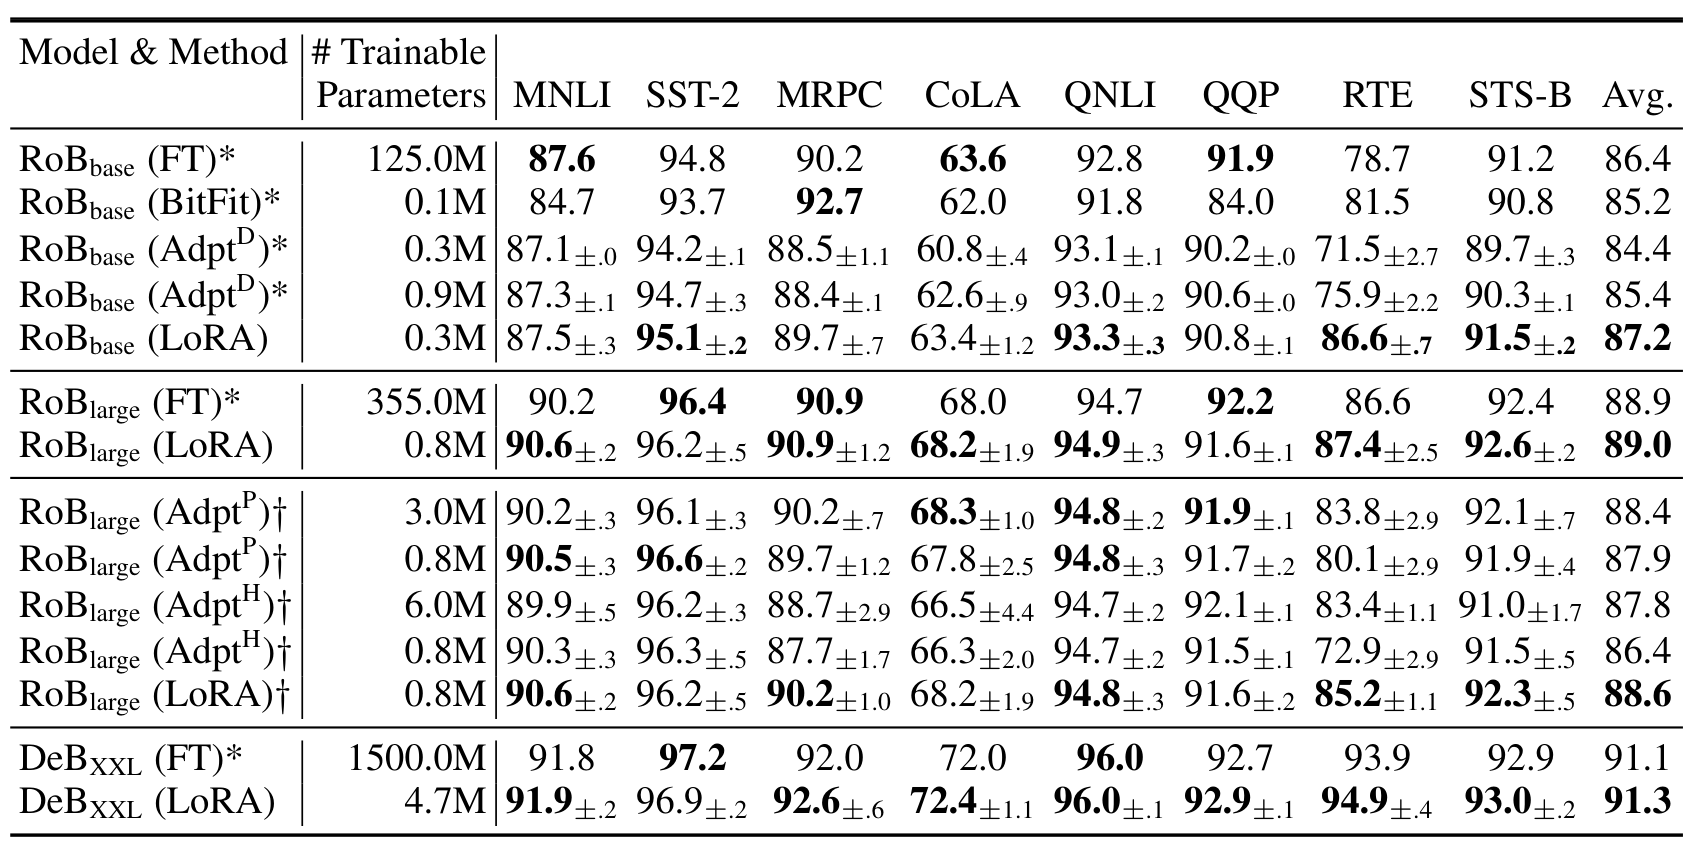
读表2。 先按 RoBERTa-base、RoBERTa-large 和 DeBERTa-XXL 分组,再比较可训练参数与各任务分数。带†的 Adapter 和 LoRA 运行匹配长度128及初始化口径;表内没有用一个平均分消除其他训练条件差异,因此不能把全部行都当作严格单变量对照。
论文报告显存由1.2TB降到350GB、指定配置检查点由350GB降到35MB,并观察到175B训练约25%加速。它们分别衡量训练显存、增量存储和速度,三个倍率不同。35MB任务文件仍依赖大模型,不能独立运行。
证据一:表1,推理延迟。 GPT-2 medium在RTX8000上,批量1、长度128时,全量微调/合并LoRA前向平均19.8毫秒,两个Adapter变体23.9和25.8毫秒,100次计时。支持的是该硬件与形状下合并后的无额外分支开销,不是任何LoRA服务系统都永远零延迟。
证据二:表3,E2E生成。 GPT-2 medium的LoRA用0.35M任务参数达到BLEU70.4±0.1;引用的同参数量逐层前缀为69.7。GPT-2 large的LoRA为70.4±0.1,前缀70.3。后一个差距很小,且部分数据引用前作,不能把它描述为全面压倒性胜利。
证据三:表4,175B任务。 4.7M参数LoRA的MNLI-m为91.7,全量89.5,差2.2个百分点;SAMSum ROUGE-L为45.9对44.5。但WikiSQL为73.4对73.8,略低于全量,且该任务典型波动约±0.5。较大37.7M LoRA的WikiSQL为74.0,也不能将0.2差异夸成稳定优势。
证据四:表5,固定约18M参数预算。 只调Q、秩8的WikiSQL为70.4,同时调Q/V、各秩4为73.7。说明在此预算下,把自由度分配到哪些映射,可能比单纯增加某一矩阵的秩更重要。四种投影一起调也有竞争力,因此“只调Q/V是唯一最优”同样超出表格。
证据五:表6与§7.2。 Q/V秩1、8、64的WikiSQL分别为73.4、73.8、73.5,并非秩越高越好。原文脚注明确不期待小秩适用于所有任务,例如语言变化很大时可能需要更强更新。这个限制比把rank设成固定经验常数更值得记住。
五、增量低秩不压缩骨干,也不适合任意领域跨度
LoRA减少的是可训练状态,不消除前向激活、主模型权重或数据处理开销。秩小可能优化更容易,也可能欠拟合;秩大增加容量但不保证泛化。要区分“低秩约束足以完成该任务”和“所有全量微调梯度都低秩”,后者并未被前者证明。
六、把低秩更新与量化冻结骨干组合
低秩更新已缩小任务状态,冻结基座仍占显存。QLoRA直接接住这个瓶颈,把量化存储与高精度增量训练组合;检查时继续区分合并等价与重新量化误差。
自测与答案
1. LoRA是否假定预训练权重是低秩的?
不是。假设针对任务所需增量,可以满秩,也可以满秩。低秩因子只是限制可训练的改动方向,因此小检查点不代表小完整模型。
2. 为什么常见初始化是一个因子随机、另一个为零?
乘积为零确保初始模型保持预训练行为;随机因子又能让零因子得到非零梯度。若A和B都为零,双方梯度都含另一个零因子,训练无法启动。第一步随机因子的梯度可能为零,不妨碍另一个先更新。
3. 如果增大rank没有改善,该怎么判断原因?
先看训练损失是否仍下降、验证表现是否波动,再控制学习率、alpha、目标层与预算。可能是小秩已足够、额外容量过拟合,也可能优化配方不合适。表5提示改目标层集合也值得比较,不能仅凭一次rank曲线宣布任务真实内在秩。