074|QLoRA:把大模型放进显存,再用小适配器改变它
论文:Tim Dettmers、Artidoro Pagnoni、Ari Holtzman、Luke Zettlemoyer,QLoRA: Efficient Finetuning of Quantized LLMs,2023。论文、正文 v1、官方代码。
图表来源:Tim Dettmers、Artidoro Pagnoni、Ari Holtzman、Luke Zettlemoyer,2023,原文;CC BY 4.0。本篇展示做了图形区域裁切、PNG格式转换,图中数据与标签未改动。
先接住前作的问题
LoRA减少梯度与优化器状态,但完整冻结基座仍占显存。本篇直接承接这个缺口,以低位存储骨干、高精度计算和低秩训练组合降低门槛;GPTQ与AWQ主要面向部署压缩,实验目标不同。
五个前置概念
五个概念:量化码本规定低位值对应什么实数;反量化恢复近似高精度值而非原始精确值;低秩更新用两个瘦矩阵表达参数变化;激活检查点用重算换保存内存;分页通过CPU/GPU间迁移状态应对容量压力。
一、问题设定:LoRA更新很小,怎样让庞大冻结基座也放进显存
训练显存除了可训练参数,还包含基座权重、激活及优化器状态。LoRA去掉了多数权重的训练状态,却必须让梯度经过基座计算才能抵达早期适配器;本篇进一步压缩冻结权重及尺度,并处理偶发内存峰值。
QLoRA 属于监督微调与数值表示技术,论文聊天模型 Guanaco 也使用交叉熵,不使用强化学习。即使训练数据名为 HH-RLHF,选择其中响应做监督训练也不等于执行 RLHF。
设输入 ,基座权重近似为 ,低秩矩阵为 、:
是适配器缩放系数。训练更新 ,不更新存储的 。但若要给前层传梯度,仍需计算与 有关的输入梯度。冻结表示“不求基座权重更新”,不表示“把整个基座放进无梯度上下文”。
二、分开NF4权重代码、量化常数与高精度计算
NF4 解决有限量化值怎样分配。 将权重分块并按绝对最大值归一,使用由正态分布分位数启发的16个表示值。权重密集的零附近分配更细的间距,稀疏尾部间距更大,并保留精确零。它不同于标准 FP4 的指数尾数组合。
作者用信息论最优描述这项设计,需要保留分布前提:实际权重经分块和最大值归一后未必严格服从正态分布,分位数设计也不等于对所有下游任务损失全局最优。经验优势由量化和微调实验支持,而不是一条保证任何模型无损的定理。
双重量化解决尺度本身占空间。 每64个权重保存一个32位尺度,会额外花费 bit/参数。将这些尺度再以8位存储,并每256个尺度设置二级32位尺度,额外成本约为:
因此节省约0.373 bit/参数。它压缩的是量化元数据,不是对同一权重连续量化两次以神奇地恢复精度。实际还有偏移等辅助信息,计算是主要平均成本模型。
分页优化器解决峰值。 使用统一内存,在需要时把优化器状态在 GPU 和 CPU 内存之间迁移。这能帮助避免偶发显存不足,却不是免费增加显存;频繁换页可能造成传输等待。它也没有把所有激活自动压到4位。
压缩比例应把量化常数也放进分母
“4 bit”首先描述权重代码,不包括每组权重使用的缩放常数。按论文双重量化讨论的块大小,每 64 个权重保存一个 FP32 常数时,常数额外占 bit/参数。把这些常数再量化为 8 bit,并每 256 个常数保存一个 FP32 二级常数,理想均摊开销变为
这里暂不计边界填充、偏移量及框架元数据,所以 4.127 bit 仍是结构性估算。NF4 存储值在计算时解量化;低位宽存储、矩阵乘的计算类型、可训练参数的精度必须分开报告。分页优化器处理峰值显存压力,也不意味着数据搬运或主机内存没有成本。
自构整块例子。 取恰好 16384 个权重,即 256 个 64 元素块。4 bit 权重代码占 8192 字节;一级 FP32 常数本来占 1024 字节,双重量化改为 256 字节的 8 bit 常数加 4 字节的二级常数,共 260 字节,节省 764 字节。这个小账本说明:双重量化压缩的是量化元数据,而不是再把 4 bit 权重变成 1 bit;模型训练的实际峰值还包括 LoRA 参数、梯度、优化器状态及激活。
冻结量化基座后的反向还需要哪些数值
线性层若用反量化后的基座矩阵参与前向,回传输入梯度仍要乘该矩阵的转置;只是不保存它自己的可训练梯度。早层LoRA要收到正确误差,依赖这条输入梯度路径。逐项检查requires_grad与图是否保留,比把“冻结”统一翻译成no_grad更准确。
教法联系:Sourab Mangrulkar、Sayak Paul的Parameter-Efficient Fine-Tuning。算例为本文自构。
三、保持梯度穿过基座并管理激活与分页峰值
输入:预训练模型 W、监督样本 D
W4, first_scales = blockwise_NF4_quantize(W, block=64)
scale8, second_scales = quantize_scales(first_scales, block=256)
freeze W4 and quantization metadata
attach trainable LoRA to transformer linear layers
for batch in D:
    on demand, dequantize required weights to BF16
    compute base output plus LoRA output
    loss = cross_entropy(on dataset-specific supervised tokens)
    backpropagate through fixed base operations into LoRA parameters
    update LoRA with paged optimizer
输出:固定量化基座和训练后的适配器
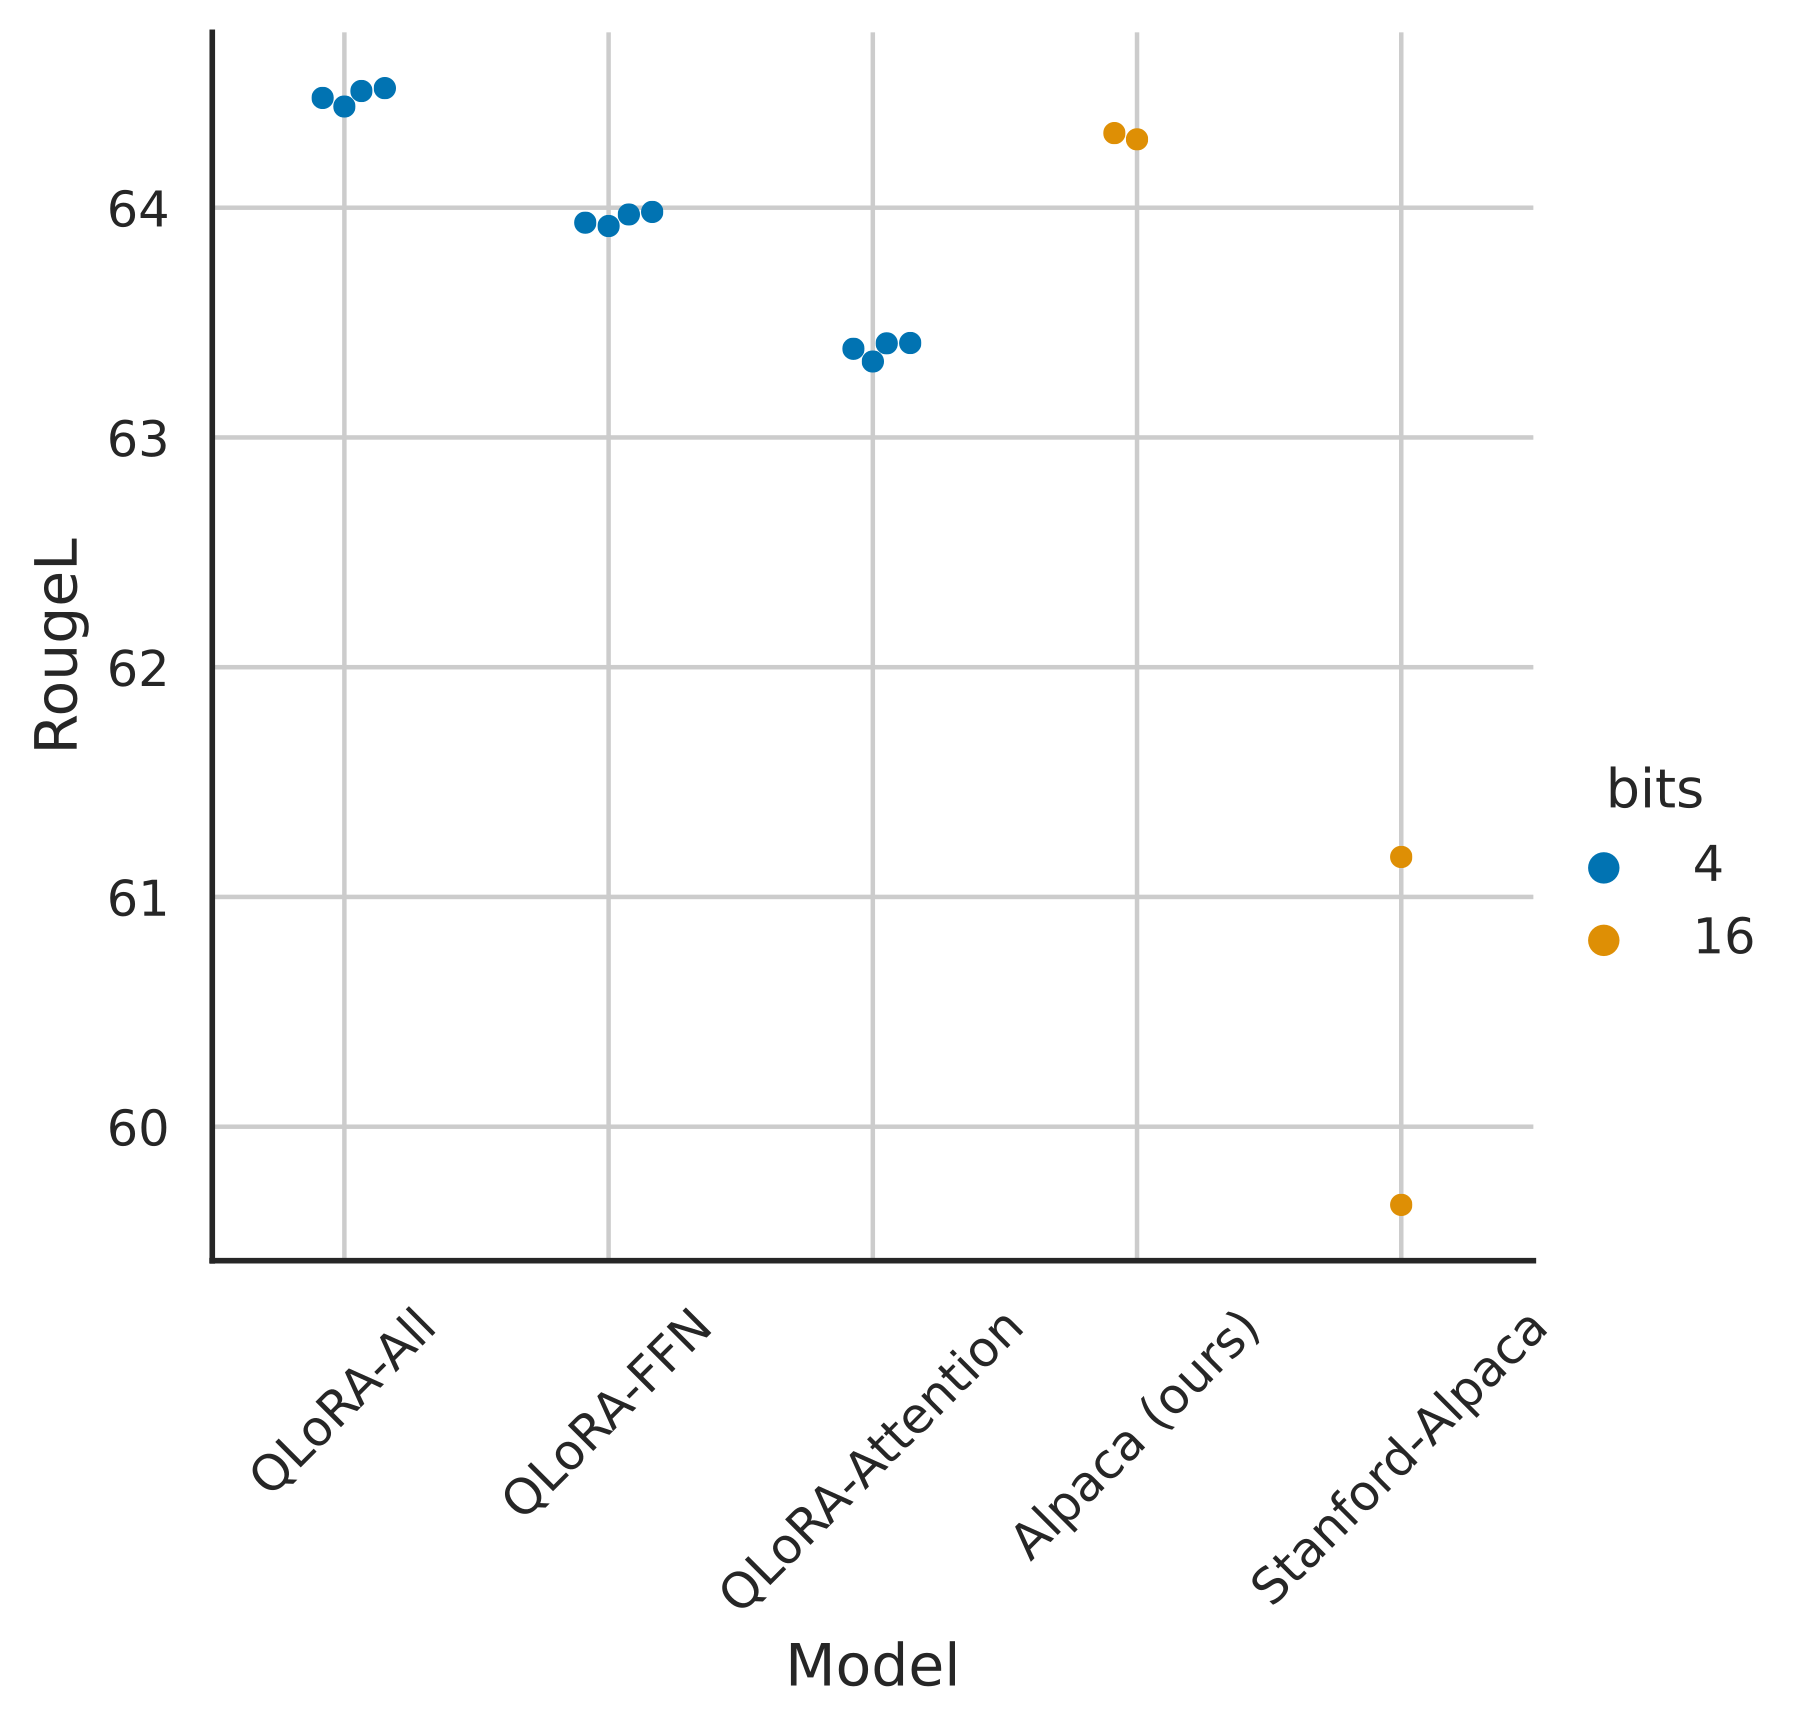
损失还是交叉熵,量化不是新任务目标。LoRA 覆盖位置是一项关键训练设计:原文图2发现只放在 query/value 投影不足,覆盖 Transformer 线性层更接近较强16位基线。不能只比较位宽,却把适配器覆盖范围也悄悄改变。 每个散点是一组随机种子的训练结果;图2以 Alpaca 的 RougeL 比较配置,只能支持该任务和适配层覆盖下的质量比较。
自构算例,未运行: 一个4096×4096线性层有约1678万参数,16位权重约32 MiB,4位裸权重约8 MiB,另需尺度。rank64的LoRA两个矩阵共有524288参数,约为基座参数的3.125%。即便适配器很小,训练时也仍需要输入激活和矩阵乘法工作区,所以不能把8 MiB加1 MiB当成整个训练的峰值显存。
四、按位格式、对照模型和评委口径检验质量
先区分全参数对照与16位LoRA对照,再看聊天评审;4位存储收益和99.3%的相对评分各有独立分母。
| 项目 | 配置与比较含义 |
|---|---|
| 精度实验 | RoBERTa/GLUE、T5/Super-NaturalInstructions、LLaMA/MMLU;小模型比较全参微调,大模型主要比较16位LoRA |
| 量化评测 | OPT、BLOOM、LLaMA、Pythia,不同位格式的语言建模困惑度与零样本任务 |
| 聊天模型 | LLaMA 7B、13B、33B、65B;8种指令数据;Guanaco基于OASST1筛选数据 |
| 主适配器 | 附录B.2:rank64、缩放超参数16;Transformer线性层添加LoRA;BF16计算 |
| OASST1预算 | 表9:各尺寸1875步、batch16、长度512;7/13B学习率0.0002,33/65B为0.0001 |
| 监督位置 | 有明确指令/响应的数据通常只监督响应;OASST1与HH数据使用选择后的完整对话,包含用户文本 |
| 聊天评估 | Vicuna80题、OA953个用户查询;温度0.7、top-p0.9;GPT-4与人类评价 |
| 人工评价 | 与ChatGPT打分比较每项2名标注者;成对比较3名标注者;不能当作无误差的真实质量标签 |
| 重复口径 | 图2各点含不同随机种子;Elo打乱比赛顺序10000次控制计分顺序,不是训练10000个模型 |
| 成本边界 | 单卡可容纳与训练耗时依赖batch、长度、检查点和分页;不能仅由参数量推断峰值显存 |
表9的 OASST1 设置尤其说明:正文关于“大模型加大batch”的一般描述存在具体数据集例外。复现应该采用对应行,而不是用一句概括覆盖所有实验。
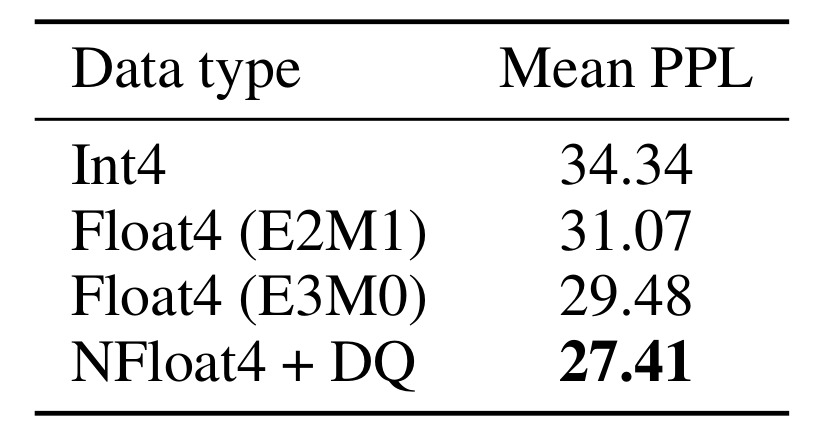
证据一:表2,位格式比较。 跨模型平均困惑度 Int4为34.34,FP4 E2M1为31.07,FP4 E3M0为29.48,NF4+DQ为27.41。越低越好。它支持所测试权重分布下 NF4 的优势;这是跨配置聚合,不是单个65B模型的困惑度,也不直接证明聊天质量提升同样大。
证据二:表3,小模型微调。 T5-3B 的16位 LoRA 为55.4 ROUGE-L,NF4+DQ为55.3,作者复现的全参基线54.9;但 T5-11B 的原报告全参分数62.0,对比NF4+DQ60.9,且该列没有作者全参复现。正确读法是多个受控比较接近,而不是每个单元格严格无损。
证据三:表4,大模型的对照是谁。 跨尺寸与数据的16位 LoRA平均MMLU53.0,NF4+DQ53.1;33B/FLAN一项却从60.5到59.2,65B/FLAN从62.5到63.9。平均相近包含正负变化,不能推出每种任务都相同。更不能把大尺寸 LoRA 对照写成完整全参数微调对照。
证据四:表5和表6,数据适配具有任务性。 65B FLAN 的MMLU63.9高于Guanaco62.2,但 Vicuna 相对评分48.4低于Guanaco99.3。不同数据塑造不同能力,不能用单个考试成绩替代聊天评价,也不能把“小数据更好”推广成数据规模不重要。
证据五:表6、表7与§5.3,评委有偏差。 Guanaco65B 相对ChatGPT评分99.3%,95%区间为±4.4个百分点;交换回答顺序时96.7%与101.9%不同。人类与GPT-4系统排序 Spearman相关0.55,逐例一致性Fleiss κ为0.25。99.3%只是一个小基准、特定评委和归一方式下的评分,不是99.3%的通用能力,更不是几乎同样可靠的保证。
分页的效果还应另看§4:作者没有给出全面的峰值分页消融,报告的某个65B配置速度与普通优化器相近。可以说它解决了可运行性问题,不能声称任何长序列负载都没有额外开销。
五、任务适配与量化补偿仍受数据和运行成本限制
量化误差可以通过适配器在任务分布上部分补偿,但低秩更新没有义务修复所有输入上的数值差异。
作者同时强调聊天基准不够可靠,并给出失败案例。进一步分析还包括:适配器部署必须匹配量化基座;合并到权重再重新量化可能改变输出;高质量数据与任务匹配并不是同一个概念;节省参数状态后,长序列激活可能成为新瓶颈。省显存意味着更可行,不自动意味着更快或更准确。
六、区分适配时低位基座与部署量化路线
低位训练成功不等于所有部署内核都会更快。用GPTQ和AWQ比较面向部署的量化目标,再检查合并适配器或重新量化是否引入新误差。
自测与答案
1. 基座被冻结,为什么不能把整个基座前向都放在 no_grad 中?
答案:前层适配器的梯度需要穿过后续基座运算传播。可以不保存基座权重梯度,但必须保留对输入激活的求导路径。否则会切断某些可训练分支,而不是正确实现QLoRA。
2. NF4加双重量化后,每个参数是否恰好只占4位?
答案:不是。4位是权重编码,还要尺度等元数据;论文主要平均模型为4+0.127 bit,实际还存在未量化部分、适配器和运行时状态。双重量化减少的是尺度开销,不会使所有训练状态都变成4位。
3. 怎样设计实验检验“QLoRA和全参数微调一样好”?
答案:选择同一基座和数据,固定训练与调参预算,同时比较全参数、16位LoRA和QLoRA,保持适配器覆盖一致,报告多种任务、随机种子、峰值显存和耗时。这样才能分别定位低秩约束、量化误差与数据变化的影响,而不是只看一个平均分接近。