076|AWQ:量化权重时,为什么要先看激活?
论文:Ji Lin 等,AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration,2023。论文、正文 v2、官方代码。后续实现变化不包含在本文实证结论中。
先接住前作的问题
GPTQ通过曲率补偿量化误差;本篇走平行路线,直接从输入激活识别敏感通道,再用等价缩放改变舍入误差。与QLoRA的适配训练不同,它主要改善已训练权重的推理部署。
五个前置概念
五个概念:训练后量化在已有权重上做压缩;校准集提供典型激活统计;通道缩放重新分配数值动态范围;分组量化让小块权重共享尺度;内核融合减少中间存储和启动开销。
一、问题设定:同样舍入误差,为何不同激活通道影响不同
线性层 中,权重误差会被相应激活放大。本文研究W4A16或W3A16,即低位权重与较高精度激活;activation-aware指利用激活统计挑选保护方向,不表示把激活也压到4位,也不通过任务损失微调模型。
RTN 将每个权重映射到邻近量化值,简单但没有充分考虑输出误差。GPTQ 利用校准输入和近似二阶信息补偿权重舍入误差。AWQ 选择更受限制的搜索空间:根据输入通道的平均激活幅度设置缩放,再搜索一个指数参数,而不是回归调整全部权重。
作者认为这种限制降低了过拟合校准数据的风险。实验提供了跨两个文本领域的支持,但“完全不会过拟合”比实验能证明的范围更强;网格搜索仍然利用了校准样本上的输出误差。
二、由输出敏感度推导缩放与逆缩放的量化作用
令 ,在全精度数学下:
量化后的输出为:
第一条等式是精确代数关系;第二条引入 后一般不再等价。目标是选择缩放使输出误差较小,而不是声称缩放消除了所有舍入误差。输入逆缩放通常可以融合进前一层,减少运行时开销。
设通道激活统计为 ,论文把缩放限制为 ,在 上用20个网格候选搜索。接近0时缩放弱,接近1时更偏重高激活通道;随后也搜索权重裁剪以减少量化步长。
为什么放大会保护通道?若分组的量化步长 近似不变,把权重放大 倍再把输入除以 ,有效输出舍入误差也约除以 。但若放大后的权重抬高了组最大值,新的 也会增长,其他通道反而更粗糙。原文的近似依赖这个平衡,不是任意缩放的误差单调下降证明。 因而尺度搜索应评价同组完整输出,不能只优化被保护通道;后面的缩放2与4对照正用于检查这项取舍。
局部误差更小并不自动证明长文本推理更可靠。
“保留1%高精度权重”是验证重要通道存在的分析实验,不是最终 AWQ 必须采用的混合精度格式。正式缩放方案的意义正是尽量保留统一低位格式,让硬件更容易执行。
显著通道是输出误差的概念
对一个线性输出 ,设量化误差为 。固定输入时,输出误差满足
这里 是输入通道,右边是三角不等式上界,真实误差可能抵消。对通道施加 后,浮点表达式 不变;量化后的组尺度耦合已由上面的推导限定。
自构敏感度例子。 输入为 ,两个权重的量化误差分别为 ,两个通道对输出误差的贡献是 1 和 0.1。前者的权重误差虽小十倍,输出影响却大十倍。若部署输入改成 ,重要性立即反转。这不是 AWQ 无效的证明,而是说明校准集必须覆盖实际激活分布;只在一个领域校准,再把另一领域的结果解释成位宽本身的能力上限,会混淆分布偏移与量化方法。
教法联系:Lilian Weng的Large Transformer Model Inference Optimization。算例为本文自构。
三、校准通道尺度、裁剪并匹配统一低位内核
输入:浮点模型、少量校准文本、目标位宽、group_size=128
run calibration forward passes and cache layer inputs
for each supported linear layer:
    activation_scale = mean_absolute_input_per_channel
    for α in grid_of_20_candidates:
        S = diagonal(activation_scale ** α)
        candidate = group_quantize(W @ S)
        error = output_error(candidate @ inverse(S) @ X, W @ X)
    choose the best scaling candidate
    search clipping parameters on calibration outputs
    fuse inverse scaling into compatible preceding operation
    pack all target weights into low-bit storage
输出:低位模型、量化元数据与可执行推理布局
这是算法主线的教学表达。数值实现需要处理零激活、张量布局和尺度融合等细节;不能把伪代码当作与所有网络结构直接兼容的部署库。
四、依次检验重要通道、缩放范围与真实解码速度
保留1%FP16先验证通道重要性,统一缩放才是最终方法;再分别读跨域校准和短提示单请求的速度证据。
| 维度 | 原文设置及范围 |
|---|---|
| 模型 | OPT、LLaMA、Llama2;指令模型Vicuna;多模态OpenFlamingo9B与LLaVA13B |
| 位宽 | 主要INT3/INT4、每组128;极低位补充INT2、每组64 |
| 校准 | Pile小样本,尺度网格20;正文未把所有主表统一默认校准条数与序列长度清楚列成一张配置表,不能用敏感性实验的16条替代全部配置 |
| 质量评价 | WikiText2困惑度;Vicuna80题两种回答顺序,共160次比较;COCO5000样本的图像描述CIDEr |
| 多模态量化范围 | OpenFlamingo仅量化语言部分,视觉组件保持原精度;不能把语言权重4倍压缩推广为整个系统严格4倍 |
| 校准迁移 | PubMed与Enron交叉校准、各1000评估样本;校准与评估无重叠 |
| 量化计算 | 附录B:小于40B使用1张A100,大模型2—4张;约0.1—3 GPU小时,随规模变化 |
| 速度 | RTX4090、笔记本RTX4070、Jetson Orin;batch1、4token提示、生成200token,报告中位延迟 |
| 系统基线 | Hugging Face FP16;AWQ系统同时优化量化线性层和其他层,并含融合,速度差不能只归因于数学缩放 |
| 不确定性 | 主质量表没有统一给出多次校准随机种子的置信区间;160次评判不是160个独立问题 |
证据一:表1,重要性来自哪里? OPT-6.7B 的INT3困惑度23.54;按激活选1%通道保留FP16为11.39,按权重选为22.37,随机选为24.23。它支持这一模型中输入激活比权重幅度更能识别值得保护的通道。并不证明1%是所有层和任务通用的比例。
证据二:表2与表3,缩放不是越大越好。 缩放2时困惑度11.92,缩放4为12.36;新旧量化步长不同的组比例由8.2%增至21.2%。完整AWQ在表3该模型达到11.39,接近保留1%FP16的结果。这里应在相同表配置内比较;附录另表的浮点困惑度与主表不同,不能把数字跨表拼接成额外增益。
证据三:表4,Llama2质量。 7B浮点5.47,INT4的RTN5.73、GPTQ-R5.63、AWQ5.60;70B浮点3.32、AWQ3.41。AWQ较低位基线更好,同时仍存在相对浮点的损失。尤其4位大模型的差距很小,不能夸大成所有下游任务都会明显提升。
证据四:表5,多模态迁移。 OpenFlamingo32-shot的FP16 CIDEr81.70,INT4 RTN77.13,AWQ80.53,损失从4.57缩小到1.17分。INT3 AWQ74.47,仍差7.23分。它说明文本校准得到的量化策略可用于所测图像描述,但没有覆盖所有视觉推理、幻觉和OCR任务。
证据五:图6与图5,分布和真实速度。 PubMed/Enron交叉校准时,AWQ困惑度增加约0.5—0.6,对照GPTQ增加2.3—4.9;这支持有限跨域稳健性。速度实验中4090报告2.7—3.9倍加速,4070上的13B达到33 token/s,但测量是极短提示、单请求解码,不能推广到长提示预填充或高并发服务。 校准图左侧改变校准样本量,右侧改变校准与测试分布;该消融使用 OPT-6.7B、INT3-g128,不能直接推广成所有四位模型的统一误差。
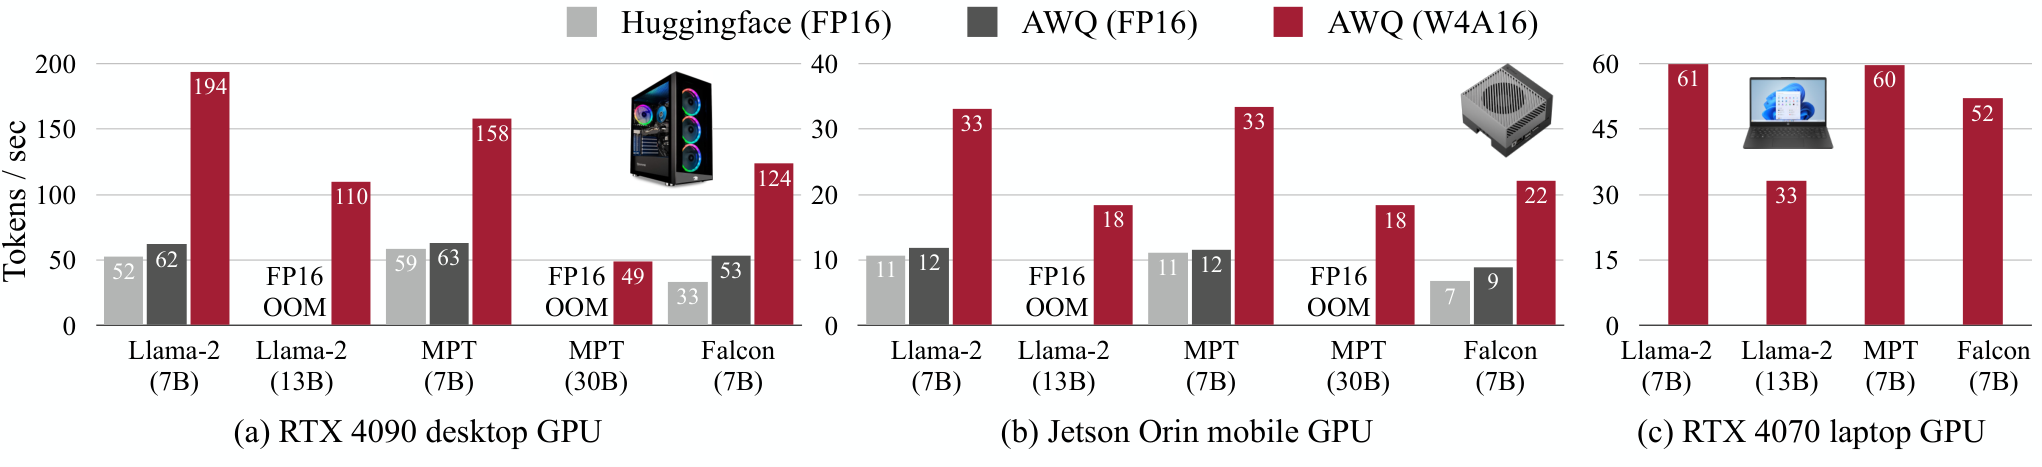
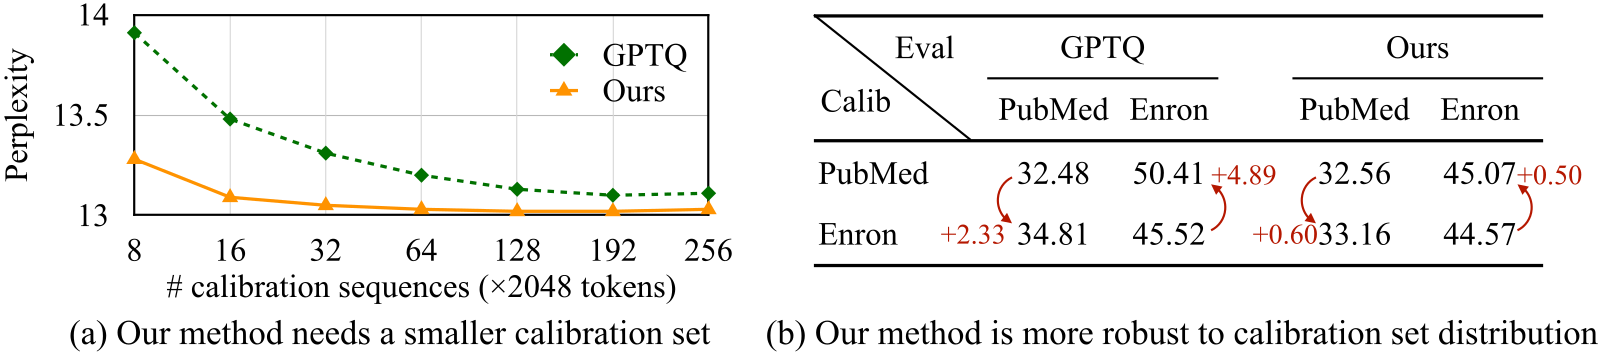
表6还显示AWQ可以与GPTQ组合:OPT13B的INT2困惑度由GPTQ16.74降到13.25,而浮点10.13。二者不是只能竞争的互斥方案;更低位场景中的互补并没有消除质量差距。
五、校准偏移、元数据和负载仍会改变收益
系统实现则把存储节省变成速度收益,这与算法精度贡献互相配合,但不是同一个实验问题。
作者承认评测主要集中于困惑度和任务准确性,还需要可靠性、偏差、校准等更广指标。附录C讨论无分组量化时的不足,说明当前机制依赖分组提供局部动态范围,不能随意去掉分组却期待保留同样收益。
进一步分析还包括:激活分布可能因提示格式、语言、长上下文和领域改变;量化不负责修正原模型事实错误;固定分组带来尺度与零点元数据;CPU或不支持所需低位内核的设备未必加速。“模型文件更小”与“每次请求更快”需要两份测量。
六、压缩权重后继续检查KV与调度瓶颈
权重压缩后,长序列服务可能转由KV与调度限制。vLLM提供缓存布局的可组合改进;应重新测prefill、decode和并发负载,不能沿用短提示单请求倍率。
自测与答案
1. AWQ 名称里有 activation,是否说明它把激活也变成4位?
答案:不是。它主要做低位权重量化,利用激活统计决定如何保护权重通道。了解输入对权重误差的放大作用,不需要把输入本身也低位化。
2. 为什么缩放和逆缩放在量化前等价,量化后却能改变结果?
答案:实数乘法中两个缩放严格抵消;量化会把不同范围的权重舍入到不同网格点,不能和缩放交换顺序。正是这种非等价性给了重新分配误差的机会,也引入了损害其他通道的风险。
3. 怎样验证一套AWQ实现的3倍加速真的是你需要的收益?
答案:固定硬件、模型、生成长度、batch和提示长度,分别测预填充、逐token解码和端到端时间,同时报告质量和峰值内存。还应比较相同优化程度的FP16运行时,区分量化节省与融合优化;只复制论文短提示结果不足以预测自己的服务。