046 · RoFormer:用旋转把相对位置写进注意力
返回目录 · 上一篇:Prompt Tuning · 下一篇:LoRA
论文:Jianlin Su等,RoFormer: Enhanced Transformer with Rotary Position Embedding,2021年首次公开。本文公式、图表按2023年修订版v5定位,覆盖§3推导、§4实验与限制;官方实现。未重新训练模型,修订版结果不全部视为2021初稿同时报告。
图表来源:Jianlin Su等,2021,原文;CC BY-NC-ND 4.0。本篇展示做了PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。保留非商业与禁止演绎条件。
先接住前作的问题
Transformer用位置表示打破顺序对称,Transformer-XL又解决相对位置与缓存一致性。本篇沿平行位置路线,用query/key旋转使内积含相对角度;它没有从代数上保证长上下文理解。
五个前置概念
五个前置概念:query/key决定注意力匹配;正交矩阵保范数;相对位置是两个索引之差;频率决定每步旋转角度;长度外推是在未训练长度条件下测试能力,必须与更长长度训练后的评估分开。
一、问题设定:绝对位置输入怎样直接形成相对距离的匹配分数
RoPE只改变注意力内部的位置表示,输入仍为token序列,输出仍是上下文向量;翻译、掩码和分类各自保留任务损失。要解决的是匹配分数怎样直接依赖两词间距,而不是让网络先从两个绝对位置向量推断距离。
参照绝对位置嵌入,RoPE不将位置向量直接加到词表示,而是在投影后的query/key上乘位置相关矩阵。参照逐对相对位置表,它可分别处理每个位置,再通过内积产生相对关系,因此不必显式储存所有位置对的可训练嵌入。
但普通softmax注意力仍要计算所有query与key的组合,RoPE本身没有把 注意力变成线性。论文另外讨论与线性注意力组合,那里需要改变归一化处理,不能把两个版本当作完全相同的算子。
二、逐二维旋转推导内积中的角度差
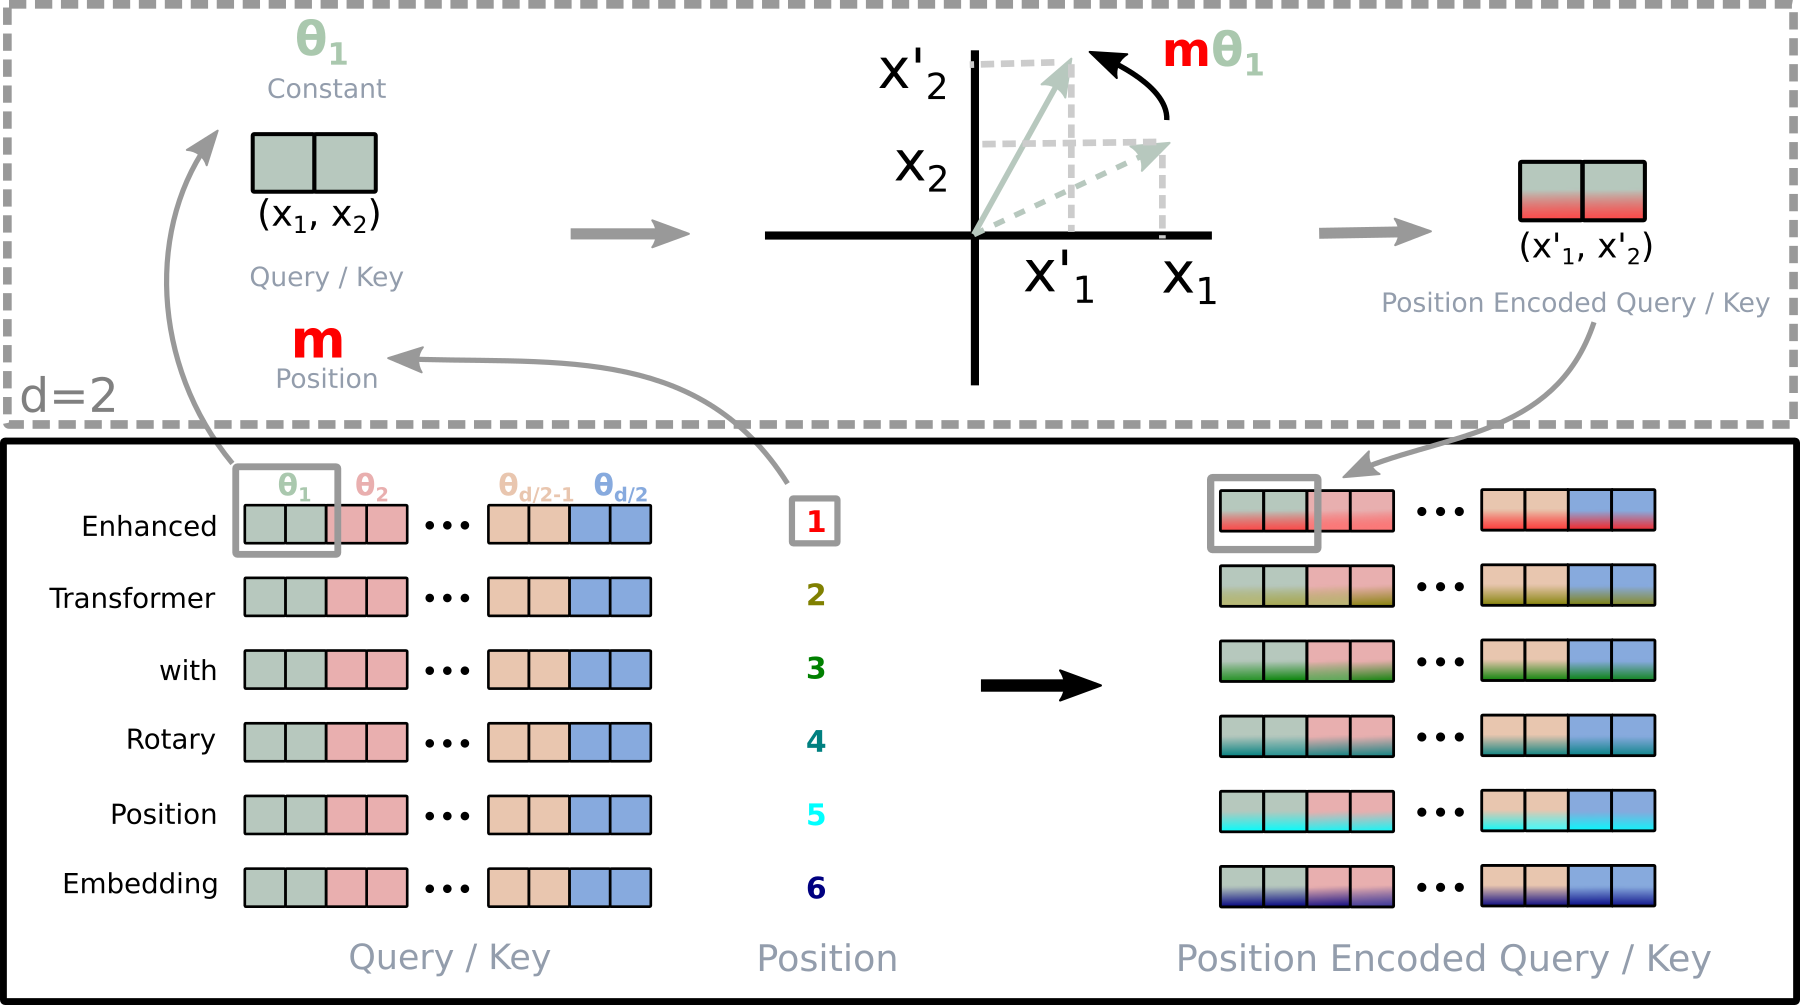
把每个注意力头的偶数维向量拆成二维对。第 对在位置 的旋转为:
是参与旋转的维度, 为频率。不同维度对转得快慢不同。将这些矩阵组成分块对角矩阵 ,对未加位置的向量 、 做:
关键等式是:
共同移动位置,角度差不变。这是对固定内容向量的局部注意力匹配关系;完整深层模型还受因果遮罩、边界、内容状态等影响,不意味着把整段输入随便平移后所有输出严格相同。
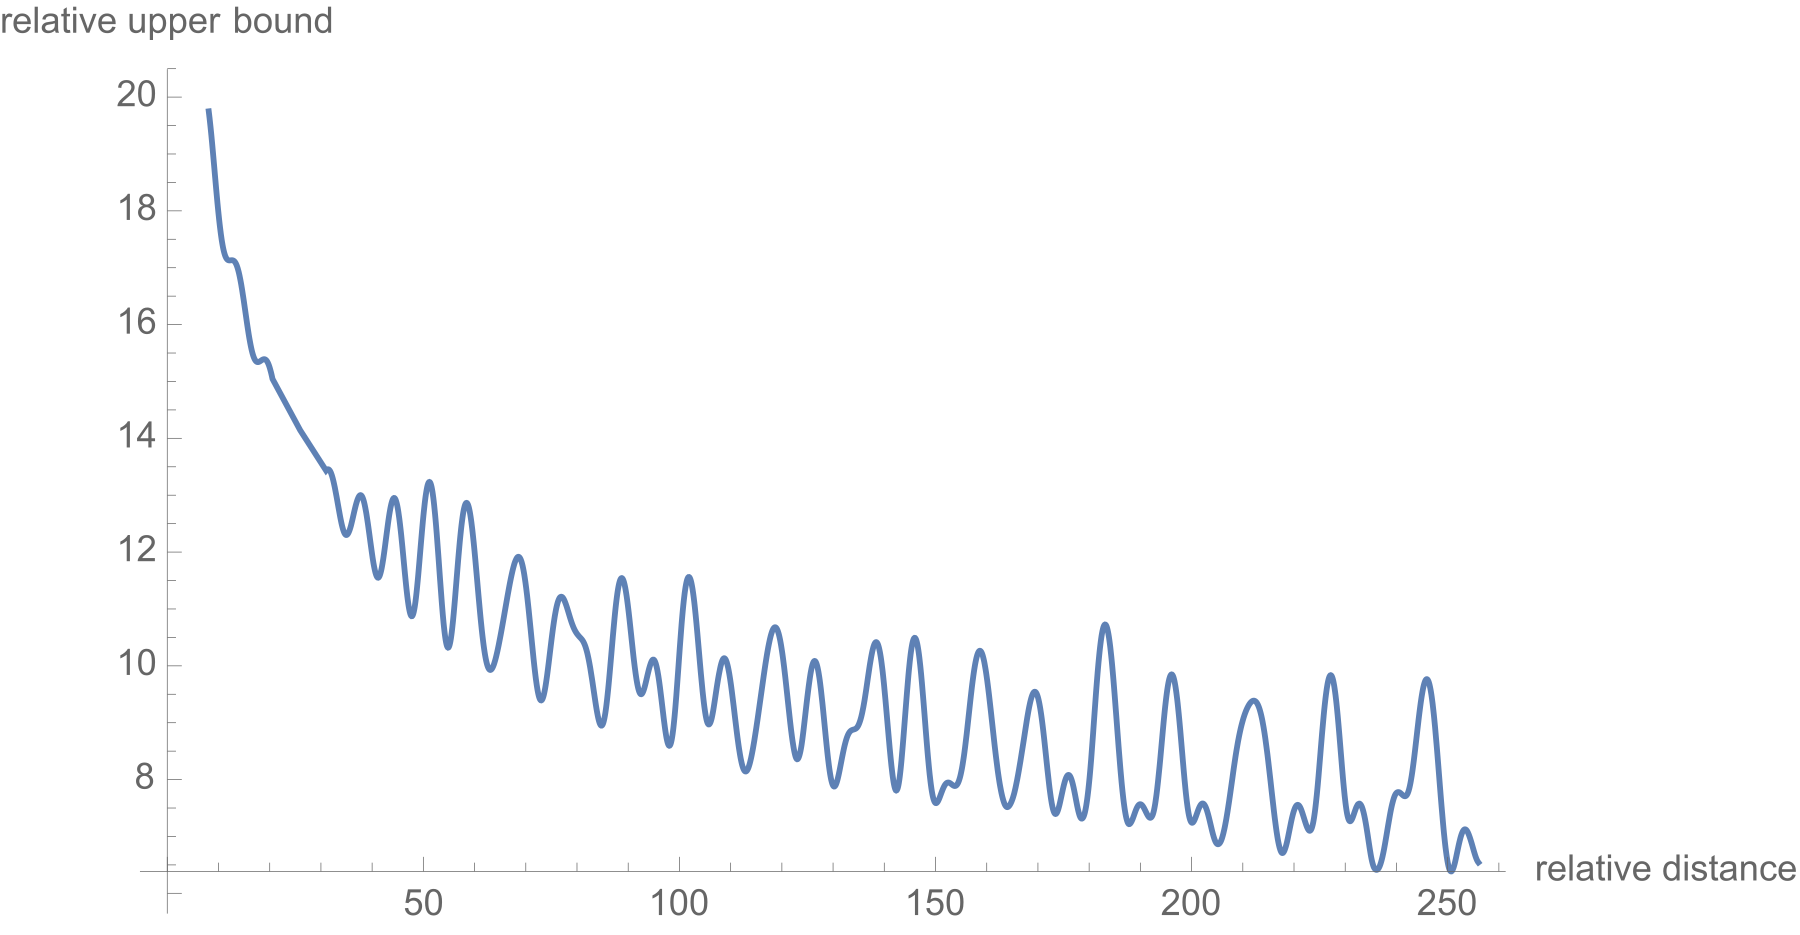
旋转是正交变换,保留向量范数;它改变方向而非直接把远处向量乘成更小。论文§3.4.3借复数求和与Abel变换研究距离相关上界,再以图2显示某种衰减趋势。这个上界分析不能改写成“任意固定query/key的分数随距离严格单调下降”。单一频率的余弦就会振荡。
旋转顺序与缓存位置必须统一
令 为角度 的二维旋转矩阵, 为实数角度。二维旋转满足 与 ,所以相对角度来自先撤销query角度、再施加key角度。高维只是对互不重叠的二维子空间重复该运算。实现中若训练用相邻维配对,加载时却按前后半维配对而不同时重排权重,虽然两种写法都“用了sin/cos”,它们仍不是同一模型。
自构例子: 只考虑二维,令 ,频率 。距离0、1、2、3、4的内积依次为1、0、−1、0、1。距离增大后又回到1,直接说明单个内容配对的分数不会保证单调衰减。真实RoPE叠加多频率且内容向量不同,但不能因此取消这个基本逻辑边界。
缓存里保存的是旋转前还是旋转后的键
若历史位置5的key已按位置5旋转并存入缓存,下次读取时应直接使用,不能又当成位置6旋转一次。当前query使用自己的绝对位置,两者内积才对应预定相对角度。测试可把同一短序列分别整段算和逐token缓存算,逐位置比较logit;只比较最终文本可能漏掉小的相位错误。
教法联系:Lilian Weng的The Transformer Family。算例为本文自构。
三、统一维度配对、位置编号与缓存约定
输入:Q、K、V,每个头维度 d 为偶数,位置数组 pos
frequency[i] = 10000 ** (-2*i/d)
angle = pos[:, None] * frequency[None, :]
对 Q 与 K 分别执行:
  a = 向量的偶数索引分量
  b = 向量的奇数索引分量
  rotated_even = a*cos(angle) - b*sin(angle)
  rotated_odd  = a*sin(angle) + b*cos(angle)
  交错拼回原维度
score = rotated_Q @ rotated_K.T / sqrt(d)
按任务施加遮罩,softmax(score) @ V
输出:包含内容与位置关系的注意力结果
这是相邻二维配对的教学实现。采用另一种维度排列的库也可以实现等价旋转,但必须一致排列频率和权重,不能混用。增量生成时新token的position也必须延续缓存上下文,否则相对角度不对应真实距离。
另一个实用检查是把位置4和7同时改为14和17,固定内容向量时内积应相同;这可作为旋转实现的单元验证。它验证代数正确,不验证模型问答质量。
四、把代数性质与翻译、GLUE和长输入结果分开
先检验旋转恒等式,再读不同任务有涨有跌的表格;训练曲线与长输入成绩仍须保留原文口径疑点。
| 实验 | 设置与预算 | 用来检验什么 |
|---|---|---|
| 英德翻译 | WMT2014约450万句对,37K联合BPE;最后5检查点平均,beam4、长度惩罚0.6 | 替换位置方式后的翻译表现 |
| 英文预训练 | BookCorpus与Wikipedia,8:2划分;批量64、长度512、AdamW学习率10⁻⁵ | 掩码预测训练曲线 |
| GLUE微调 | 3 epoch,批量32,长度512,学习率2–5×10⁻⁵,报告开发集结果 | 不同下游任务是否都受益 |
| Performer组合 | Enwik8,12层、768维、12头,批量128、长度1024、学习率10⁻⁴ | 与线性注意力组合是否可训练 |
| 中文预训练 | 约34GB;表4给出6阶段,长度128–1536、共452.5K步 | 多长度训练后的模型能力 |
| 长文匹配 | CAIL2019-SCM共8964个三元组,6:2:2划分 | 哪两个案例在语义上更接近 |
中文总步数452.5K由表4的200K、12.5K、120K、80K、10K、30K相加得到,是自行合计。各阶段长度与批量不同,总步数不是统一token预算。论文未为表1、表2、表5全部给出可直接配对的多种子置信区间,因此微小差异不应被自动称为统计显著。
证据一:§3.2公式16及图1。 正交旋转给出相对位移内积,这是明确代数证据,支持机制解释。它不涉及模型是否学会解决长文任务;从公式跳到无限长度泛化,会超出推导内容。 衰减图描述多频率旋转下的趋势;它不是任意输入内容的注意力权重热图,不能据此给每个远处 token 设定单调上界。
证据二:表1与表2。 英德翻译BLEU从27.3到27.5,只有0.2分;GLUE中MRPC从88.9到89.5、STS-B从85.8到87.0,但SST-2从93.5降到90.7、QNLI从90.5降到88.0、MNLI也下降。实验结论是有收益也有损失,不能只引用有利的三项来概括全部下游任务。
证据三:表4和表5。 RoFormer-512的CAIL测试准确率68.29%,RoFormer-1024为69.79%,同模型增加输入长度提升1.50个百分点。WoBERT-512为68.10%,因此RoFormer-1024对它的差实际是1.69个百分点。§4.5.4文字将对WoBERT的提升写为1.5%,与表格数值不完全一致;本文保留可复核表格差值,不替作者猜测取整原因。
更关键的是,中文预训练已经包含1536长度,所以1024下游结果不能证明“只在512训练却能零成本外推到1024”。对不同模型的比较还混有可见文本量差异,性能提高可能部分来自保留更多证据。
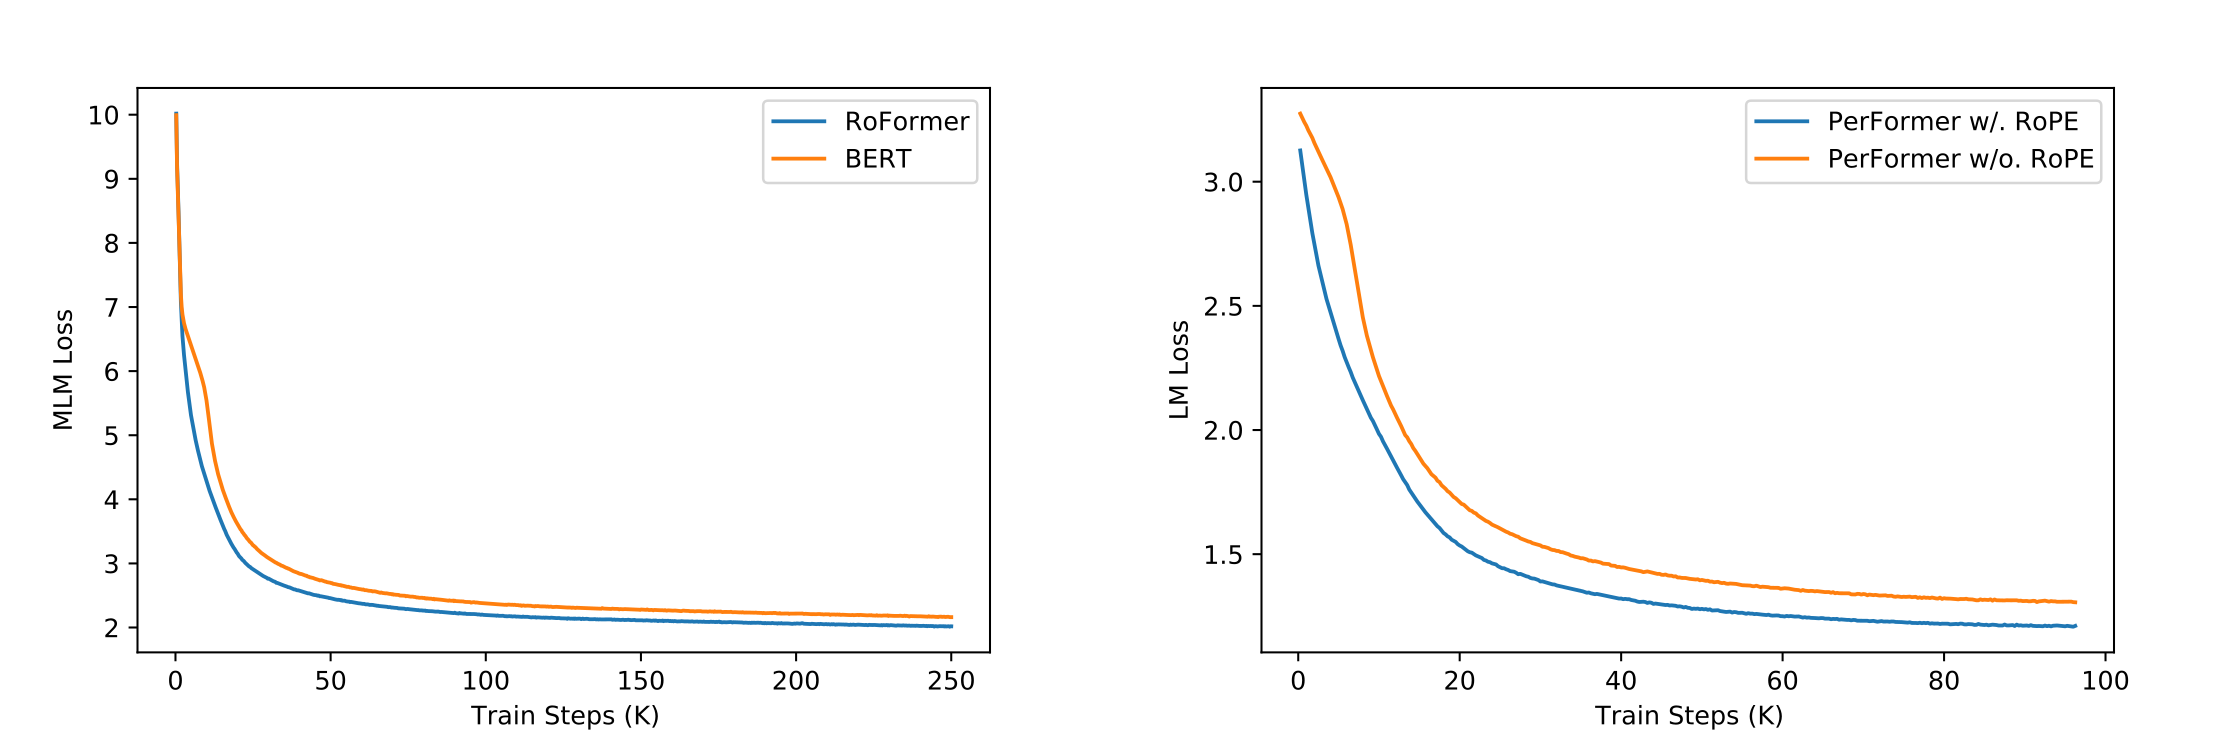
证据四:图3与§4.2、§4.4。 曲线显示相关模型训练损失较低,支持所测配方的优化表现。英文实验文字写100K步,但图3左横轴延伸到250K,训练日志口径未在对应文字中解释;此外正文将BERT位置表示称为sinusoidal,与标准BERT的可学习绝对位置不同。复现时应核对具体配置,不据此推断标准BERT所有设置都被严格复刻。
缓存教学例。 已缓存位置0到9的键,新token应使用位置10。若错误地从0重新计数,它与位置9的角差从1步变成−9步;内容与参数完全相同,匹配分数也会改变。验证实现可固定q、k,把两位置同时加100,比较内积;这检验代数和索引一致,不检验真实长文外推能力。
五、可计算位置不等于任意长度任务泛化
RoPE把位置建模做成容易计算、可组合的代数操作。作者在§4.5.5明确承认,对为什么收敛更快、为什么长文任务更好,仍缺乏充分解释。理论表达优雅与经验收益之间还有因果证据缺口。
六、把旋转位置组合到解码器并验证长度适配
把RoPE组合到LLaMA之后,仍需验证训练外长度与位置利用。Lost in the Middle给出行为层诊断;旋转恒等式保证的是匹配代数,不是任意长任务正确率。
自测与答案
1. 为何分别使用绝对位置旋转,却得到相对位置分数?
因为query旋转在内积中转置,变成反方向旋转,随后与key旋转相乘:。因此对于固定内容向量,只剩角度差。这个性质来自旋转群结构,不需要为每种距离单独学参数。
2. RoPE能计算位置一百万,能否推出模型能理解百万token文本?
不能。可计算位置只是表示定义,模型仍可能遭遇未见角度组合、注意力分布变化和计算资源限制。需要在明确训练长度、位置设置与任务指标下验证;本篇中文1024结果甚至已有1536预训练覆盖。
3. 长距离衰减意味着远处词永远不可能比近处词得到更高注意力吗?
不意味着。旋转内积包含内容和多频率振荡,论文讨论的是特定上界与趋势,不能限制任意内容组合的排序。二维余弦反例就能说明,之后softmax还同时依赖其他候选分数。