068 · LLaMA:把更多训练投入,换成较小模型的长期使用价值
返回目录 · 上一篇:Toolformer · 下一篇:GPT-4技术报告
论文:Hugo Touvron等,LLaMA: Open and Efficient Foundation Language Models,2023年。原始论文 · v1正文。本篇讨论第一代LLaMA,后续Llama版本的架构、许可和训练细节不能倒灌进来。
图表来源:Hugo Touvron等,2023,原文;CC BY 4.0。本篇展示做了PNG格式转换,图中数据与标签未改动。
先接住前作的问题
Chinchilla寻找训练算力最优配比,却没有把未来所有推理调用加入成本。本篇更重视较小模型反复部署的经济性,并组合RoPE等已有组件;它改变资源目标,不是推翻固定训练预算下的结论。
五个前置概念
五个前置概念:预训练从大规模文本学习预测;token预算是实际训练曝光量;RMSNorm按均方根归一化;门控前馈网络用一个分支调制另一个分支;pass@k衡量多个代码候选中至少一个通过测试的概率。
一、问题设定:反复部署时,训练更充分的小模型何时更划算
参数量 和token数 决定训练资源,也影响每次推理成本。若模型将被大量使用,多花训练预算让较小模型读得更充分可能值得;是否划算必须同时给出质量要求和未来调用规模。
可以用一个自构成本模型帮助理解:
是使用次数, 是序列长度, 是batch。论文没有给出适用于所有硬件的这个成本函数;它表达的是目标发生了变化。一个训练更贵但推理更省的模型,只有在足够多次使用后,才可能抵消初始投入。
因此,训练超过某条训练算力最优曲线,不等于违反缩放定律。最优解依赖目标和约束。反过来,也不能因为小模型更省存储,就默认它在所有服务负载下总成本最低。
LLaMA主要是无检索、无工具的自回归基础模型,训练目标是下一token预测。普通预训练结果与少量指令微调探索在论文中分开;它不等于已经完成偏好对齐的聊天助手。
设大模型训练花100单位、每次调用花0.02,小模型充分训练花160、每次调用花0.01。两者质量假定相同,则当调用超过6000次,小模型额外60单位训练投入才被每次0.01的节省抵消。这些数值是自构教学例子,不是论文测得成本;它说明为什么使用规模改变最优决策。
二、组合成熟算子并配平门控前馈参数预算
标准训练目标为
损失没有要求模型解释理由、遵守指令或核查事实。这些能力能在什么程度上从文本学习中出现,需要下游评估,不能从公式直接推导。
架构采用解码器Transformer,并使用预归一化RMSNorm、SwiGLU和RoPE。RMSNorm按均方根缩放激活,省去均值中心化;预归一化把归一化放在子层输入侧;SwiGLU用一个分支调制另一个分支;RoPE把位置信息编码进查询与键的旋转关系。这些都是已有研究组件,论文明确说明来源。
SwiGLU的教学写法为
为门控分支, 为内容分支, 投影回隐藏维度, 是逐元素乘法。由于多了一个输入投影,不能仍用普通FFN的中间宽度来估计相同参数预算;论文相应调整宽度。
数据组合包括网页、代码、百科、书籍、论文和问答。处理方式也不一致:网页要识别语言与质量,代码要去模板和去重,论文要清理LaTeX,问答按质量排序。这里的有效训练数据不是“下载总字节数”的同义词,采样比例与重复次数共同决定模型实际看到什么。
SwiGLU的额外矩阵怎样保持近似参数预算
记模型宽度为 、门控中间宽度为 ,以下只计矩阵权重而忽略偏置。普通FFN将d维升到4d再降回,需要约 个权重。门控SwiGLU有两次d到m投影,一条经SiLU后与另一条相乘,再m到d输出,共 。令 ,就仍约为 。原文采用较窄的门控中间层,说明比较激活函数时必须同时交代中间宽度,不能用多一个矩阵偷偷增加模型容量。
教学算例。 d=3072时,普通4d宽度为12288,门控近似公平宽度为8192;两者主矩阵都约75497472个参数。实际实现可能为硬件对齐取整。这个账本只配平参数与主要乘法,不证明两种激活质量相同,也不涵盖访存或融合内核差异。
相同参数预算还要核对门控中间张量
自构宽度d、序列长S,SwiGLU两次输入投影各产生S×m,中间逐元素相乘仍为S×m,最后回到S×d。参数预算配平并不让这些激活自动与普通FFN同形同量;记录训练峰值时,哪些中间量被保存、哪些融合或重算,仍会改变实际显存。
三、记录数据曝光、优化与高效实现的完整配方
输入:多个来源的文本,目标模型规模,训练token预算
按来源清理、筛选和去重
使用统一tokenizer,按混合比例抽样文本
初始化带RMSNorm、SwiGLU、RoPE的因果Transformer
重复直到达到token预算:
    构造约定长度的序列批次
    前向计算下一token交叉熵
    反向传播并裁剪梯度
    按warmup与余弦调度执行AdamW更新
    定期评价训练损失和固定下游任务
输出:基础模型检查点及对应训练记录
训练实现使用节省注意力存储的内核、选择性重计算、模型与序列并行,以及计算通信重叠。它们主要改善可实现性和吞吐;没有完整逐组件消融,不能把每项性能提升精确分摊到某一个技巧。
四、对齐token预算后读能力与长期训练曲线
先按实际读过的token对齐曲线,再分别比较知识、代码与常识;一次主训练的GPU小时也不等于完整研发成本。
| 项目 | 原文设置 |
|---|---|
| 规模 | 约6.7B、13.0B、32.5B、65.2B,对应7B/13B/33B/65B名称 |
| token | 7B与13B训练1.0T;33B与65B训练1.4T |
| batch | 约4M token,不是4M条文本 |
| 数据采样 | CommonCrawl 67%、C4 15%、代码/百科/书籍各4.5%、arXiv 2.5%、问答2% |
| 优化 | AdamW,2000步warmup,权重衰减0.1,梯度裁剪1.0 |
| 大模型资源 | 65B约2048张80GB A100、21天;每GPU约380 token/秒 |
| 任务 | 常识、闭卷问答、阅读、数学、代码、MMLU及偏差测试 |
| 统计 | 主表未提供全部任务的多种子区间;部分对照数字取自既有论文 |
数据表中的epochs按1.4T训练设置统计,不代表每种来源都只看一次。书籍和百科会被重复采样,磁盘大小也不是token占比。7B/13B沿用相同比例但预算较少,不能把完整1.4T曝光量写给它们。
代码任务还需区分采样协议:pass@1用温度0.1,较大pass@k用温度0.8。二者不是从同一个温度下简单改变候选数量获得;比较时必须保留这些条件。
证据一:表3,较小模型的常识表现。 13B在HellaSwag为79.2,GPT-3为78.9;但PIQA为80.1对81.0。支持多数任务上具竞争力,不支持“13B全面超过175B”,更不是单独控制参数量后的因果实验。
证据二:表9,知识广度的限制。 65B的五样本MMLU为63.4,低于Chinchilla70B的67.5和PaLM540B的69.3。作者提出书籍与学术数据量差异的解释,但没有单独改变书籍比例来证明原因。
证据三:表8,代码采样指标。 65B HumanEval pass@1为23.7,低于PaLM540B的26.2;pass@100为79.3,高于76.2。不同采样预算可能改变排序,不可只选最高的一个指标宣称全面领先。
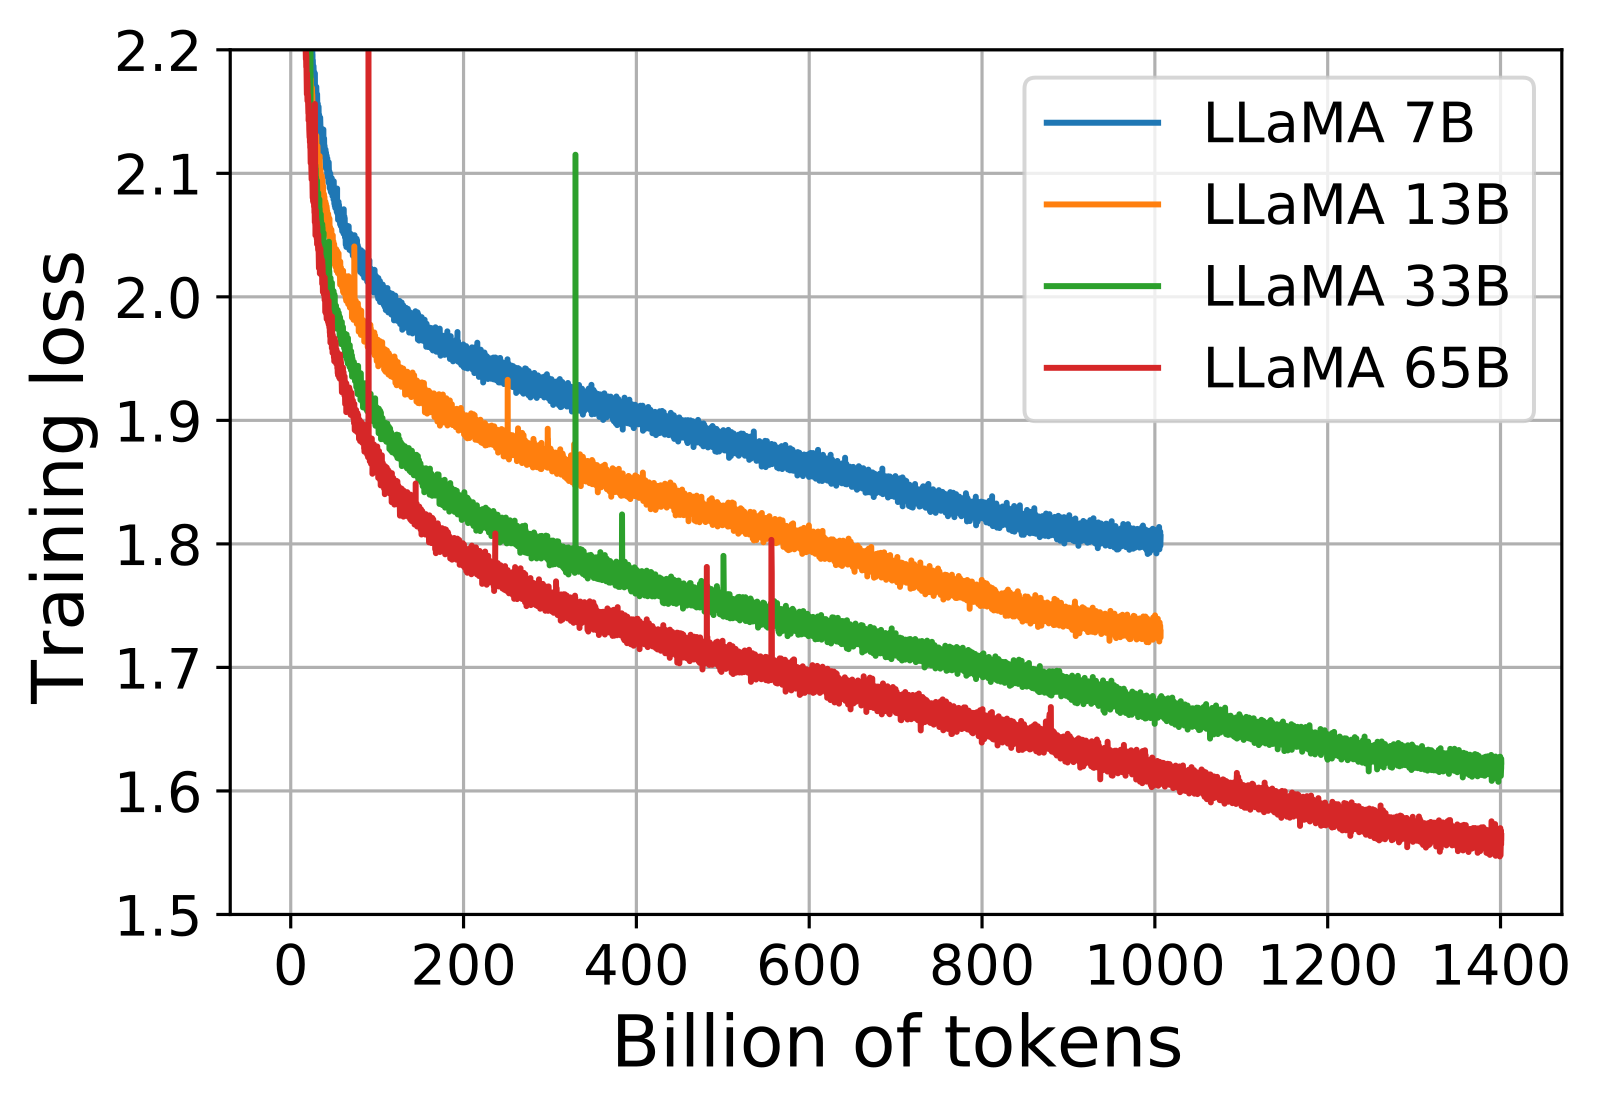
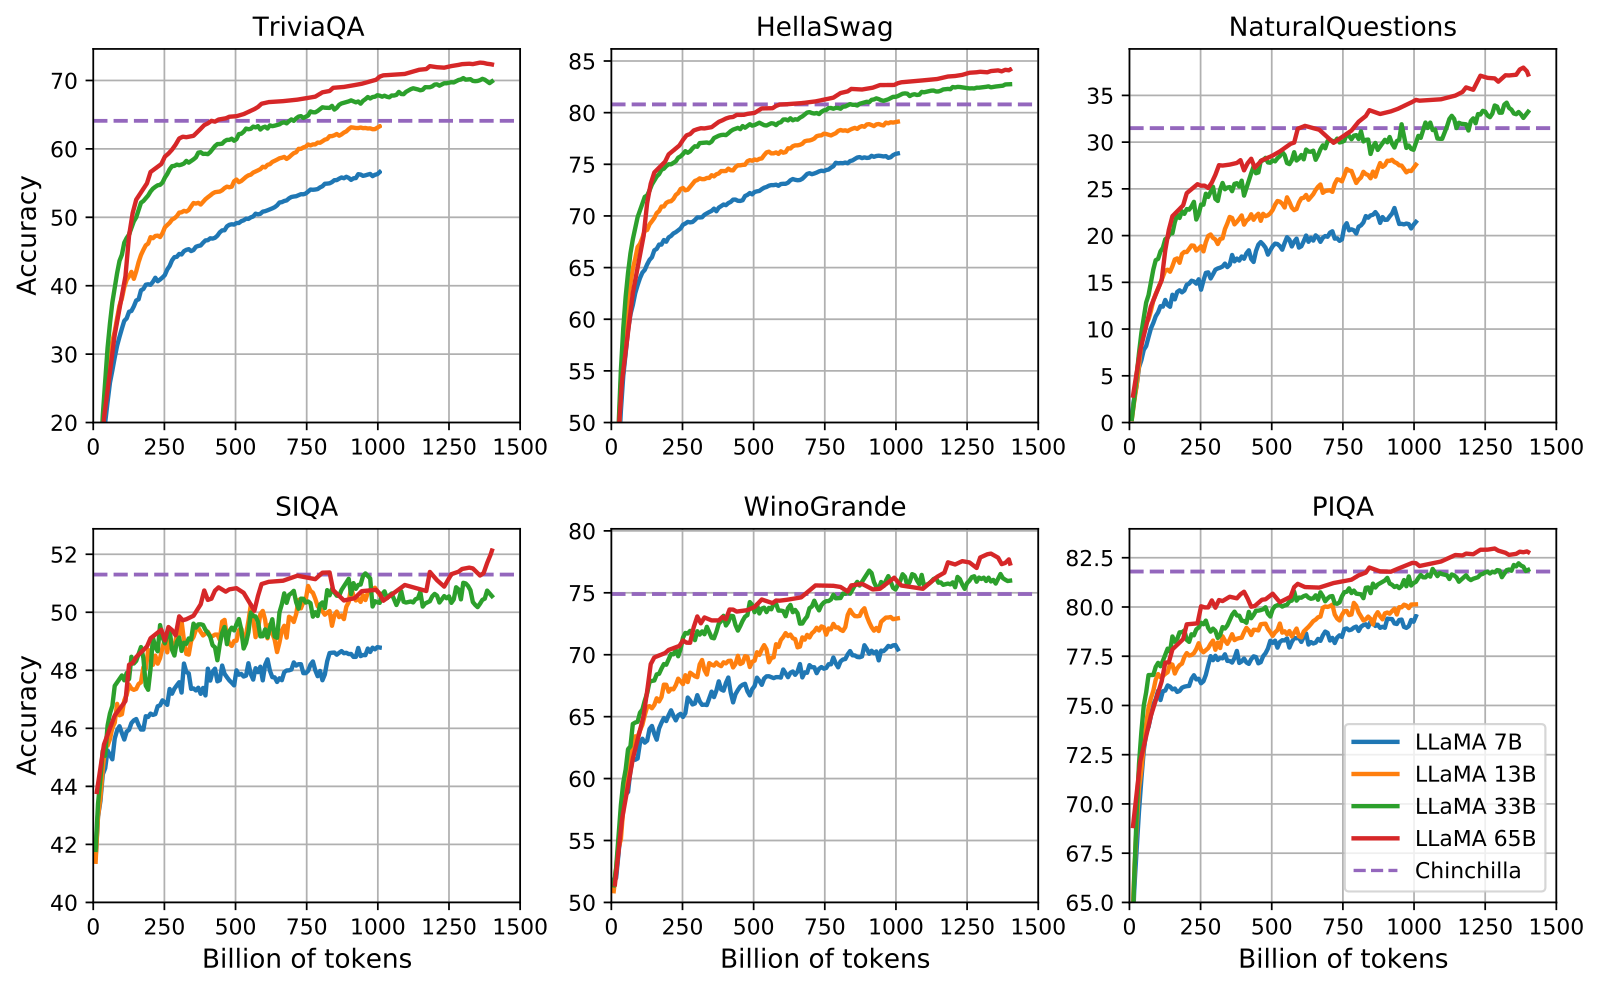
证据四:图1、图2,训练是否还有效。 损失持续下降,多数下游任务也改善,但SIQA波动较大,WinoGrande不完全随困惑度变化。它支持继续训练仍有收益,同时说明语言建模损失不是所有任务的充分代理。 训练损失横轴是已处理 token;7B、13B与较大模型的训练终点不同,横向必须对齐读取量,不能直接比较各自终点后宣称等预算。
证据五:表15与第6节,成本怎么报告。 65B主训练约1,022,362 GPU小时。碳排放按统一功率、PUE和美国平均碳强度估计,用于同假设比较;不是对各模型真实数据中心逐时电网排放的测量。完整研发投入也大于一次最终训练。
表4中NaturalQuestions零样本,33B为24.9、65B为23.8,也提醒读者单项成绩并非随规模严格单调。多表综合可以说明总体趋势,不能抹去局部反例。
五、单项成绩和公开来源不足以证明全面领先或可重训
它展示了复用成熟组件、改善数据处理、增加训练token,可以让中等参数规模模型获得更强能力。
公开来源数据让研究者更容易理解训练构成,但不等于每条清洗后样本、每次数据抽样与所有实验都已完整提供。原论文的研究访问安排也不能用后续版本的开放方式替代。博客关注技术结论,不据“Open”一词推导未核实的使用权限。
基础模型仍会产生不真实回答。表14的65B同时真实且有信息量比例为0.53,不能被MMLU或代码分数掩盖。偏差测试也显示特定类别问题;某个平均指标略好,不能证明对所有人群公平。
我的分析是,LLaMA所强调的部署经济性需要实际工作负载验证。相同质量目标可能因领域而变化:一个模型在常识上够用,不代表在专业知识上能替代更大模型。应先匹配所需能力,再比较上下文、吞吐、显存和总调用量。
六、沿基础模型直接延续到对话后训练
Llama 2直接延续基础模型并增加对话训练闭环。继续读时将基础能力与聊天偏好分别比较,尤其不要把GQA、训练量与人类反馈共同变化的结果归到某一个模块。
自测:能够回答,才算理解
1. LLaMA为什么不算推翻Chinchilla的训练配比结论?
答案:两者优化目标不同。Chinchilla主要问固定训练算力下怎样获得最好模型;LLaMA强调给定推理规模下训练得更充分。加入长期调用成本后,最优参数与数据组合可能改变。
2. 为什么不能把LLaMA的提升归因于RoPE或SwiGLU中的某一个?
答案:数据、预算、架构与实现共同变化,主文没有充分的逐项受控消融。可以解释每个组件的作用,但不能把系统级结果当成单组件因果证据。
3. 选较小模型时,应该怎样判断“训练更久值得”?
答案:先设定具体任务质量门槛,再比较满足门槛的模型训练或适配成本、目标硬件推理成本与预计调用量。不能只比较参数数目,也不能把一组基准的平均优势当作所有业务质量相同。