067 · Toolformer:用后文预测损失筛选值得学习的工具调用
返回目录 · 上一篇:BLIP-2 · 下一篇:LLaMA
论文:Timo Schick等,Toolformer: Language Models Can Teach Themselves to Use Tools,2023年。原始论文 · v1正文。论文v1将基础GPT-J记为6.7B,本文以模型名称识别配置,不据此推算精确参数成本。
先接住前作的问题
ReAct通过提示组织行动,PAL执行生成程序,但都未解决如何规模化产生调用训练标签。本篇让模型生成候选API调用,以工具结果能否降低原文后续预测损失筛选,再用普通语言建模学习调用模式。
五个前置概念
五个前置概念:API以约定格式接收参数并返回结果;自训练用模型生成数据继续训练;交叉熵衡量目标token的预测代价;消融移除功能以分析贡献;信用分配判断哪些早期行动促成最终收益。
一、问题设定:没有逐条调用标注,怎样学习何时使用工具
输出合法API格式只解决语法;模型还要选择工具、位置、参数并吸收结果。逐项人工标注昂贵,本篇把现有文本的后续token当监督信号,检查调用返回是否真的提供了额外信息。
Toolformer将这些决定统一表示为文本。调用包含API名、参数和返回内容,插在普通文本之间。推理时,模型写到结果分隔符,宿主程序暂停生成、执行API、插入结果,再恢复生成。因此工具结果来自外部执行,不是让模型继续伪造一个返回值。
与PAL主要通过提示要求生成程序不同,Toolformer会更新模型参数,把调用模式写入模型。与ReAct的多步观察行动相比,论文实际评价限制每个输入最多一次API调用;它不是成熟的多工具规划系统,也不能因为名称中有“工具”就把后来Agent的所有能力归给它。
二、用两个无结果基线隔离返回内容的预测收益
给定已有文本 ,通过少量人工示例提示模型,在可能有用的位置生成候选调用 。候选生成可以查看完整示例文本来做离线标注,但最终模型要学会只根据当前位置的前缀决定是否调用。离线看后文不是推理时获得未来答案,而是一种生成训练监督的方式。
执行调用得到结果 后,测量它是否降低后续原文的加权交叉熵。定义
是提供给模型的额外调用上下文, 让靠近插入点的token权重更高。论文使用随距离线性下降并归一化的权重,重点关注紧邻后文,而非整篇文章的长期任务回报。
然后比较
保留满足 的调用。 是调用序列化方式, 是最低收益阈值。取两种基线的最小值很重要:工具结果必须优于“完全没调用”和“只给调用参数但没结果”两种情况,避免把参数文字本身提供的提示误认为执行收益。
还有一个实现细节:筛选时,调用信息放在整段文本前面,以免未见过调用格式的基础模型被中途插入打断;训练数据中才将保留调用插到对应位置。这两个阶段的位置安排不同,不能机械地用最终训练格式复述筛选公式。
为什么筛选要同时比较两个无结果基线
设 为提供调用及工具结果后的后续文本损失, 为无调用损失, 为仅有调用参数的损失。保留条件基于 。如果只比无调用,参数本身复述了有用信息也可能被误算为工具贡献;取两个基线较小值,要求结果提供额外预测收益。筛选仍是语言预测代理,并不直接度量工具对用户任务的真实价值或成本。
教学算例。 时,表面上相比无调用改善2.2,但结果的新增收益只有0.2。若阈值为0.5,此调用应被删去。另一个调用把损失降到2.0便可保留,却可能耗时几十秒;原筛选目标没有自动完成延迟或权限优化。
原文是“每盒17元,买24盒,总计408元”。模型提议计算17乘24,结果408让后文数字更容易预测,因而调用被保留。若候选只是把“总计408”写进参数,但执行结果没有新信息,只有参数的基线可帮助识别这种虚假收益。
用打乱返回值区分工具格式与信息作用
在相同调用位置与参数下,可将正确工具返回替换成无关但等长内容,观察后续目标损失是否仍下降。若两者几乎一样,模型可能只利用了调用参数或格式,而未使用返回信息。这是新增的诊断建议,需要固定采样和文本目标;它不能代替真实任务成功率与工具延迟测量。
教法联系:Lilian Weng的LLM Powered Autonomous Agents。算例为本文自构。
三、生成候选、实际执行、筛选并插回语言训练
输入:普通语料C,基础模型M,各API少量示例
对每个工具和候选文本:
    预测适合插入API的位置
    在这些位置采样调用参数,丢弃格式不完整者
    执行调用,取得真实返回r
    计算有结果、无调用、只有参数三种后文损失
    若结果带来的收益超过阈值:保留
合并各工具调用,插入原文,得到C*
用标准语言建模损失微调M
推理时:
    生成调用到结果分隔符 -> 执行API -> 插入结果 -> 继续生成
数学损失仍然是下一token预测。机制变化在数据构造与推理执行;实验改善的是任务答对比例。不能把“预测损失下降”改称为已验证的用户满意度奖励,也没有一个学习工具调用成本的价值函数。
四、把API开关收益与解码调用阈值分开读
同模型API开关检验工具贡献,原模型对照检验微调代价;调用率还受标记阈值控制,不能只归因于学到的策略。
| 项目 | 原文设置与意义 |
|---|---|
| 工具 | Atlas问答、BM25维基搜索、四则计算、NLLB翻译、当前日期 |
| 基础语料 | CCNet子集;用启发式筛选更可能需要某工具的文档 |
| 数据上限 | 每种API最多25K例;筛选后不足则不能按上限当实际数量 |
| 微调 | 最长1024 token,batch 128,学习率1e-5,前10% warmup |
| 资源 | 八张40GB A100、BF16、ZeRO-3,最多2K步 |
| 检查点 | 每500步在1000例CCNet开发集测困惑度并选择检查点 |
| 对照 | 原GPT-J、只微调普通CCNet、Toolformer禁用API、启用API |
| 解码 | API标记进入前十候选即优先调用;每输入最多一次 |
工具本身带有外部能力与训练数据:Atlas是检索增强问答模型,翻译由专门模型完成。系统答对更多,不等于GPT-J内部突然学会全部知识。论文也在不同任务禁用可能带来明显不公平优势的工具:LAMA禁维基搜索,问答任务禁已用NQ训练的问答API。
评价不是统一严格exact match:LAMA检查前五词是否包含答案,开放问答检查前二十词,多语言任务检查前十词。阅读分数时应保留这些规则,不能直接与另一篇不同输出格式和评分器的数字合并排名。
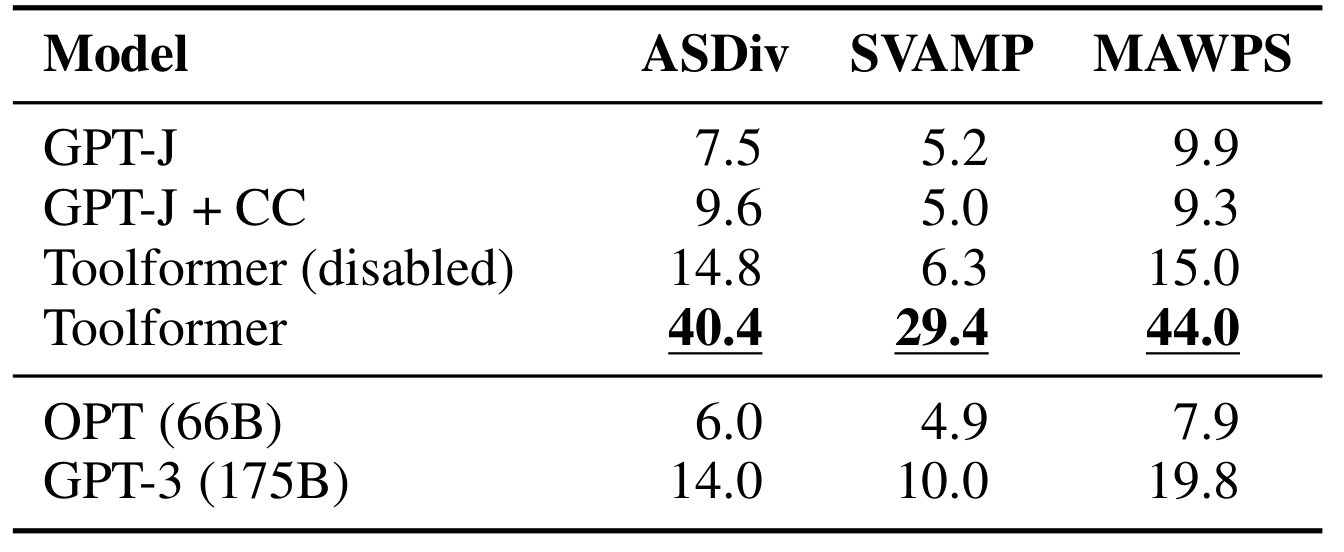
证据一:表4,计算工具的作用。 ASDiv上禁用API为14.8,启用为40.4;SVAMP从6.3到29.4。这支持工具执行在同一模型上的贡献,但不能证明多步数学推理已普遍解决。
证据二:表5,事实问答。 WebQS从禁用时18.9到26.3,仍低于GPT-3的29.0;TriviaQA为48.8对65.9。搜索有用,但不能弥补所有知识、检索和阅读差距。
证据三:表6,多语言负结果。 启用工具比同一Toolformer禁用时更好,但德语13.5低于原GPT-J的16.5,中文16.8低于18.2。工具收益与语料微调导致的分布变化可以同时存在,不能只挑有利基线。
证据四:表8,语言建模是否保持。 WikiText困惑度原GPT-J为9.9,普通CCNet微调与禁用API的Toolformer均为10.3;CCNet分别为10.6、10.5、10.5。支持的是API增强没有在该对照上额外恶化,而不是相对原模型所有数据都不退步。
证据五:表9,调用由什么决定。 WebQS将调用标记阈值从普通贪心的前一位放宽到前十位,调用率由8.5%升到100%,表现由19.3到26.3。实验能力由模型与解码规则共同产生;“自主决定”不能被误读为完全没有人为调用偏置。
表2还说明筛选成本:在阈值0.5时,维基搜索有207,241例,计算器仅3,680例。候选规模大并不自动形成平衡的工具训练集;某类工具的有用调用可能非常稀少。
五、局部续写收益仍不等于长期任务与成本最优
再换成“先查询库存,再决定采购量”,第一次查询的价值可能要经过后续决策才体现。局部后文损失未必能充分奖励这种链式流程。这两个自构例子分别说明方法擅长的直接信息补充,以及它缺少的长期信用分配。
它利用原文作为续写目标,不需要逐条人工标注调用时机。这使模型能在标准语言建模训练中学习工具格式与使用模式。
这种监督有鲜明偏好:立即帮助预测附近token的调用容易被保留,需要先探索、之后很久才有收益的行动不容易得到信号。第7节也明确指出不能链式组合工具、不能互动式改写搜索、没有把工具费用纳入调用决定。
我的分析是,局部预测收益可能偏爱“复述已有答案”的工具结果,而不奖励真正改变任务状态的操作。例如先创建一个日程、随后检查冲突,价值不一定体现在原文下几个token上。因此要把方法扩到有副作用的工作流,需要新的结果评价和权限边界,不能只换API名称。
工具可靠性也决定上限。错误检索、翻译失误或两位小数舍入,都可能传到最终回答。模型读到结果不等于已经验证来源。原方法训练的是利用工具,并未系统训练证据冲突处理、重试或独立核验。
六、把工具有用性进一步接到检索支持性
局部续写收益未直接证明证据可靠。Self-RAG把检索必要性和论断支持度也变成可学习输出;可比较两类自动标签的目标,检查工具调用是否真正服务最终问题。
自测:能够回答,才算理解
1. 为什么筛选要同时比较无调用与只有调用参数两种基线?
答案:参数文本可能已经泄露或提示后文。若只与无调用比较,会把提示效应误当成工具执行价值。要求带结果的损失低于两种基线,才能更有把握把收益归给返回信息。
2. Toolformer是强化学习算法吗?
答案:这篇方法不是。它用预测损失筛选离线生成的数据,再用标准语言建模微调,没有通过环境长期回报更新策略的RL步骤。工具调用看起来像动作,不代表训练方式一定是强化学习。
3. 如何证明模型学会按需要调用,而不是被解码规则推着到处调用?
答案:应固定模型改变调用阈值,报告调用率、答对率、无需工具任务的误调用和实际成本。表9说明阈值明显影响行为。还需要在确实不需工具和调用代价不同的任务上测试,单看启用后的最高分不足以证明选择最优。