066 · BLIP-2:用可训练的查询桥梁连接冻结的视觉与语言模型
返回目录 · 上一篇:Constitutional AI · 下一篇:Toolformer
论文:Junnan Li、Dongxu Li、Silvio Savarese、Steven Hoi,BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models,ICML 2023。原始论文 · v3正文 · 官方实现。
图表来源:Junnan Li、Dongxu Li、Silvio Savarese、Steven Hoi,2023,原文;CC BY 4.0。本篇展示做了PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。
先接住前作的问题
Flamingo用门控交叉注意力连接冻结两端。本篇是平行桥接方案:先训练查询提取文字相关视觉信息,再投影给语言模型;CLIP的匹配空间并非可以直接插入语言嵌入的通用坐标系。
五个前置概念
五个前置概念:跨注意力让查询读取另一组特征;软提示是连续嵌入而非可见文字;对比学习拉近匹配、分开不匹配;注意力掩码限制信息流;冻结参数停止更新权重但不一定停止对输入求梯度。
一、问题设定:冻结两端时,怎样把视觉特征变成可用语言条件
视觉特征和文字嵌入即使维度相同,坐标含义也不自动一致。桥梁不只要改变尺寸,还要挑出与文本任务有关的信息,并让冻结语言模型利用它;本篇把这两件事拆为表示学习和生成学习。
BLIP-2把对齐拆成两个问题。先让中间模块学到与文本相关的图像内容,再让这些内容适应冻结语言模型的输入分布。相比在语言模型内部插入大量跨注意力层,它通过输入侧的视觉软提示提供条件。
Q-Former有32个可学习查询,每个768维。查询通过跨注意力读取冻结图像特征,通过自注意力彼此交互,输出固定长度的 。这些查询不是用户临时写下的32个问题,而是训练得到的参数。
固定长度是一种信息瓶颈。它减少传入语言模型的视觉token,但也要求模型选择信息。查询不一定一一对应“人、桌子、汽车”等可命名对象;把它们想成32个固定类别检测器,会误解注意力表示的分布式性质。
二、用查询与三种掩码分开表示对齐和生成
Q-Former包含共享自注意力层的图像与文本分支,并按任务切换注意力掩码。BERT-base用于初始化已有部分,跨注意力部分另行初始化。完整Q-Former为188M参数,不能把它说成只有一个投影矩阵。
图文对比ITC让匹配的图像与文字表示接近。图像有多个查询输出,与文本表示分别算相似度后取最大值。为避免答案泄露,查询与文字在此目标下不能互相读取。
图像条件文本生成ITG让文字通过查询获取视觉信息。查询可以互看但不能读目标文本;文本可以看全部查询和此前文本。这样图像信息必须穿过查询瓶颈,而不能绕路直接读取视觉特征。
图文匹配ITM判断图文是否匹配,允许查询和文本双向交互,并采用有信息量的负例。这里允许交互,因为任务就是融合后判别;不能把ITC禁止交互的规则机械套到所有目标。
用简化符号写,对比目标的一侧为
是第 个查询输出, 是文本表示, 为温度。正式训练还包含另一方向和其他损失。公式说明它比较的是整批匹配关系,不是只让正例余弦相似度无限增大。
投影层把 转成语言模型嵌入维度,作为视觉软提示放到文本前面。对于OPT,使用以视觉提示为条件的自回归生成;对于FlanT5,将文本前缀和视觉提示交给编码器,以后缀作为解码目标。
教学化生成损失为
与LLM权重冻结, 和投影 更新。梯度仍需经过语言模型传回视觉提示;冻结主要省去大模型参数梯度与优化器状态,并不让其计算凭空消失。
同一桥梁,三种mask回答三种问题
对比目标要分别编码图与文后再匹配,因此query与文本不能提前互相交换答案;匹配目标允许双向交互,细查是否对应;生成目标让文本只看过去文本和视觉query,防止未来词泄漏。参数可以共享,信息可见性却必须随目标改变。第二阶段再将query输出投影为冻结语言模型的输入,视觉语言对齐与可生成语言不是一次损失就自动等价。
教学尺寸。 原文32个768维query输出共有24576个数;示例视觉骨干257×1024特征有263168个数,前者约为后者9.34%。这是接口尺寸压缩,不能解释成保留了9.34%的视觉“信息量”。若细小文字在压缩时丢失,大语言模型再流畅也无从可靠恢复。
想象图片里有一个人拿着蓝色杯子,桌上还有红色碗。用户问杯子颜色。视觉编码器提供局部与整体特征,查询模块需要保留杯子与蓝色的关联,LLM再生成“蓝色”。如果查询只保留“桌上有餐具”,再强的语言模型也不能从缺失信息中可靠恢复杯子颜色。
用遮挡目标词检查三种query接口
同一张图和文本“蓝色杯子”,在生成目标预测“蓝色”时,不能先读取目标序列中尚未生成的“杯子”;对比目标又应让图与文本各自编码,不能提前用对方答案提高匹配。把可见矩阵画出来逐项检查,比只确认三个损失都下降更能发现目标之间的标签泄漏。
教法联系:Jay Alammar的The Illustrated Transformer。算例为本文自构。
三、两阶段训练接口并追踪冻结网络的输入梯度
输入:图文对,冻结图像编码器,冻结LLM,可训练Q-Former
阶段一:
    提取图像特征
    按ITC掩码计算图文对比损失
    按ITM掩码计算匹配损失
    按ITG掩码计算文本生成损失
    联合更新Q-Former
阶段二:
    queries = Q-Former(图像特征)
    visual_prompt = projection(queries)
    将visual_prompt送入冻结LLM
    计算文本生成损失,更新Q-Former和投影层
推理:图片 -> 查询表示 -> 视觉软提示 + 用户问题 -> 文本答案
这里改善的目标包括跨模态表示和生成,而实验指标包括VQA准确率、CIDEr、SPICE及检索召回率。它们分别测不同输出,不能用“对齐损失更低”直接替代下游效果。
四、按VQA、参数口径与检索重排拆开证据
第一阶段消融定位接口训练,VQA比较定位任务效果;可训练参数、总参数和128候选重排成本要分别计算。
| 项目 | 原文设置 |
|---|---|
| 数据 | 129M图像,来自COCO、Visual Genome、CC、SBU与LAION子集 |
| 数据处理 | BLIP生成候选描述,CLIP排序后每图保留两条,训练时随机选择 |
| 视觉模型 | CLIP ViT-L/14或EVA-CLIP ViT-g/14,取倒数第二层特征 |
| 语言模型 | OPT或指令训练过的FlanT5;两者训练背景并不相同 |
| 步数 | 第一阶段250K,第二阶段80K |
| batch | 第一阶段ViT-L/g为2320/1680;第二阶段OPT/FlanT5为1920/1520 |
| 资源 | 最大配置在16张40GB A100上,两个阶段分别少于六天、三天 |
| 零样本VQA | beam宽度5、长度惩罚−1,倾向短答案 |
| 不确定性 | 主表未提供完整多随机种子置信区间,细小差值不能视为稳定优势 |
这些天数不包括CLIP、EVA、BERT与LLM原有预训练,也不应忽略合成描述及筛选成本。论文展示的是复用既有模型后的多模态增量训练效率。
“冻结”还需要按阶段理解:多模态预训练冻结视觉与LLM;在有监督描述和VQA微调中,视觉编码器与Q-Former会更新,LLM仍冻结;检索使用第一阶段模型,不需要LLM。把所有结果当成同一个始终冻结的模型,会误读表格。
证据一:表2,零样本VQA。 ViT-g加FlanT5-XXL的VQAv2 test-dev为65.0,Flamingo80B为56.3,绝对高8.7个百分点。但OK-VQA为45.9,低于Flamingo的50.6;作者将其与语言知识能力联系起来,这是解释性假设,不是单变量证明。
证据二:表1与表2,参数口径。 54倍少的说法来自10.2B对188M的可训练参数比较。表2生成配置还列出约108M可训练、12.1B总参数。不同阶段使用的模块不同,不能把108M、188M和总参数混为一谈,更不能声称模型总容量缩小54倍。
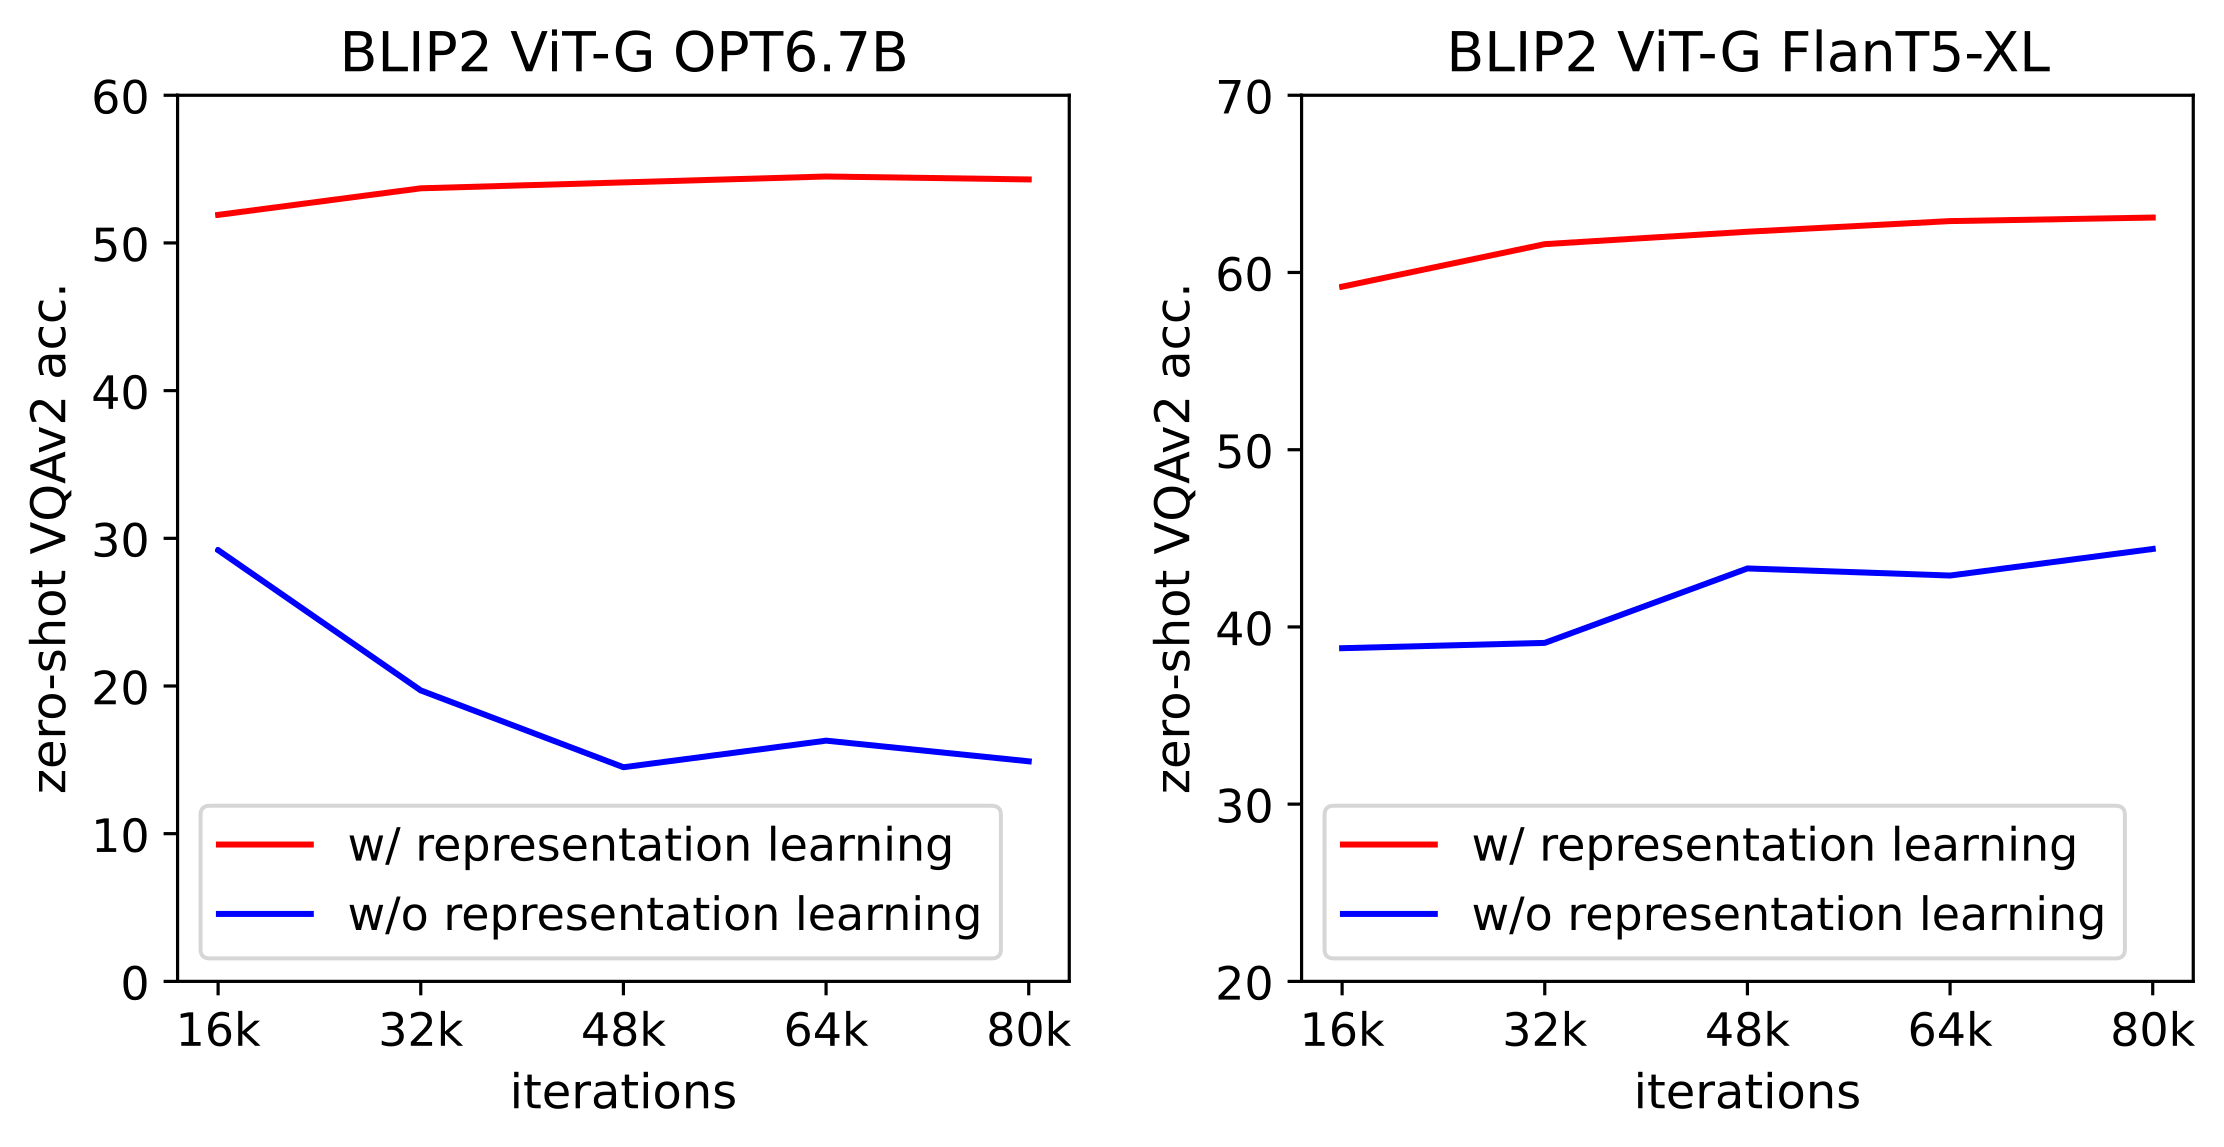
证据三:图5,两阶段是否必要。 去掉表示学习后,零样本VQA明显下降,支持先对齐表示的作用。正文把OPT表现退化称为灾难性遗忘,但其权重冻结;更准确的机制解释是接口训练后条件生成表现退化,不能据此说冻结参数被更新后遗忘了知识。 这张消融比较有无第一阶段视觉语言表示学习后的生成学习效果,定位的是桥接训练的作用;不能把它理解成冻结模型与全量微调的完整预算比较。
证据四:表6,生成目标帮助检索。 COCO微调加入ITG后,图到文R@1从84.5到85.4,文到图从67.2到68.3。该消融支持查询保留语言相关信息的设计,但对应检索微调,不是对第二阶段大语言模型的独立验证。
证据五:表5与§4.4,检索收益的计算条件。 图文检索先取128个候选,再以ITM重排。因此其召回率不能被直接当作纯双编码器一次向量检索的效果;额外融合计算属于系统成本。
五、固定查询带宽与基座知识限制视觉回答
这个自构例子区分了识别错误、信息压缩错误和语言生成错误。排查系统时,可以固定图片替换问题、固定查询改变语言后端,或检查更高分辨率输入,逐步确定瓶颈,而不是把所有失败都归为“LLM不够大”。
BLIP-2表明,强视觉模型与强语言模型之间可以用相对较小的可训练模块建立有效接口。两阶段训练不是简单叠加两个预训练模型,而是先学习提取信息,再学习传递信息。
与Flamingo相比,BLIP-2更适合展示单图与文本之间的模块化对齐;论文明确指出增加上下文VQA示例没有带来明显改善,并将其归因于预训练样本只有单个图文对。这个归因有合理性,但并未穷尽所有提示、结构和数据因素。
冻结语言模型也意味着其错误知识、偏差和生成习惯会被继承。视觉输入不能自动纠正模型对世界的误解。Q-Former若漏掉决定性细节,LLM可能用先验补全一段流畅但错误的回答。
我的分析是,固定查询数应作为信息带宽来检查。密集文字、多个相似物体、精细空间关系可能需要更丰富的表示。论文没有证明32个查询对所有分辨率与任务都足够,不能把“输出长度独立于分辨率”读成“分辨率提高不需要额外信息”。
六、对照更直接的视觉投影与指令数据
Q-Former提供复杂桥梁,LLaVA以更直接投影强调视觉指令数据。两者比较应拆开接口容量与监督信息,不能将数据差异造成的收益全归给连接器。
自测:能够回答,才算理解
1. 冻结LLM后,Q-Former如何得到训练信号?
答案:损失仍可对LLM输入求导,再通过投影传到Q-Former。冻结的是LLM权重更新,而不是把LLM从计算图中完全删除。若直接阻断这一梯度,生成损失就无法训练视觉接口。
2. 为什么三种目标要使用不同注意力掩码?
答案:ITC需要分别编码,避免匹配文字泄露到图像表示;ITG需要因果生成,让视觉信息通过查询传给文本;ITM则需要融合来判断细粒度匹配。掩码决定任务是否真的迫使模块学到所需信息。
3. “少54倍可训练参数”能否理解为少54倍总显存或训练时间?
答案:不能。冻结模型仍需存权重并执行前向,训练接口还可能需要经过LLM的输入梯度;数据处理也有成本。应分别比较总参数、可训练参数、优化器状态、激活、GPU时间和既有预训练成本。