058 · Flamingo:把图像和视频接入语言模型的上下文学习
返回目录 · 上一篇:Chinchilla · 下一篇:FlashAttention
论文:Jean-Baptiste Alayrac等,Flamingo: a Visual Language Model for Few-Shot Learning,2022。原始论文 · v2全文。
先接住前作的问题
CLIP给图文匹配分数,不能直接生成解释;Chinchilla会生成文本,却没有视觉输入。本篇组合这两类能力,研究冻结预训练两端时,怎样通过可训练接口实现图文少样本生成。
五个前置概念
五个前置概念:对比学习把匹配图文表示拉近;交叉注意力让一种表示读取另一种;冻结主干保持已有权重不更新;可学习查询用固定槽位汇聚可变长度特征;上下文学习在推理输入中示范任务而不改权重。
一、问题设定:冻结视觉与语言两端,怎样接收交错多图并生成回答
输入是交错的文字、图片或视频,输出是描述、问答文本,也可按候选答案概率分类。多张图片需要可控地接入语言上下文,测试示例则指定任务;本篇不输出机器人连续动作,也没有环境奖励或策略优化。
困难有三层:视觉特征数量随分辨率和视频帧数变化;预训练语言模型没有视觉输入接口;训练和测试可能出现不同数量的图片。作者希望在保留已有视觉与语言知识的同时,训练一个适合交错输入的连接机制。
“冻结”发生在多模态连接训练阶段。视觉模型此前已经用大规模图文对比学习训练,语言模型也经历了昂贵预训练。因此不能把Flamingo说成只花少量参数或32个例子就从零学会看图。
二、压缩视觉槽位并用零初始化门控接入语言层
视觉编码与Perceiver Resampler
视觉编码器采用NFNet-F6。图片变为二维空间特征,视频帧分别编码并加入时间信息,随后展平成特征序列。Perceiver Resampler用一组可学习查询读取这些特征,将不同长度输入压缩为固定64个视觉token。
直觉上,64个查询像64个可学习的信息槽位,而不是手工规定“第一个看人物、第二个看背景”。压缩降低语言层读取视觉信息的成本,但也可能成为细粒度文字、空间关系或长视频的信息瓶颈。
在冻结语言层之间加入交叉注意力
文本隐藏状态作为查询,视觉token作为键和值。新交叉注意力与前馈层插入原有语言层之间,通过门控残差接入:
是文本状态,是视觉表示,是初始化为0的可学习标量。初始时新增分支输出被关闭,模型保持原语言模型行为,随后逐渐学习视觉影响。它是稳定连接机制,不代表门控值本身是视觉可靠性的校准概率。
每个文本位置只直接交叉关注其之前最近的一张图片或视频。早期图片信息仍可通过语言自注意力传播,因此“只直接看一张”不等于“完全忘掉其他图片”。这种遮罩减少图片数量改变带来的结构差异:训练序列最多五张图片,测试可提供更多示例。
训练目标保持自回归文本预测
是不同图文/视频数据源,控制其梯度权重;表示当前文字之前的视觉输入。模型拟合条件文本概率,而非直接优化VQA准确率或CIDEr。不同数据源梯度累积后共同更新,避免简单轮流更新使训练目标偏移。
零门初始化为何不会把新接口永远关死
令插入块输出 ,其中 为插入前后的隐藏表示, 为待训练视觉交互模块, 为视觉特征、 为可学习标量。α=0时,输出确实保持原语言模型;但 ,门可先收到梯度,而F的参数梯度首步被零门压住。门打开后视觉模块逐步参与更新。这与完全删掉视觉分支不同,是温和接入新模态的优化路径。
以下为自构例子:先给一张桌上红杯图片和回答“红色”,再给蓝杯图片和“蓝色”,最后给绿杯问“什么颜色”。视觉编码器提供内容,连接层把内容送入语言状态,示例文本说明目标是颜色而非长描述。
若改成前两例都回答“可用于喝水”,模型会受到另一种任务示范。这说明上下文示例同时承担视觉证据和输出规则,但结果是否符合实际图片仍需要测试。可交换示例标签、遮挡杯子或加入无关图片,分别检查任务学习与视觉依赖;这些实验尚未运行。
零门首步还要看上游梯度与视觉方向
对零初始化标量门,首步门梯度是上游向量与视觉分支输出的内积。若两者分别为(1,−1)与(2,2),内积为0,门在这一样本上仍不更新;换成(2,1)才得到1。原公式说明门有可用梯度路径,不保证每个样本都使门打开;视觉分支权重首步受零门抑制则是另一件事。
教法联系:Jay Alammar的The Illustrated Transformer。算例为本文自构。
三、训练连接模块与交错序列,固定最近图片掩码
输入:预训练视觉编码器、预训练语言模型、交错多模态数据
冻结视觉和语言主干;初始化Resampler与门控交叉注意力
训练时对各数据源:
    将图片/视频帧编码为空间或时空特征
    Resampler压缩为64个视觉token
    按图文位置构造视觉因果遮罩
    在冻结语言层之间通过门控读取视觉token
    计算文本预测损失,按数据源权重累积梯度
    更新连接模块
测试时:串联少量视觉/文本示例和新问题,生成或评分答案
四、分开少样本、任务微调和连接频率的代价
先区分32样本推理与额外任务微调,再读门控和连接频率消融;不同输出指标不能混成一个准确率。
| 项目 | 原文设置及其意义 |
|---|---|
| 交错数据 | M3W约4300万网页,提取图片与文字相对位置;每段256token、最多五图 |
| 图文对 | ALIGN约18亿对,LTIP约3.12亿长描述图文对 |
| 视频文本 | VTP约2700万短视频,平均约22秒;视觉与文本采用统一序列标记 |
| 模型 | 3B、9B、80B,对应1.4B、7B、70B语言主干;视觉主干保持固定规模 |
| 优化 | 附录B.1.2:默认500K步,AdamW,5000步热身至1e-4;数据权重1.0/0.2/0.2/0.03 |
| 资源 | 最大模型1536颗TPUv4训练15天;不包含此前全部视觉和语言预训练成本 |
| 任务划分 | 16个基准,五个用于设计和调参,另11个不用于这些决策;支持集与查询集分开 |
| 指标 | 问答准确率、描述CIDEr及各任务特定指标;不能把所有数字直接平均成“准确率” |
| 重复与复现 | 主模型未报告多次完整训练误差条;代码和主要数据为私有,不能声称完整开放复现 |
零样本口径需要单独看:开放生成任务使用两条去掉图片的任务文本示例,因此是零视觉示例,不是完全没有任务示例。闭合候选任务不一定需要这两条文字。RICES检索示例与提示集成也有额外标注池和推理成本,应与普通32样本上下文分开比较。
证据一:表1的少样本增益与边界。 80B模型VQAv2从四样本63.1提高到32样本67.6,增加4.5个百分点;COCO CIDEr从103.2到113.8。它们分别是不同指标,后者不是113.8%准确率。32样本OKVQA57.8超过表中专门微调对照54.4,但VQAv2仍低于80.2,说明优势依赖任务。
证据二:表3的数据消融。 缩短训练的3B配置总体归一化分数70.7,去掉M3W降至53.4,去掉图文对为60.9;去掉视频文本后MSVDQA36.3降至34.5、VATEX53.4降至46.0。不同格式互补得到支持,但删数据也改变计算量,不能把差距全解释成唯一的数据结构因果效应。
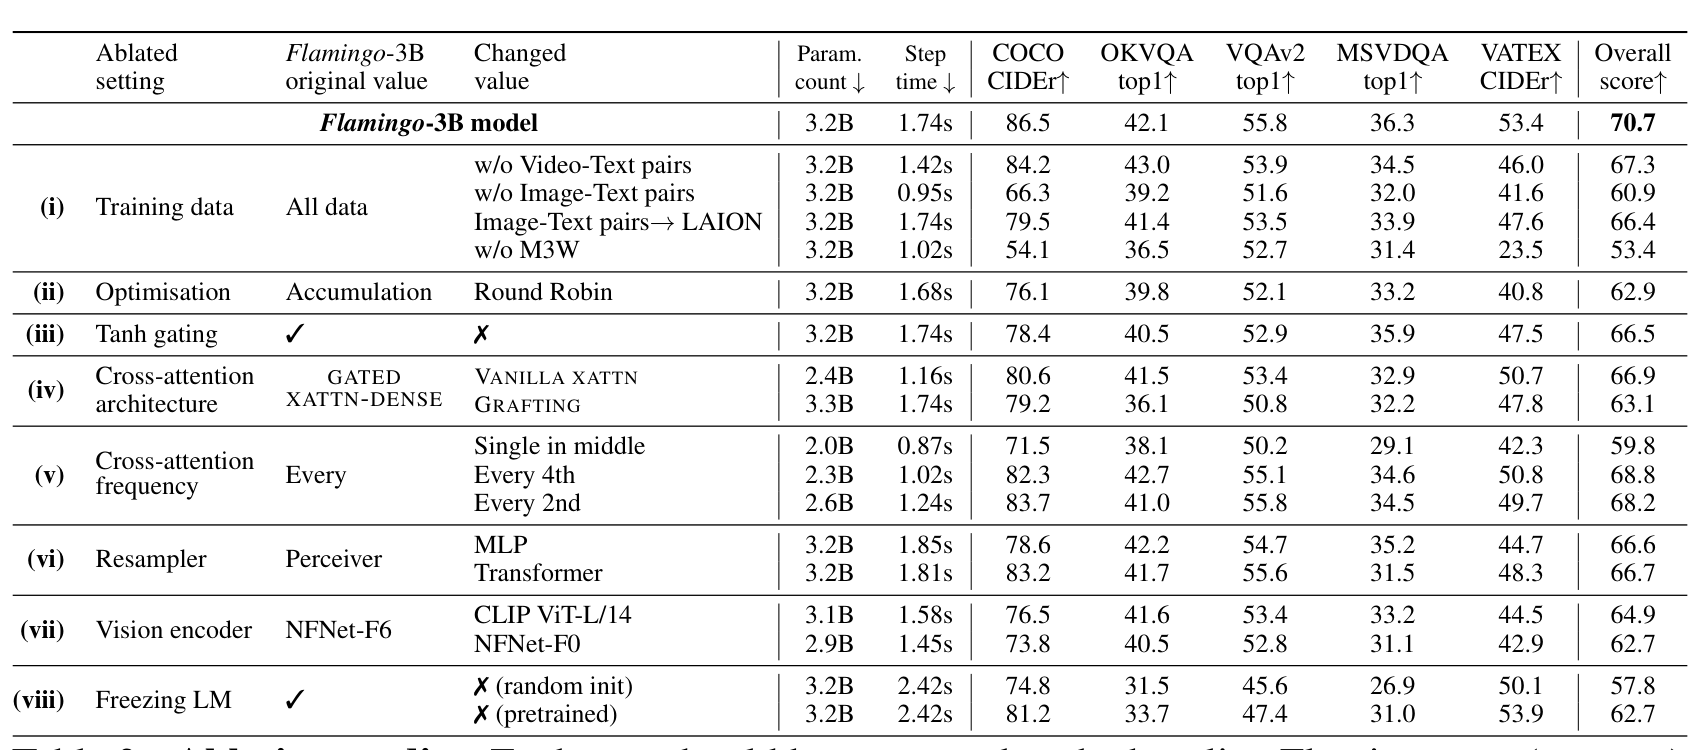
证据三:表3的门控与冻结。 去掉零初始化tanh门控,总体分数70.7到66.5;解冻预训练语言主干的对照为62.7,单步时间从1.74秒变为2.42秒。这支持本训练预算下稳定保留预训练知识的设计,并不能证明所有多模态训练永远应该冻结语言模型。
证据四:表3的连接频率。 每层加连接的配置为1.74秒/步、70.7分;每四层加一次为1.02秒、68.8分。按表计算单步时间下降约41.4%,吞吐比约1.71倍;原文“加速66%”是另一种近似速度措辞,不应直接解读成耗时减少66%。这体现参数、速度与质量的实际取舍。
证据五:表2的微调上限。 在额外任务数据和权重更新下,VQAv2 test-dev达到82.0、VATEX达到84.2,而32样本分别67.6、65.1。说明预训练模型仍能从专门适配获益。两行的标注预算与训练方式不同,不能把微调结果作为无需更新权重的能力宣传。
教学算例。 一维h=2、F=3,门α=0时输出2;若损失希望输出5,则对α的梯度为 ,梯度下降会把α推向正值。后续F也开始学习。该例只说明接口可训练,不保证视觉内容被忠实使用;仍需遮挡或换图对照。
五、视觉条件仍不能保证事实可靠或动作控制
架构并非简单给语言模型附一张图片,而是压缩视觉长度、控制跨模态信息注入和匹配交错训练数据的组合。
模型仍继承语言模型的幻觉与偏差,可能输出与视觉证据不符的细节。低帧率与固定视觉槽位也限制细微动作和小字信息;视觉问答正确并不保证有精确定位或物理因果理解。分类任务和专门微调模型的差距也不能用开放生成优势掩盖。
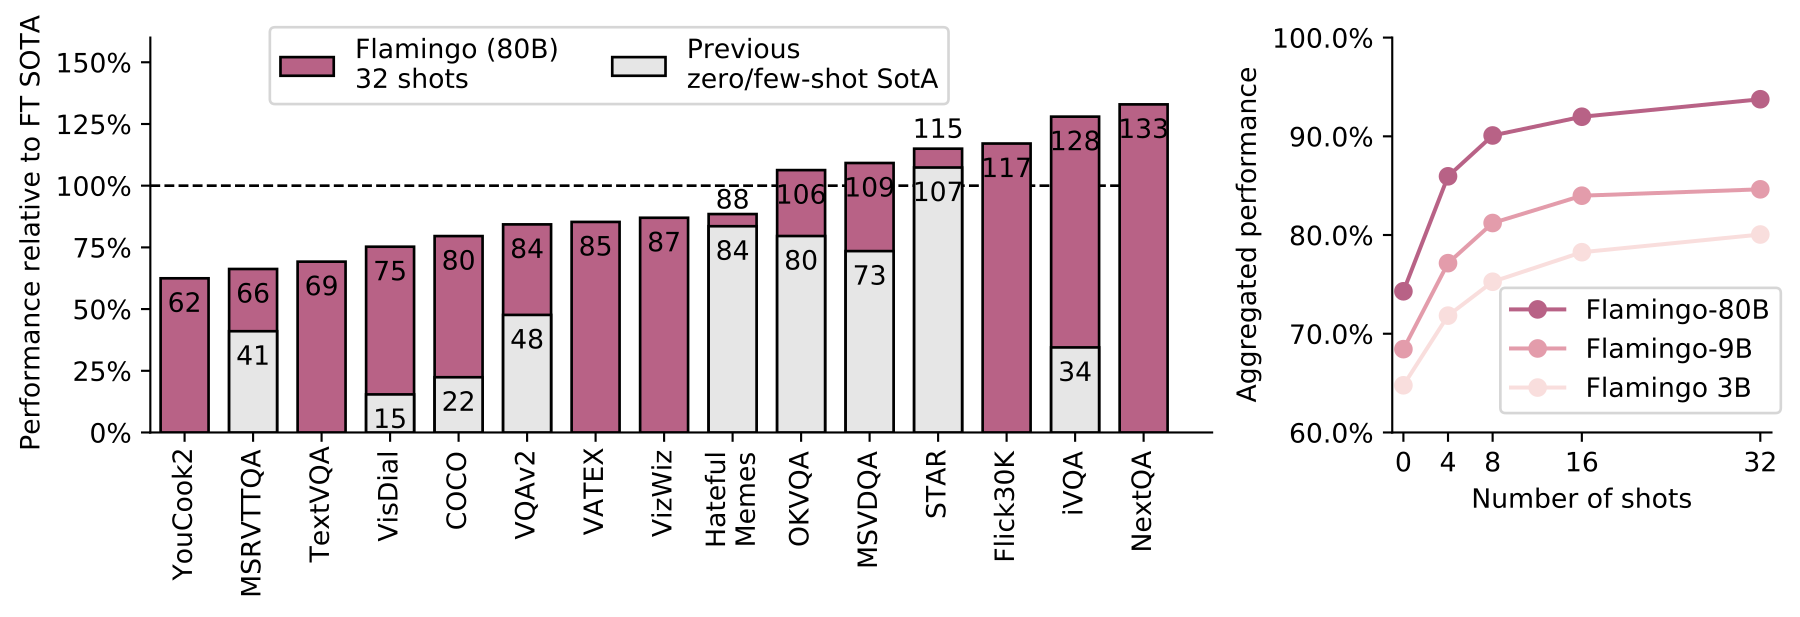
原文存在一处统计表述差异:主文与图2说六个任务超过微调最佳,表1图注写七个。本文不凭猜测统一计数,采用具体任务与行列数值作为证据;这也是阅读时保留版本和评价口径的原因。 左图比较任务结果,右图考察模型大小与上下文示例数;32-shot 描述使用时的示范量,不包含通用图文预训练。
六、对照冻结两端的另一种视觉桥接方式
门控交叉层并非冻结两端的唯一桥梁。BLIP-2通过查询与两阶段对齐提供平行方案;比较时应控制视觉输入形式、可训练参数和上下文示例能力,而非只比总模型大小。
自测与参考答案
1. 两个主干冻结,为什么仍需要大量训练?
答案:冻结只省去主干参数更新,连接层仍需学习视觉特征与语言状态的对应,以及多图任务格式。主干前向计算仍在,新增模块也不小;此前视觉和语言预训练成本更不能忽略。
2. 每个文字位置只直接看最近图片,是否无法利用之前图片?
答案:不等于无法利用。之前文字状态已融合早期视觉信息,后续语言自注意力可读取这些状态。直接视觉连接受限,但间接依赖保留。是否足够支持复杂跨图关系,需要专门评估。
3. 32样本击败某个微调模型,能否说明总训练数据减少上千倍?
答案:只能比较任务特定标注使用量。Flamingo已经使用海量通用图文、视频及语言预训练,成本远超这32个示例。公平结论应分别列通用预训练、任务适配数据、推理上下文与模型规模。