059 · FlashAttention:少搬运数据,让精确注意力更快
返回目录 · 上一篇:Flamingo · 下一篇:ReAct
论文:Tri Dao等,FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,2022。原始论文 · 全文 · 官方代码。本文讨论初代论文,不能把后来版本的硬件支持和速度直接移植过来。
先接住前作的问题
Transformer的稠密注意力产生平方规模中间矩阵,Performer用核近似、BigBird删边减负。本篇走平行的精确实现路线:保留连接和函数,用存储层级与重计算减少HBM访问。
五个前置概念
五个前置概念:HBM是GPU大容量显存;SRAM是快速片上存储;内核融合减少中间结果往返;在线归约逐块合并统计量;重计算以额外运算换取保存空间和带宽。
一、问题设定:注意力函数不变,怎样少搬运平方规模的中间矩阵
FLOPs只计运算,不计数据在显存与计算单元之间往返。若能在小片上存储中分块算完并合并结果,就可能多算一些而更快;本篇需同时证明数值函数一致、额外保存空间下降,以及真实硬件时间受益。
二、推导在线softmax合并与分块反向
设输入,为序列长度,为单头维度。标准注意力为
普通实现依次产生分数矩阵、遮罩后矩阵、softmax概率和dropout结果。许多操作不是大规模矩阵乘法,而是逐元素或归约计算,容易受显存带宽限制。完整矩阵既占空间,又会被多次读写。
GPU的HBM容量大,但片上SRAM更快且小。FlashAttention围绕这一级差异设计。与Linformer、Performer等近似方法相比,它没有改变密集注意力公式;与一般激活检查点相比,它还把重计算与片上融合结合起来,避免重算后仍大量落回显存。
这是一篇系统算法论文,不是新的强化学习策略或损失。输入输出仍是注意力张量,成功指标是正确性、峰值内存、内核延迟及达到同等任务质量的训练时间。
对一行分数,稳定softmax需要减去最大值。分块处理时维护三个量:已处理分数最大值、指数和、未归一化加权输出。
遇到新块,令
旧的累计值乘上,使新旧块拥有同一个指数基准。若直接把各块独立softmax后的输出平均,分母不同会得到错误结果。上式为单行教学表达,论文算法1实际按矩阵块保存归一化输出与行统计。
定理1说明算法返回标准注意力输出,FLOPs为,除输入输出外额外保存统计量。总输入输出内存仍为,不能只引用说整个模型只占线性常数空间。
定理2在的片上容量设定下给出HBM访问量,标准实现为。按其计算模型中的存储容量理解。它证明数据搬运减少,未把密集注意力FLOPs变成线性。
论文还提出块稀疏版本,跳过指定零块。这时注意力连接本身改变,属于另一种近似/稀疏算法。密集FlashAttention的精确性与块稀疏版本的更长序列成绩必须分别表述。
反向也只需要块与少量行统计
令 为一行已缩放且应用合法掩码的分数,, 为对应值向量,输出 。对可微损失 ,上游梯度 给出分数梯度 。保存o和归一化统计后,可以逐块重算p并累积Q/K/V梯度,而不保留整行概率矩阵。这是原文“多算一点、少搬很多”的反向原因;精确算子仍有平方数量的相互作用,IO降低不代表算术复杂度变线性。
以下为自构例子:分数为0与,值为2与10。正确权重为1/4与3/4,结果8。若分两块,各块独立softmax都为1,然后平均得到6,显然错误。
在线方法保留指数和并统一最大值,最终仍得到,无需保存两块的完整概率。真实矩阵计算把这个规律用于每一行,片上块处理则决定是否真的加速。
分块合并必须同时校正分子和分母
若旧块最大值从0变成新最大值log 3,旧指数和与旧加权和都要乘1/3。只重缩放分母而保留旧分子,会改变旧值对输出的贡献;只检查指数和大小无法发现全部错误。可先用两个值不相等的小块测试,再比较前向和梯度,这正对应在线softmax保留两种统计量的原因。
教法联系:Lilian Weng的Large Transformer Model Inference Optimization。算例为本文自构。
三、围绕片上容量安排分块、重计算和正确性检查
输入:HBM中的 Q,K,V,片上可用容量
根据容量选择Q块与KV块大小
为每行初始化最大值m、指数和l、输出O
对每个KV块:
    加载K、V到片上存储
    对每个Q块:
        加载Q块、对应输出与统计量
        计算当前分数块,应用缩放与因果/填充遮罩
        求局部最大值与指数和
        重新缩放旧累计量,合并新块加权输出
        写回输出与行统计,不写完整注意力矩阵
反向传播:利用输入与保存的行统计在片上重算所需概率块
反向传播需要注意力概率,但不必一直保存它。论文选择存储较小统计量,反向再计算局部概率与梯度。额外FLOPs换取更少HBM读写,是本篇最重要的系统思路。
“精确”表示没有低秩或稀疏近似地改变注意力算子。浮点计算顺序改变仍可能带来舍入差异,因此不是保证每个bit与任何实现完全一致。正确验证应比较数值误差、梯度以及训练曲线,而非只看程序有没有报错。
梯度教学例。 概率为 ,标量值2、10,输出8,上游g=1,则分数梯度为−1.5与+1.5,总和为零。分块反向应复现这两个数;只核对前向输出为8不足以证明训练内核正确,错误的重缩放可能只在反向暴露。
四、按算子、整模型和上下文变化分别核算加速
IO图直接检验搬运假说,整模型表检验端到端收益;更长上下文带来的质量变化要与算子等价性分开。
| 项目 | 原文设置与证据用途 |
|---|---|
| 内核分析 | A100,序列1024、头维64、16头、批量64;记录FLOPs、HBM读写和前反向时间 |
| BERT | 8×A100,同MLPerf初始化与数据划分,达到72%掩码语言建模目标;十次运行 |
| GPT-2 | small/medium,OpenWebText,8×A100;与HuggingFace和Megatron实现比较 |
| LRA | 序列1024—4096;比较准确率、吞吐与训练时间,包含近似和稀疏对照 |
| 长上下文 | GPT-2从1K到4K;长文分类与Path-X/Path-256验证可行性 |
| 算子设置 | 内核基准包含dropout与padding mask;显存/时间依长度分别绘制 |
| 重复范围 | BERT明确十次;不能把它推广为所有训练都报告同样重复统计 |
| 可比边界 | 内核速度、端到端训练速度、更长上下文带来的质量收益是三种不同结论 |
证据一:图2直接检验IO假说。 指定GPT-2 medium注意力配置下,FLOPs从66.6增加到75.2 GFLOPs,HBM读写从40.3GB降到4.4GB,时间41.7ms降到7.3ms。按数值计算约5.7倍加速,同时运算量增加。它直接反驳“FLOPs更多一定更慢”,但不是整模型的5.7倍加速。 左面板计前向加反向,中面板只计前向,右面板换成4K序列的块稀疏算子;三幅图不能直接当作同一配置的三次测速。
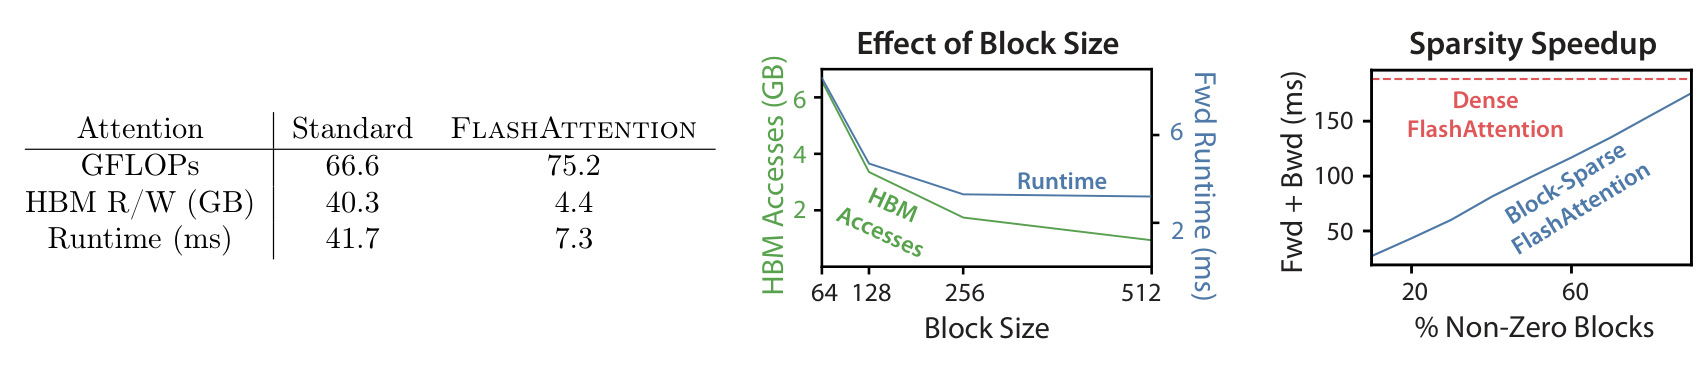
证据二:表1的同质量BERT。 达到同一72%目标,20.0±1.5分钟变为17.4±1.4分钟。耗时减少13%,吞吐比约1.15倍,这解释原文“15% faster”的口径。不能写成时间减少15%,也不能把它描述成从随机初始化完成全部BERT预训练只需17分钟。
证据三:表2的GPT-2。 small模型困惑度都为18.2,HuggingFace9.5天、Megatron4.7天、FlashAttention2.7天;medium分别21.0、11.5、6.9天,困惑度14.2/14.3/14.3。对small的9.5/2.7约3.5倍,是表格中的具体配置,摘要的约3倍只是概括。质量近似一致支持算子等价实现的用途。
证据四:表4区分算子与上下文收益。 GPT-2 small在1K上下文为18.2困惑度、2.7天,4K为17.5、3.6天;Megatron1K为18.2、4.7天。0.7困惑度改善来自可负担的更长上下文,不是同一个注意力数学表达突然提高模型能力。
证据五:表5/表6的长序列边界。 MIMIC微F1从512长度52.8提高到16K的57.1;ECtHR在8K为80.7,16K反降至79.2,说明上下文越长并非每次更好。Path-X的61.4使用密集版本,Path-256的63.1使用块稀疏版本,且有Path-64预训练迁移,不能忽略辅助训练。
五、IO收益仍受硬件和平方计算限制
它使“更好的实现”成为扩展上下文的重要手段。
工程代价是低层CUDA开发、块大小与寄存器/共享内存安排、不同硬件架构适配,以及新遮罩或注意力变体需要额外实现。原论文§5明确强调可移植性与开发成本。理论IO优势也不保证所有小张量和设备上的相同比例收益。
密集版本仍需处理所有合法查询键组合,极长序列的平方计算会成为瓶颈。对自回归单token解码,形状、KV缓存与瓶颈不同,不能仅凭训练前反向基准推断其服务性能。后续系统优化需要针对真实工作负载重新测量。
六、从精确算子转向服务时的KV内存管理
单次算子搬运优化之后,vLLM管理不同请求的KV布局,GQA改变缓存共享结构。它们可组合,但瓶颈转移后加速倍数不能简单相乘。
自测与参考答案
1. 为什么多做重计算反而更快?
答案:当带宽是瓶颈时,重新计算一块概率可能比从HBM读取保存矩阵更便宜。是否值得取决于计算速度、数据复用、块大小和内存层级,不能把它推广为所有计算都应重算。
2. FlashAttention是否把注意力复杂度从平方降成线性?
答案:密集版本的FLOPs仍为。主要减少中间矩阵存储及HBM访问,内存占用可随序列线性增长。块稀疏版本进一步跳过连接,但改变算子,是另一个前提。
3. 如何设计一个能检验真实收益的对照?
答案:先固定QKV、精度、遮罩与dropout,核对输出和梯度;再固定模型、数据、训练目标和硬件,比较达到同质量的时间与峰值显存。最后单独改变上下文长度测任务收益,避免把结构或预算变化混入纯实现加速。