015|Transformer:用注意力连接序列位置,让训练不必逐步递归
论文:Ashish Vaswani 等,Attention Is All You Need,NeurIPS 2017。原文 · PDF。本文讨论原始编码器—解码器 Transformer;后续 decoder-only、Pre-LN、旋转位置等变体应另行区分。
先接住前作的问题
Bahdanau注意力让解码器动态访问多个源位置,却仍依赖循环状态逐步计算。未解的问题是:能否把可微读取扩展为序列内部的主要交互,同时取消训练中的递归依赖?Transformer直接承接注意力思想,并组合LayerNorm和Adam;这些模块并非本篇重新发明。
五个前置概念
五个前置概念是查询键值、因果掩码、多头投影、残差连接和条件生成。理解这些比死记层数更重要,因为后续论文通常是在这些接口上改变资源与信息路径。
一、问题设定:远距信息怎样直接交互,同时去掉训练中的递归依赖
循环模型让远处词通过多步状态传递,还要求后一步等待前一步。注意力可缩短相关位置之间的路径,取消递归又能让已知训练序列的多个位置并行;这两项收益相关但不同。顺序信息与解码因果性仍需由位置表示和掩码明确提供。
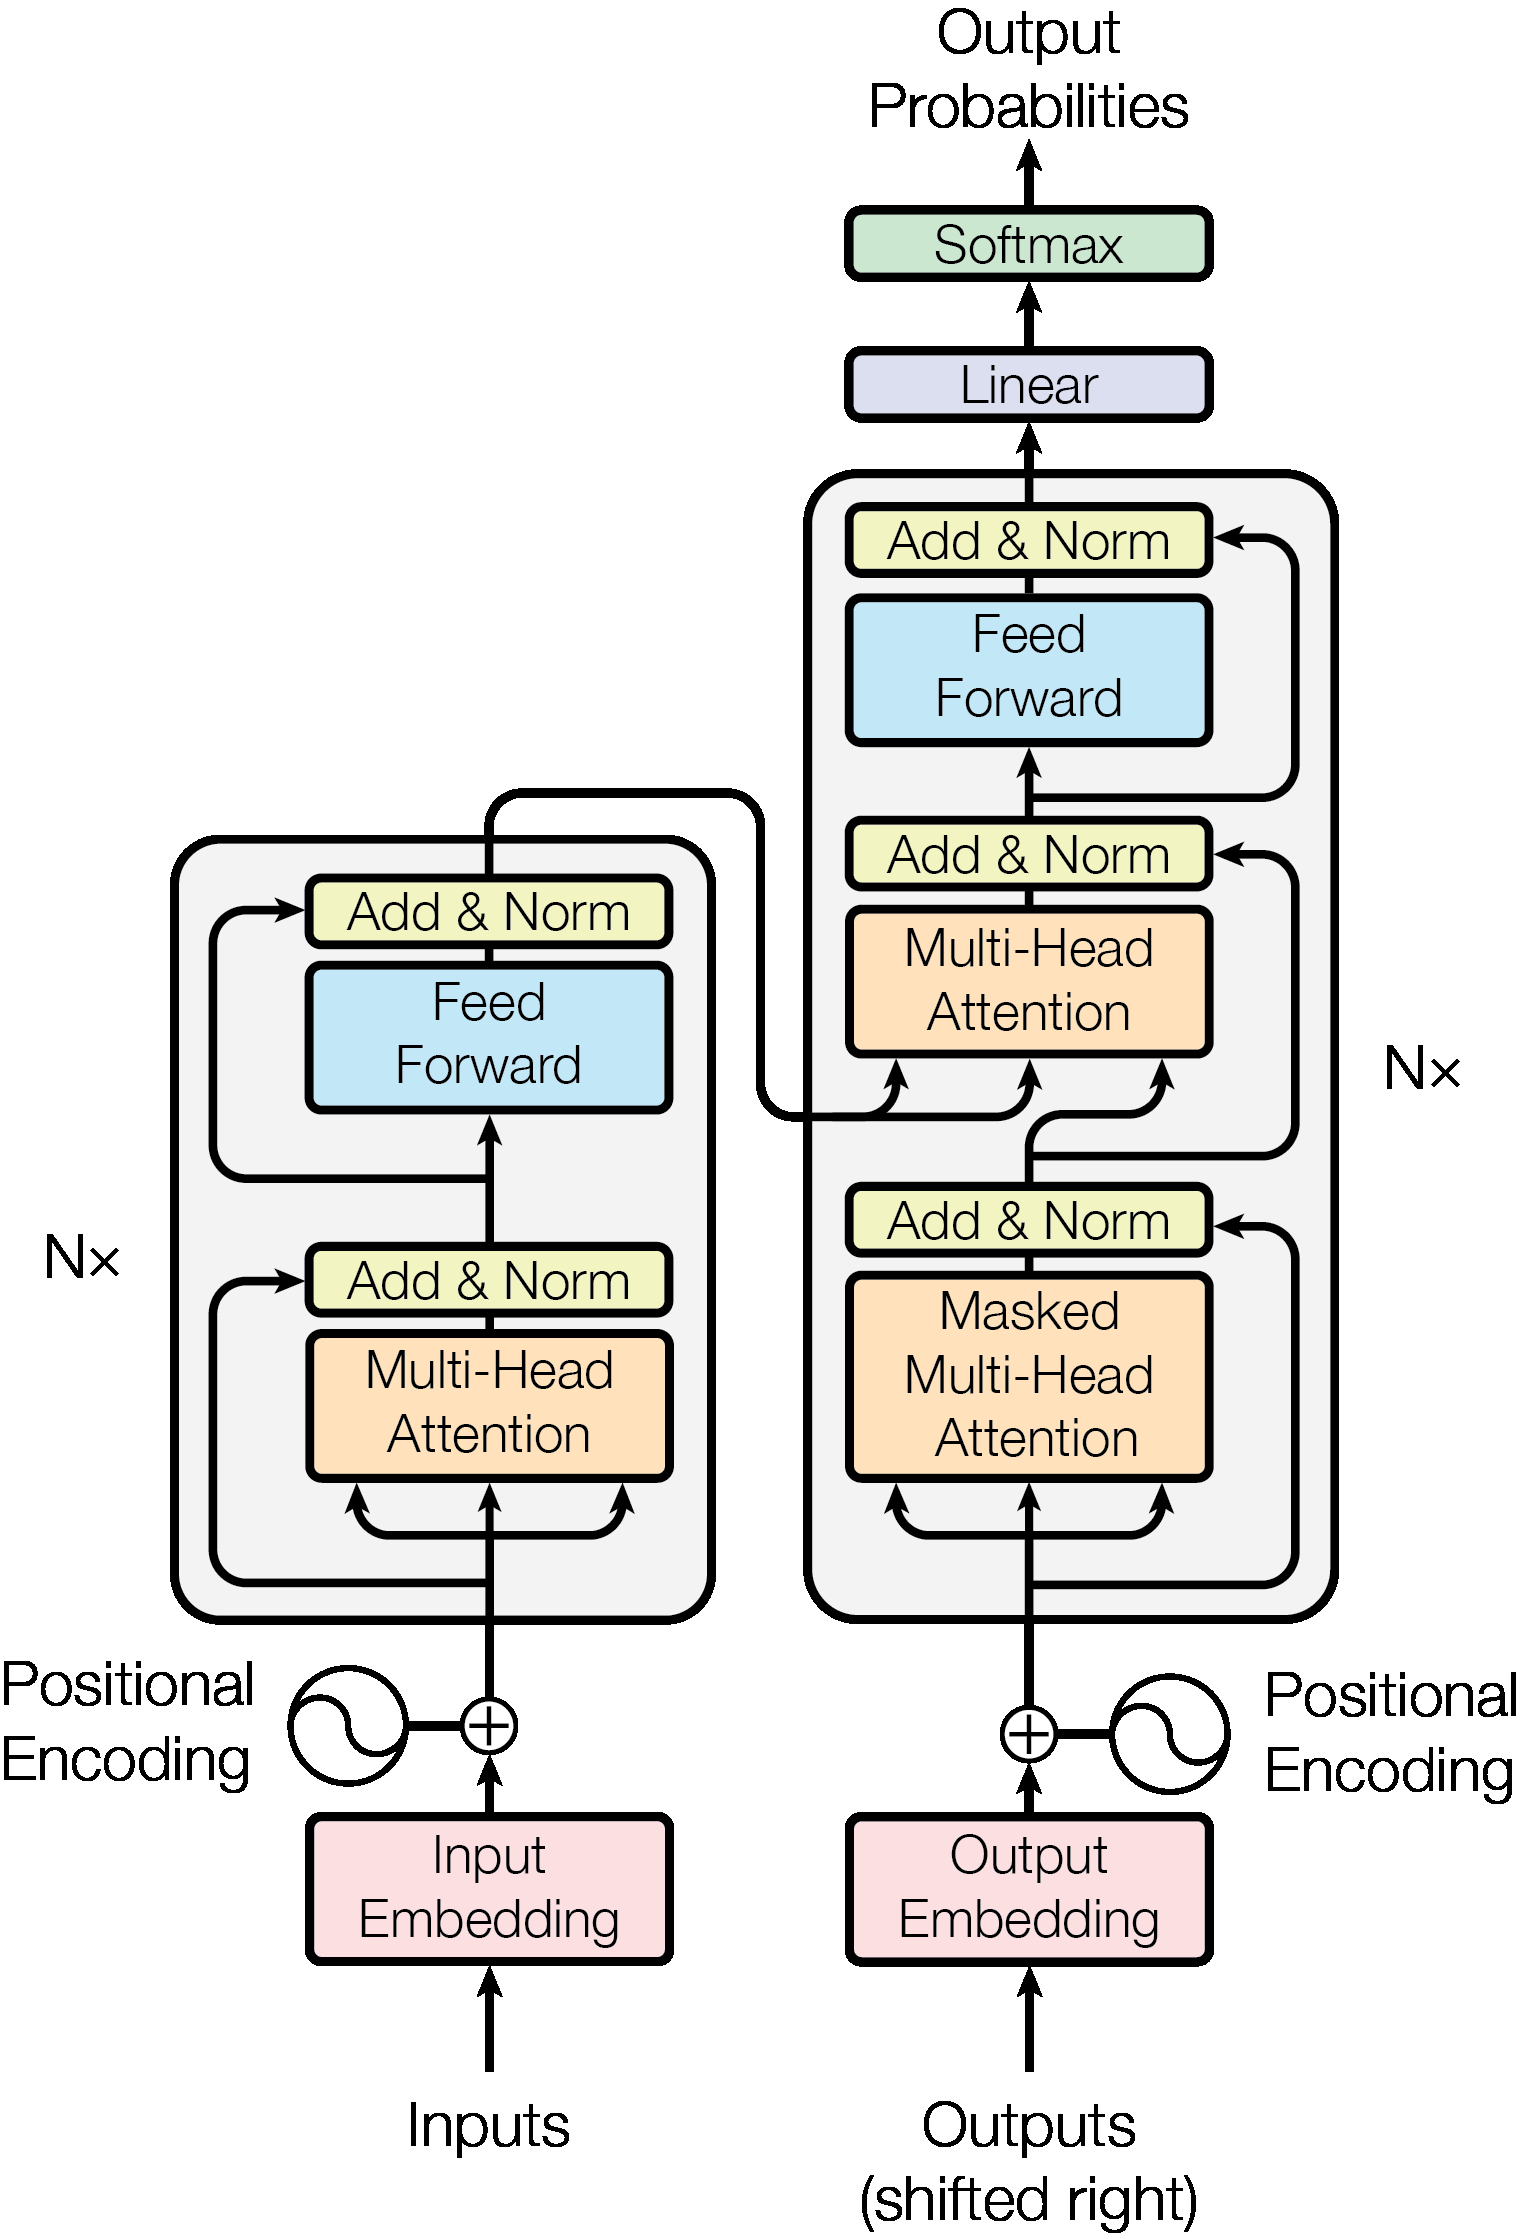
原模型仍分编码器和解码器。编码器可以访问全部源句,解码器对目标前缀使用因果 self-attention,并通过 cross-attention 读取编码结果。后来的 GPT 主要保留因果解码路线;不能把所有 Transformer 都画成只有一种掩码的方块。
模型优化条件翻译似然。所谓“attention is all you need”是论文标题,不应按字面理解为系统真的只有注意力:前馈层、残差、归一化、位置、嵌入和优化配方都是重要组成。
二、从查询键值、缩放和掩码推到多头交互
为查询, 为键, 为值, 是键维度, 为掩码。分数比较查询和键,softmax 形成权重,再对值加权。缩放因子缓解维度增大时点积尺度过大、softmax 容易饱和的问题。
多头注意力使用不同投影,在多个子空间计算,再拼接并投影。它允许不同交互模式,但不保证每个头都对应一个可命名的语法功能,也不保证头数越多越好。每头维度、总隐藏维度和参数预算需要一起考虑。
位置编码打破不含位置时的排列对称性。原论文使用正弦余弦方案并比较可学习位置表示。位置编码提供辨别顺序的输入,不是自动证明模型能够外推到任意长序列。
逐位置前馈网络通常包含两次线性变换与非线性;它对每个位置独立处理同一组参数。注意力负责位置交互,前馈负责局部特征变换,但整个功能不能完全分割,因为多层复合后两者共同塑造表示。
从维度检查到缩放推导
若本层输入 ,单头 、,其中 是序列长度、 是模型宽度、 是键和值的单头宽度; 表示单个查询和键向量。权重矩阵为 ,输出为 。假设各坐标独立、均值0、方差1,点积 的方差为 ;除以 后恢复单位量级。它是控制初始尺度的统计动机,不是训练全过程都保持独立同分布的保证。多头把总宽度切到多个子空间,不能在比较时偷偷让每头都保留全宽。
教学数值例。 两个缩放后分数为 ,softmax权重就是 。若对应值为 与 ,读取结果为 。键决定配多少权重,值决定读出什么;把第二个值换掉而不改键,权重完全不变,输出却会改变。这也说明注意力热图不等于完整的因果解释。
用同一套尺寸读懂图1的三种注意力
取一个自构小模型:源句5个位置、目标前缀3个位置,模型宽度8,4个头,每头键和值宽度均为2。编码器自注意力的分数矩阵是 ;解码器因果自注意力是 ;交叉注意力的查询来自目标、键值来自源,因此是 。softmax沿每一行的键位置归一化,不沿查询行,也不沿特征通道。交叉读取后每头输出 ,4头拼接回 ,再经输出投影,才能和同形状的残差相加。
沿原图1追箭头时,可以给左下、右下、右中三个注意力框分别写上这三个尺寸:右中框不会因读取5个源位置就产生5个目标输出,输出位置数始终由查询决定。若把所有位置当成同一种“注意力序列长度”,实现里很容易把掩码或归一化轴用错。
教法参考:Jay Alammar:The Illustrated Transformer;Lilian Weng:The Transformer Family。上面的尺寸与诊断为本文自构,论文机制以本篇原文公式和图表为准。
三、按原版残差顺序实现,并分开训练与生成
输入:源 token、移位后的真实目标 token
加入词嵌入与位置表示
编码器各层:
    对源序列做多头自注意力
    残差连接、归一化、逐位置前馈
解码器各层:
    用因果掩码做目标自注意力
    用目标查询读取源编码的键和值
    残差连接、归一化、逐位置前馈
计算每个目标位置的词分布与训练损失
推理时逐步生成目标前缀,并按解码协议搜索
上述是结构伪代码,原版归一化位置和残差顺序需依原图实现。把它无标注地换成现代 Pre-LN,会改变训练机制。训练使用 label smoothing 等配方时,损失也不完全等同于简单 one-hot 交叉熵。
构造目标句“猫坐在垫子上”。训练预测“垫子”时,如果注意力能直接读取当前位置真实“垫子”的输入表示,模型可以抄答案而不学习合法条件概率。右移目标输入与因果掩码共同防止这种泄露。
编码器看到完整源句并不违反因果条件,因为源句是已知输入;解码器看到未来目标词才是问题。这个区别也解释了为什么 BERT 可以双向读取被破坏的输入,而 GPT 的标准下一词训练需要前缀限制。
训练时所有真实前缀已知,可以一次计算多个位置的预测损失;推理时第一个新 token 未生成,就不知道第二个位置要读取的前缀。因此标准自回归生成仍逐步进行。缓存历史键值能减少重复计算,但不消除新 token 的依赖。
全注意力还需要位置对交互,长序列下内存和计算成为瓶颈。后来的稀疏注意力、FlashAttention、GQA 等分别改变计算结构、内存访问或缓存组织,不能把这些后续优势全部归给 2017 原版。
四、按结构图、翻译主结果和base消融逐层归因
完整执行条件固定后,图1解释信息流,表2给系统结果,表3才靠近组件归因。
| 项目 | 原文范围 |
|---|---|
| 主任务 | WMT 2014 英德和英法翻译 |
| 规模 | base 与 big 模型,不能将二者混作相同容量 |
| 预算 | big 英德结果对应 8 张 P100、约 3.5 天训练 |
| 解码 | beam 4、长度惩罚等开发集选择;检查点平均另行说明 |
| 指标 | BLEU、估算训练 FLOPs,以及架构变体实验 |
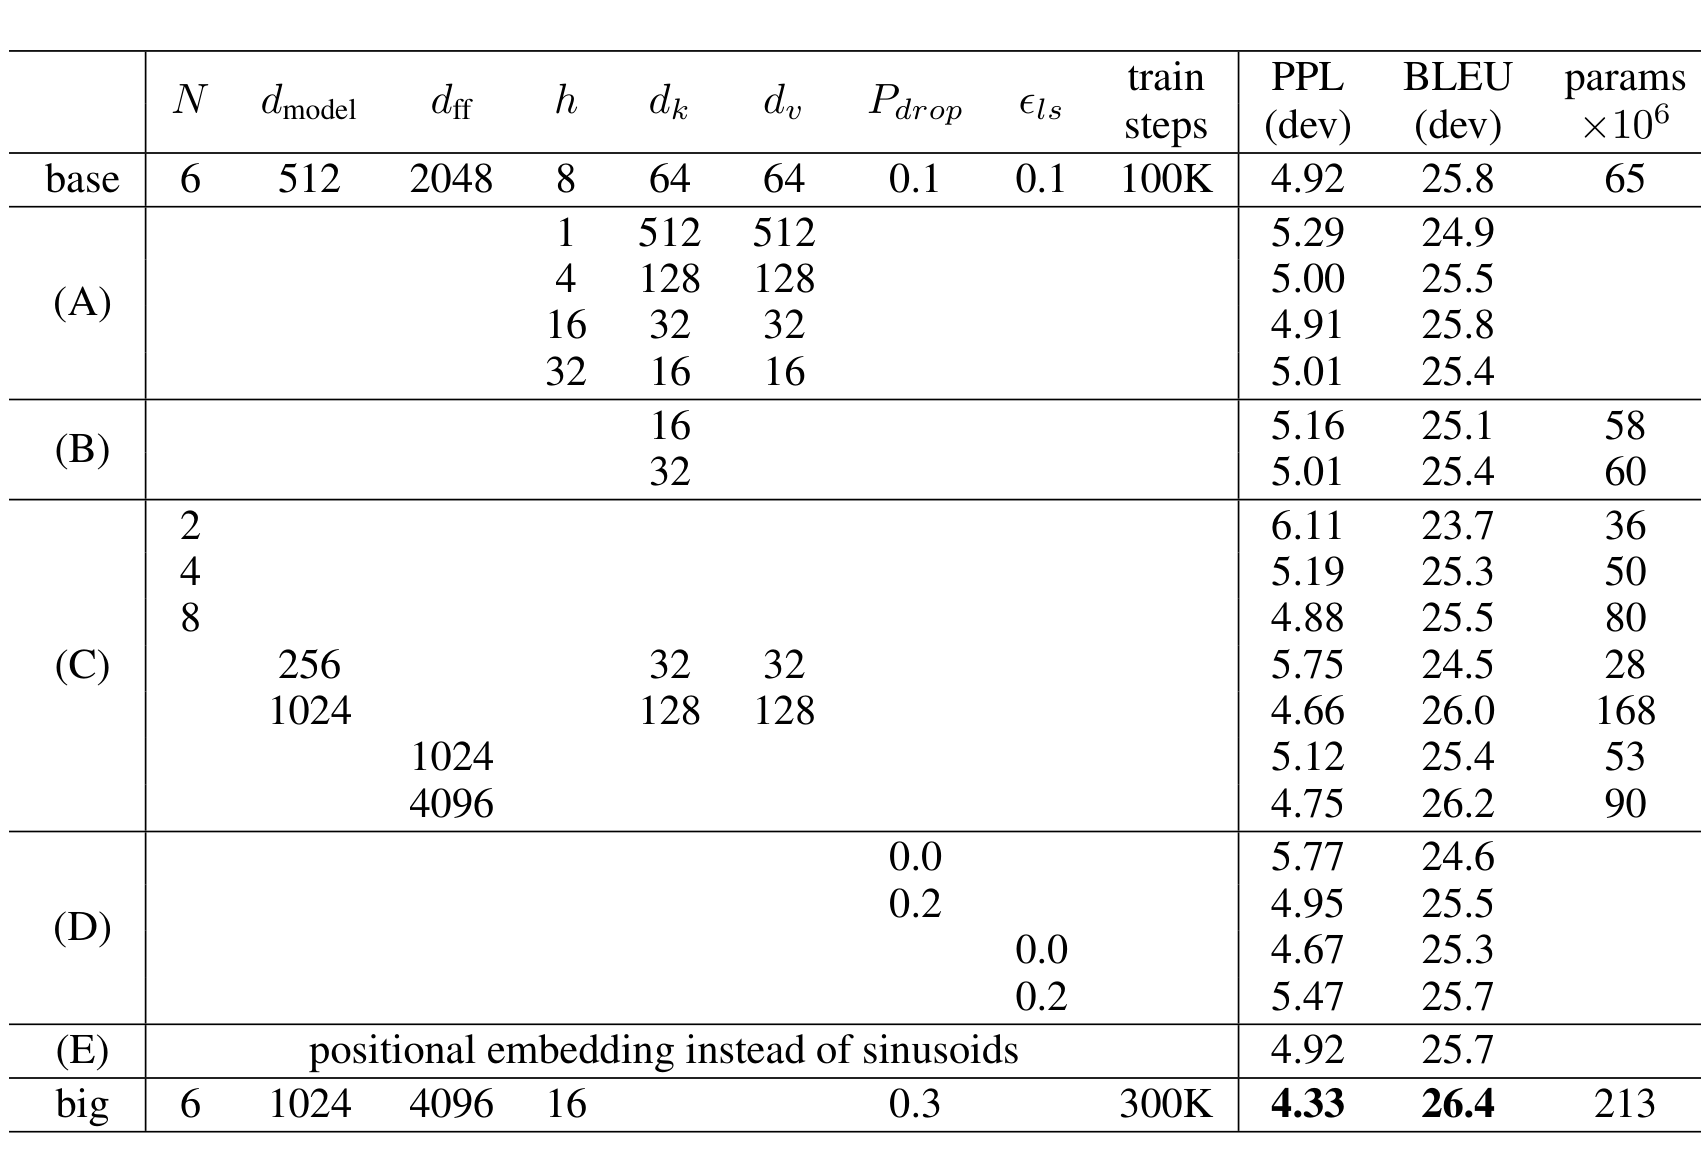
| 消融 | 头数、维度、dropout、位置表示等,原文表3 |
| 统计边界 | 检查点平均不是独立模型多种子置信区间 |
证据一,图1、第 3 节与表1。结构图、公式与计算比较展示了取消循环后的路径和成本。表1 的理论复杂度不能直接视为每种硬件上的速度排名。 左侧编码器生成可读取的表示,右侧解码器的交叉注意力再读取它;右侧最下层注意力带因果掩码。按这三种信息来源追箭头,比把所有方框统称为“注意力”更能看清架构。
证据二,表2。big 英德 BLEU 为 28.4,并列出其他系统和训练成本。跨论文对比包含数据与训练细节差异,支持系统级结果,不意味着每个组成模块都已被因果隔离。
证据三,表3。组件变化检验部分设计选择,说明性能依赖头数、规模与正则等组合。它提供比主结果更直接的机制证据,但并未覆盖所有配置组合和所有任务。
读表3先定位base行。 空白配置格沿用base设置,A—E各组再改变头数、键宽度、模型规模、正则或位置表示。PPL(dev)越低越好,BLEU(dev)越高越好,二者是不同指标;big行还增加了训练步数,所以不能把它对base的差值归给头数或宽度中的单个改动。
原文还讨论句法解析等任务,但不能据此直接推出后来的通用聊天能力。Transformer 提供了可扩展架构,数据、目标和训练规模的发展仍是后续论文的独立贡献。
五、短路径不保证有效读取,长度成本仍然存在
再构造长序列中两个距离很远但有关的词。自注意力让它们在一层内发生交互,但模型仍要学会正确权重。直接连接只是可能的信息路径,不保证实际使用,也不保证在干扰项很多时稳定找到目标。
限制包括长序列成本、位置外推、串行解码和注意力选择误差。它没有内置事实验证、工具使用或偏好对齐。
六、把本篇机制再推进一步
1. 只增加头数而保持每头宽度,会得到公平的多头消融吗?
参考答案:通常不会。这样同时扩大总隐藏宽度和相关投影预算,结果混入容量与计算变化。正文的维度检查要求联合说明总宽度、每头键值维度和头数;读表3也应先定位base共享配置,不能把所有变动都归给“更多头”。
七、分清精确注意力执行优化与键值头共享
同一骨干接下来分出GPT的因果预训练与BERT的双向恢复。两者继承注意力模块,却给出不同可见性;可沿本篇三种矩阵尺寸继续检查各自的掩码与部署接口。
自测与参考答案
1. 训练位置可以并行,为什么生成仍然逐 token?
训练真实前缀已知,多个条件预测可同时计算;生成时后续条件依赖刚采样出的 token。并行矩阵运算不能取消未知前缀的逻辑依赖,除非另用不同生成或验证机制。
2. 注意力权重高,是否表示该词具有最大的因果贡献?
不一定。值向量、其他头、残差和后续层共同决定结果,权重只是中间系数。需要结合干预与任务变化分析,不能仅凭热图做完整解释。
3. 只把 RNN 换成 attention,是否复现了原论文?
没有。原架构还包括位置、前馈、残差、归一化、掩码、优化与解码配方。复现需要明确这些组成,才能判断差异来自结构还是训练条件。