012|Layer Normalization:让归一化不再依赖同批其他样本
论文:Jimmy Lei Ba、Jamie Ryan Kiros、Geoffrey Hinton,Layer Normalization,2016。原文 · PDF。重点是统计维度、循环网络适用性及原文实验,不把后来的 Pre-LN、RMSNorm 等变体归入同一原始方法。
先接住前作的问题
Adam按梯度历史调整更新,但并不决定网络中间激活怎样归一化。对RNNLM一类变长顺序计算,跨样本统计又会把当前输出与batch构成耦合。本篇提供可组合的归一化模块,和优化器是不同层面的设计。
五个前置概念
五个前置概念是样本轴与特征轴、均值方差、可学习仿射变换、因果信息范围和训练推理一致性。理解这些即可判断一个代码实现到底是不是所讨论的方法,也能识别与其他归一化变体的区别。
一、问题设定:单个序列样本能否摆脱同批输入的统计影响
如果一个样本的输出依赖同批其他样本,改变batch构成就可能改变计算。BatchNorm在不少视觉模型有效,但小批量、在线与可变长序列不总适合这种耦合;循环网络各时间步的分布还会变化。本篇把统计范围转为当前样本内部的一组隐藏单元。
二、沿特征轴推导中心化、尺度和反传耦合
给定一个样本的隐藏激活 :
是被归一化的特征数, 为可训练增益和偏置, 防止数值问题。统计由当前样本计算,因此训练和推理不需要像典型 BatchNorm 那样切换到跨 batch 累积的运行均值。
归一化后的特征仍通过 适配任务。若没有这两个自由度,网络被迫在某些位置使用固定尺度;加入它们后,模型可以学习合适量级,同时保留归一化带来的参数化性质。它不是“归一化然后原样撤销”,因为统计量依赖当前输入。
对于循环网络,通常在每个时间步对该步内部激活应用归一化。它不会把未来时间步混入当前状态,因此可保持因果计算。若错误地沿整段时间轴计算统计,就可能在生成任务中泄露未来信息,这是张量维度选择造成的实际错误。
归一化为什么会耦合一个token的各个维度
令 ,其中 是同一个样本的特征向量, 为该向量的均值与标准差;暂忽略稳定常数 ,并假设 。均值和尺度都依赖全部特征,因此一维输入变化不只改变同一维输出。反传到输入的梯度为 ,其中 。它去掉整体平移方向及沿当前尺度方向的分量,说明LN改变的不仅是前向数值范围,也改变优化几何。此式是按原文归一化定义展开的教学推导。
教学算例。 向量 的均值2、标准差1,归一化为 ; 仍得到同一结果。这个正比例与共同平移不变性不适用于任意逐维缩放,也会受 影响。可学习gain/bias恢复逐维输出自由度,却无法从归一化结果唯一恢复被删掉的原始均值和尺度。
构造样本激活 。均值为 2,方差为 ,中心化后为 。忽略很小的 ,归一化值为 。把它与一个极大值样本放在同批,LayerNorm 的这一结果不变,因为统计没有使用另一个样本。
沿一个token的通道做平移检查
取同一token的两维激活(1,3),均值2、总体方差1;两维同时加10后,去均值结果仍为(−1,1)。在相同epsilon、增益和偏置下,归一化输出相同。若只把其中一维加10,均值和方差都会变,另一维输出也跟着变化;这正是梯度耦合,而非两个独立标量标准化。
教法联系:Jay Alammar的The Illustrated Transformer。算例为本文自构。
三、核对归一化轴、时间范围与仿射参数
输入:当前样本或当前时间步的隐藏激活 a
mu ← mean(a,沿约定隐藏维度)
variance ← mean((a-mu)^2,沿同一维度)
normalized ← (a-mu)/sqrt(variance+epsilon)
output ← gain*normalized + bias
将 output 送入后续非线性或网络模块
训练时联合更新 gain、bias 与原网络参数
推理时重复相同的单样本统计过程
优化目标仍是原任务损失;机制改变中间计算的参数化;指标是训练进度与任务表现。不能把损失变化自动归因于某个未经测量的“内部协变量偏移减少”,更稳妥的解释应围绕可观察的数值和优化行为。
Transformer 中常见 LayerNorm,但放在残差分支之前还是之后,会改变梯度路径。原始 LayerNorm 论文没有替所有后来网络选定最佳位置,不能因为名字相同就假定训练稳定性相同。RMSNorm 去掉均值中心化,也是另一个方法选择。
对于多模态或变长输入,还要说明哪些轴参与统计。归一化每个 token 的通道,与跨 token 归一化,是不同运算;前者通常不混合序列位置,后者可能改变位置间关系甚至因果性。读实现时最值得检查的往往就是这一行轴参数。
四、分开读结构不变性、Recall与训练速度
轴与插入位置固定后,分别检验训练表现和特定变换下的不变性,不把后者当作任意扰动鲁棒性。
| 项目 | 原文范围 |
|---|---|
| 模型 | 循环及其他网络,比较有无 LayerNorm 的对应设置 |
| 任务示例 | 图文检索、阅读理解或序列相关评价,具体配置分节说明 |
| 检索指标 | Recall@K 与平均名次,衡量正确候选是否进入前 K |
| 核心控制 | 尽量保持原任务模型并替换归一化方案,检查训练曲线 |
| 成本 | 每样本额外均值方差计算,实际时间仍由实现决定 |
| 重复 | 各任务报告形式不同,不合并为一个统一置信区间结论 |
证据一,第 3 节 Layer Normalization 定义。统计来自单训练样本的一组单元,而不是 batch;这是方法最关键的可验证区别。论文关于重参数化性质的讨论只在相应变换条件下成立。
证据二,图1 与表2 的图文检索。图展示 Recall@K 随训练变化;表中 OE 与 OE+LN 的 caption retrieval R@1 分别为 46.6 与 48.5。它支持该模型上的训练和任务收益,不证明所有任务都增加相同比例。 这里的曲线测的是图文检索 Recall@K;比较同一个 K 下有无 LayerNorm 的差异,不要把它解释成语言模型困惑度曲线。
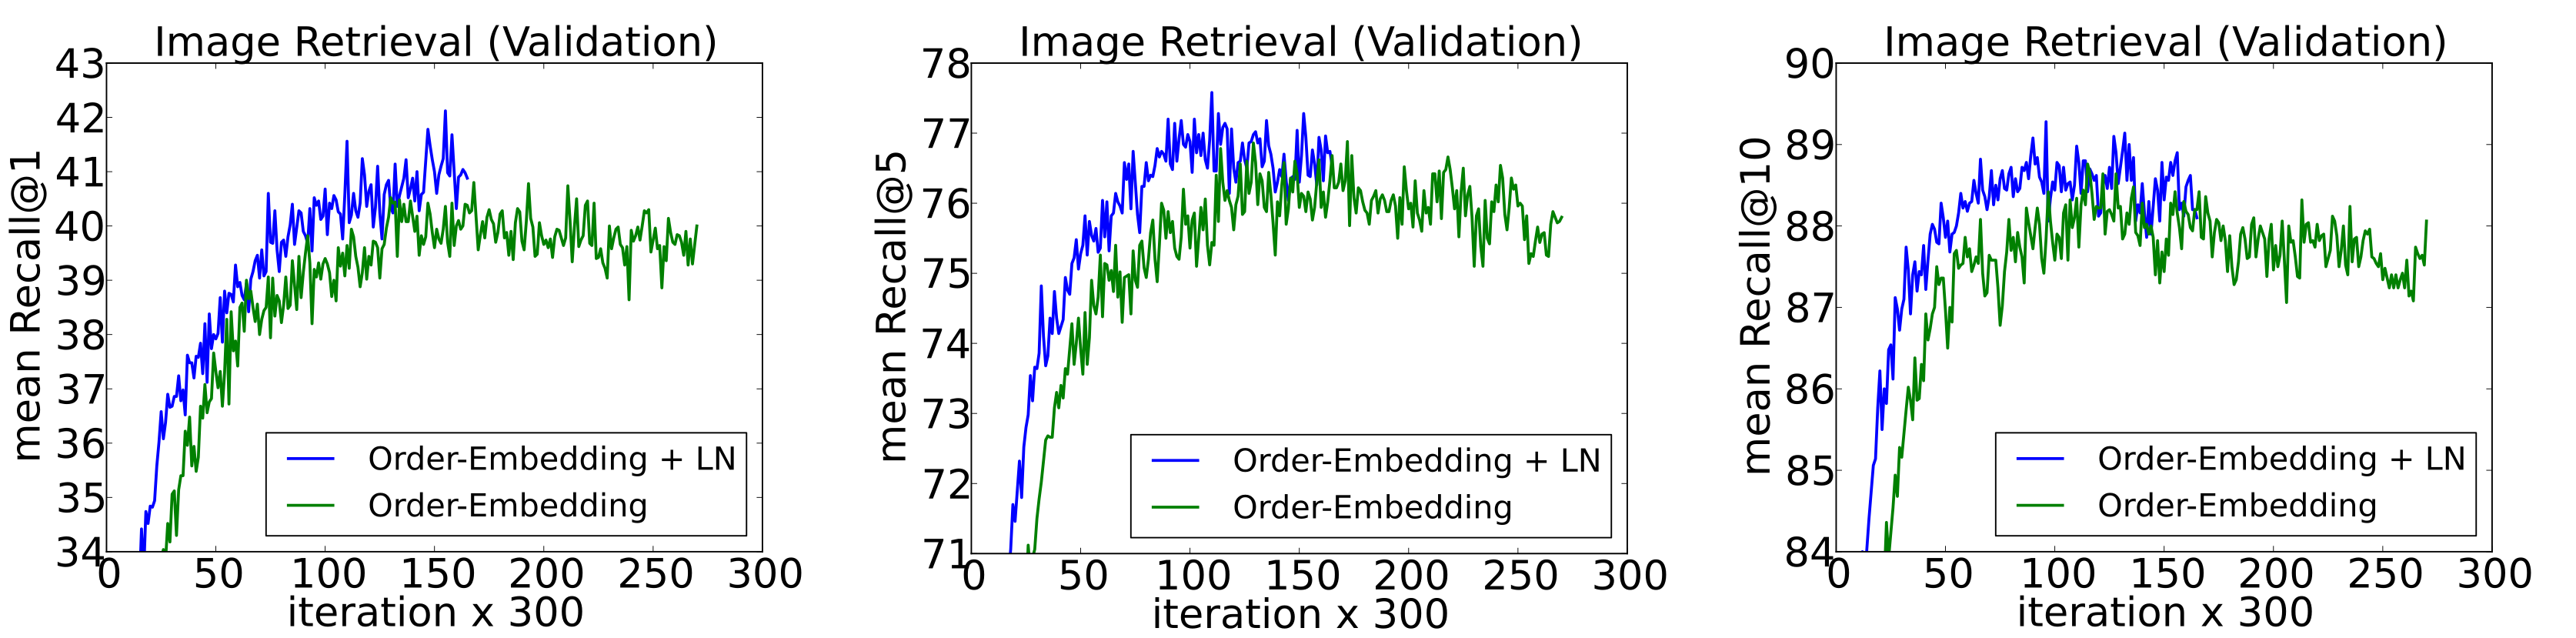
证据三,表1 的不变性比较。LayerNorm 对某些整体缩放或平移不变,却不对单个神经元权重的任意缩放都不变;其他归一化方案的性质也不同。这是特定变换下的结构分析,不能当作对任意数据扰动鲁棒的实验结论。
图文检索表也提醒读者:R@1 上升 1.9 个百分点不等于错误率相对降低 1.9%。指标单位要明确。曲线按迭代进展较快,与硬件墙钟更快也需要分开;原文对部分任务讨论时间,但不能把局部观察当作统一速度定律。
五、消去的均值和尺度可能也是任务信息
如果把本样本所有激活都加 100,中心化会消除这个共同偏移;若给不同坐标加不同值,则结果会改变。所谓不变性对应特定变换,不是模型对任意扰动鲁棒。可学习 和后续层也需要一起考虑。
再把隐藏维度降成 1。中心化后唯一坐标为零,输出主要由偏置决定,说明方法需要合适统计集合。这个极端教学例子揭示:归一化维度不是一个随便设的工程参数,而决定了哪些信息被消除。
代价包括额外计算、数值精度问题以及可能消除有用幅度信息。它不保证优化器、初始化和学习率从此无关。
六、把本篇机制再推进一步
1. 逐token特征归一化改为整句归一化,只是更稳定地估计均值吗?
参考答案:不是,它改变信息范围。当前token的结果可能开始依赖后续token,生成任务就可能泄露未来信息;同时不同位置被统计量耦合。必须按任务可见输入检查统计轴,不能用样本量更多为改变算法定义辩护。
七、把归一化放进残差网络,再比较RMSNorm
控制单个位置尺度后,深层残差的放置与整体训练仍需设计。Transformer展示模块组合,LLaMA采用另一种归一化配方;比较时应固定残差位置,而非把所有差异都归为归一化名称。
自测与参考答案
1. batch size 为 1 时,LayerNorm 为什么仍能计算?
它在样本内部的多个特征上估计统计,而不是依赖多个样本。只要被归一化维度合适,单样本就有统计集合;这与跨 batch 的典型归一化不同。
2. 不需要运行均值,是否就表示训练和推理完全一样?
LayerNorm 自身的统计计算方式一致,但网络其他部分可能有 dropout、采样或不同解码流程。所以只能说该归一化模块没有典型运行统计切换,不能概括整个系统。
3. 为什么沿时间轴归一化可能在语言生成中出错?
若统计使用未来 token,当前输出便间接获得未来信息,训练不再符合因果预测。应核对张量轴和掩码,确保只在允许的信息范围内计算。