013|fastText 子词表示:让稀有词共享拼写片段的统计
论文:Piotr Bojanowski 等,Enriching Word Vectors with Subword Information,2016 年预印本、TACL 2017。原文 · PDF。本篇讨论字符 n-gram 词向量;fastText 名称下的其他分类方法不等同于这篇论文。
先接住前作的问题
Skip-gram负采样已经让局部词对训练变便宜,却仍给每个整词独立参数:词形变化会分散数据,未登录词没有训练过的整词行。本篇直接改变其输入表示。BPE也是子词路线,但输出不重叠序列,与本篇重叠片段求和是平行方法。
五个前置概念
五个前置概念是字符 n-gram、参数共享、负采样、词表外组合和相关指标。理解这些即可进一步比较“切分后逐 token 编码”和“片段求和成词向量”两种不同的子词路线。
一、问题设定:罕见词与未登录词怎样借到其他词的训练信号
“walk”“walked”“walking”共享拼写,整词向量却要各自获得训练。稀有词出现过但更新少,词表外词没有完整词项参数;形态丰富的语言更会把同一词根的数据分散。这里要让不同词通过可复用字符片段交换统计信号,同时保留表达整体词义的空间。
二、由重叠字符片段推导跨词共享的梯度
设 是词 的字符片段集合,片段向量为 ,上下文词向量为 。词对得分写成:
模型沿用局部词预测和负采样思想,只是把中心词的表示改为片段求和。完整词本身也可以作为特殊项保留,使模型既共享子词信息,也有能力学习不能由拼写简单推断的整体含义。
词边界标记区分词首、词尾和内部片段。例如同样字符出现在词尾和中间,可能承担不同作用。实现还可用哈希桶限制片段参数规模,这节省存储但允许碰撞:不同片段可能共享一个桶,因此空间节约并非没有信息代价。
对未见完整词,只要能提取相关片段,就可以将其向量组合起来。若片段本身没有得到有效训练,或者词属于不同字母体系,所得向量仍可能质量很差。所谓 OOV 表示可计算,与 OOV 语义准确是不同承诺。
一个罕见词怎样借到常见词的更新
令 为词 的片段集合, 为片段 的向量, 为上下文词 的输出向量, 为该训练项的损失。训练分数为 ,因此对每个被访问片段有 。不同单词只要共享片段,就共同更新同一个向量;整词专属向量又容纳无法由拼写解释的部分。对未登录词,没有训练过的整词行,仍可组合已知片段。代价是字形相近未必语义相近,哈希碰撞还可能让无关片段意外共享参数。
教学算例。 只取三字符片段并带词边界,单词 cats 提供 <ca、cat、ats、ts>,cat 提供 <ca、cat、at>,两者共享前两项,却不共享带结尾的at>。设某公共片段向量更新 ,两个词的和表示都会发生这一变化;稀有词受益于共享,也可能被高频近形词拉偏。
构造两个词“unhelpful”和“helpful”。某些字符片段共享,使模型能利用共同上下文;但前缀改变意义,表示不应完全相同。完整词项和非共享片段可以表达差别,但若数据不足,模型可能过度靠近二者。
同一个子词被使用两次时怎样计梯度
若一个子词桶同时参与两个词的表示,两条样本的误差会累加到同一桶向量。假设回传分别为(0.2,−0.1)与(−0.3,0.4),本批合计为(−0.1,0.3),而不是保存两个独立副本。哈希碰撞也会产生这种共享,但共享的未必是同一真实片段,所以词形泛化与碰撞干扰必须分开理解。
教法联系:Jay Alammar的The Illustrated Word2vec。算例为本文自构。
三、同时保留边界、整词项与哈希桶约定
输入:词序列、字符 n-gram 长度范围、词边界规则
为每个词提取重叠字符片段,保留完整词特殊项
将片段映射到参数索引或哈希桶
遍历中心词及邻词训练对:
    representation ← sum(片段向量)
    抽取负上下文词
    用 representation 与上下文向量计算正负样本损失
    更新参与的片段参数与上下文参数
推理:对任意词按相同规则提取片段并组合向量
四、按词频、覆盖协议和语言读取相关指标
它没有直接优化词素分割准确率,也没有给每个片段一个人工语义定义。片段长度范围应作为超参数,而不是语言学真理。
覆盖提升与已见词质量改善是两种收益,先看sisg-与sisg,再读词频和语言差异。
| 项目 | 原文范围 |
|---|---|
| 语料 | 多语言标准化 Wikipedia 文本,按语言分别训练 |
| 基线 | CBOW、Skip-gram,与加入子词信息的表示 |
| OOV 协议 | 分别比较未见词用零向量与用片段组合,避免隐藏覆盖优势 |
| 指标 | 人工相似度与向量相似度的相关、词关系及语言建模实验 |
| 关键变量 | 字符片段、词频、语言形态、训练数据量 |
| 重复 | 统一覆盖所有语言的多种子区间未报告,不能把单表结果当作稳定性证明 |
证据一,方法部分的得分定义。真实改动发生在词表示由哪些参数构成。这说明不同词可以共享训练信息,但没有证明所有共享都正确。
证据二,表1。英文 Rare Words 相关分数从 Skip-gram 的 43 到子词方法的 47,而英文 WS353 中并非同样提升,表中子词为 71、CBOW 为 73。实验支持某些场景获益,也清楚提供了非普遍优势的例子。
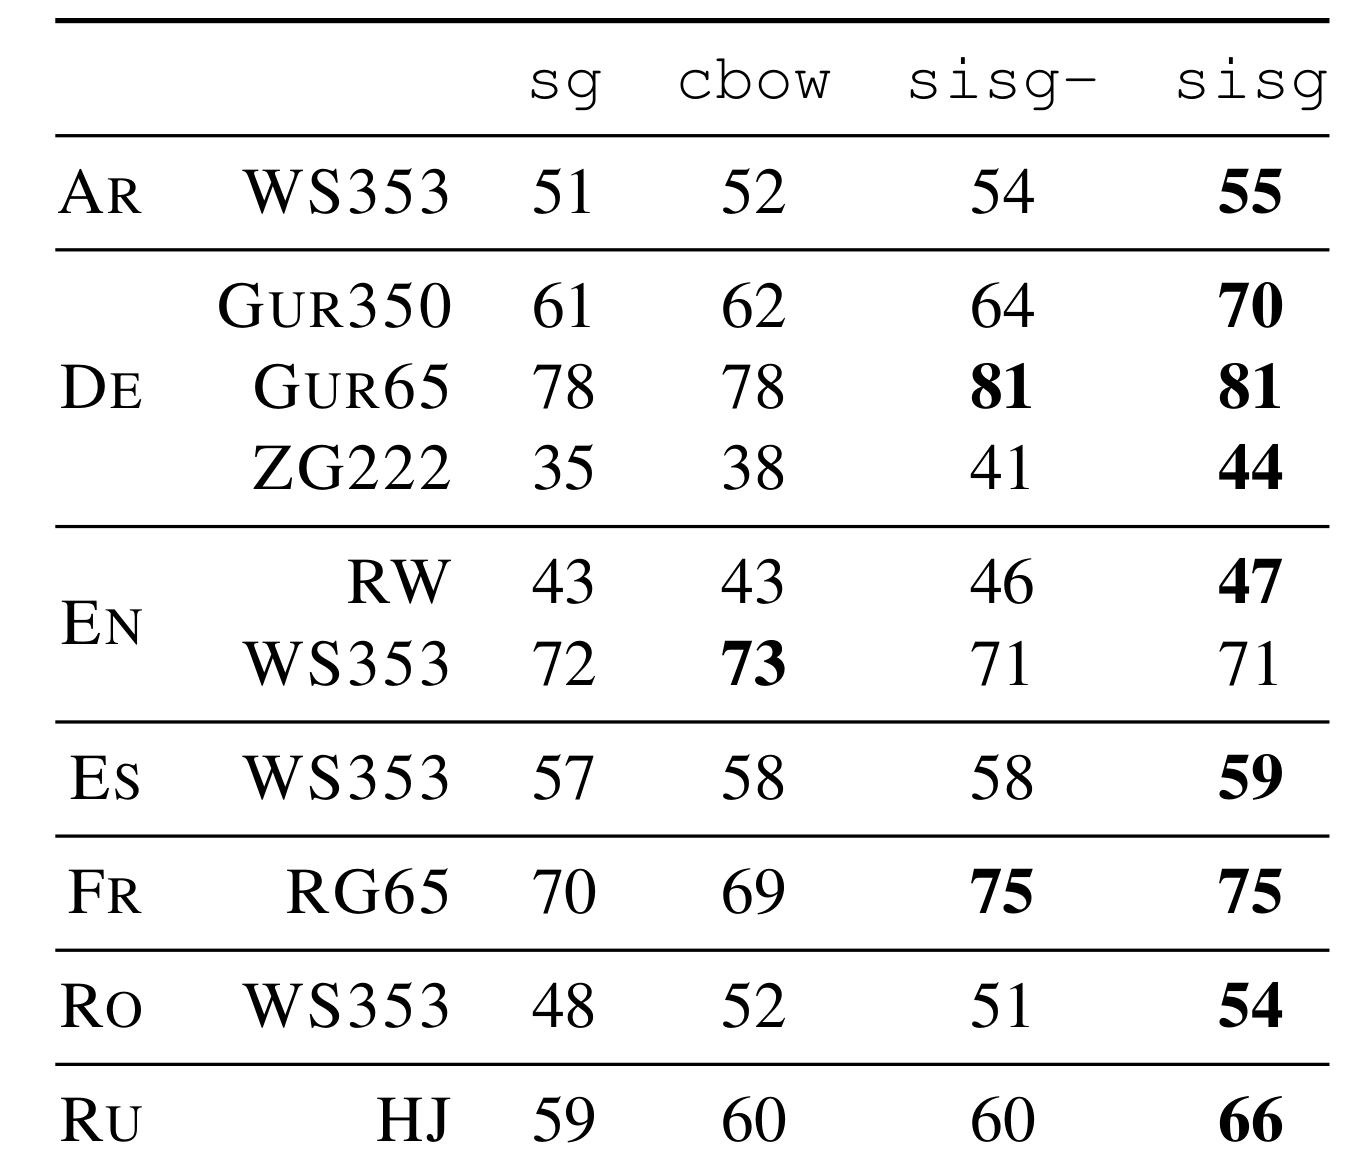
证据三,表1 的 sisg- 与 sisg 对照及随后分析。把 OOV 处理单独列出,有助于区分已见词表示改善与覆盖范围增加。论文关于阿拉伯语、德语、俄语的讨论把效果与形态结构联系起来,但因语言语料不同,这仍不是完全隔离语言形态的因果实验。
阅读词相似度表时还需注意,相关系数通常按百分数显示,不是分类准确率。一个分数从 43 到 47,表示相应秩或相关指标的变化,不能说“多答对 4% 的词”。评价单位必须保持清楚。
可以固定训练语料与负采样预算,比较完整词向量、完整词加片段、仅片段三组。按训练词频分桶,再单独测从训练词表删除的词。这样可以判断收益来自稀有词共享,还是额外参数和更多更新。
还应增加拼写相似但语义不近的对照,检验是否过度依赖字形。若只用形态规律特别明显的词,会高估整体效果。哈希桶大小也值得比较,因为碰撞会改变共享关系,而不仅是内存占用。
以上是教学实验建议,不是原文额外报告结果。它们体现一个通用原则:当方法改变参数共享结构时,实验应测试共享在哪些样本之间发生,以及错误共享是否带来代价。
五、有益字形共享也会造成错误语义迁移
这说明子词方法对反义、否定和细微拼写差异仍有风险。只要共享机制存在,就同时存在有益迁移与负迁移。不能把“字符信息”当成语义总是保真的编码。
再构造新词“hyperhelpful”。模型可以提取部分已见片段并形成向量,但其真实用法是否与片段组合一致,要靠新上下文验证。这个例子展示计算覆盖,不是模型已经掌握新造词含义的证据。
局限是静态词义、形态假设、片段覆盖和哈希碰撞。它不等同于完整字符语言模型,也不会因能处理 OOV 就自动解决跨语言理解。
六、把本篇机制再推进一步
1. 固定负采样数而增加片段长度范围,是否只增加表示容量?
参考答案:还会改变每个训练项访问的片段数,以及哪些词共享梯度。更多片段可能增加参数、更新工作量和错误共享;哈希桶固定时还可能改变碰撞。应分别记录这些条件,再按词频与近形异义词分组比较,不能只把分数变化归为容量。
七、比较两种子词接口,不把静态表示当成上下文化
能为新拼写算出向量,不等于能区分同一拼写的语境。ELMo进一步处理上下文化;与BPE对照时,则要区分“把文本切成序列”与“将片段求和为一个词向量”。
自测与参考答案
1. fastText 子词与 BPE 为什么不是同一个操作?
BPE 产生按顺序排列的分割单位,本文为同一词提取可重叠片段并组合成一个表示。两者共享子词思想,但训练对、序列长度和参数共享方式不同。
2. 未见词能生成非零向量,是否就有可靠语义?
不一定。向量依赖片段是否被有效训练,以及新词含义是否可由字形组合推断。随机专名或语义不透明词可以被计算,却仍可能表示错误。
3. 为什么需要同时报告 sisg- 与 sisg?
二者区分 OOV 处理的收益。若只比较能表示新词的方法与给新词零向量的基线,提升部分来自覆盖而非已见词几何改善。拆开报告使贡献更明确。