014|稀疏 MoE:让模型拥有更多参数,却只为当前输入激活一部分
论文:Noam Shazeer 等,Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer,2017。原文 · PDF。本文讨论稀疏门控专家层,不把后来的 Switch 单专家路由、现代推理系统或所有 MoE 配方归为原版细节。
先接住前作的问题
NNLM和循环语言模型的稠密计算使容量增长通常伴随每次预测成本增长。word2vec选择简化代理任务,本篇则保留序列任务,探索输入相关的条件计算;两者是应对预算瓶颈的平行取舍,不是相邻架构的直接替换。
五个前置概念
理解本篇的五个概念是条件计算、top- 路由、专家容量、辅助平衡损失和通信成本。它们分别回答哪些参数被运行、怎样选择、总知识容量如何增长、训练如何避免偏斜以及稀疏为何未必更快。
一、问题设定:扩大总参数时,能否只执行少数专家
稠密网络对每个输入几乎执行全部参数,扩大容量通常同步扩大计算。语言输入可能需要不同规则,于是本篇给模型许多专家、每次只选少数;但若路由本身昂贵、负载拥堵或通信过多,节省的纸面FLOPs未必转为实际加速。
专家不是预先标注的“数学专家”“文学专家”。它们是具有相同或相近结构的参数模块,分工由训练形成。即使观察到某些输入聚类,也不能自动赋予稳定人类语义标签。路由器只接受模型目标和辅助约束的反馈。
原论文把专家层嵌入相应序列模型,周围仍有稠密计算。不能把整套系统的每步成本简化为一个专家层,也不能仅拿非嵌入参数量与另一个全模型参数量直接比较。
二、从稀疏权重区分单token计算与跨token均衡
基本形式为:
为第 个专家, 为门控权重。门控对输入产生分数,加入可学习尺度的噪声,再保留 top- 项并归一化。未选专家权重为零,因此可以跳过其前向计算。稀疏是计算路径属性,不只是参数中零元素较多。
训练的主损失仍是语言建模或翻译损失,此外加入关于专家重要性和负载的平衡项。一个专家权重总和很高,与收到很多样本不是完全同一量,因此论文区分相关平衡信号。仅惩罚一种平均分配,未必消除实际计算拥塞。
噪声鼓励探索不同专家,减轻早期赢家持续吸收所有样本的反馈。但噪声也引入随机性,训练与评估门控可能不同。top- 的离散边界使路由变化不完全平滑,不能简单把它当成无约束稠密加权层。
稀疏和均衡不是同一个条件
Top-k将未选分数置为负无穷,再softmax,计算才真正不必访问那些专家。若只把未选分数置零,它们仍有 的正权重。选中区域内,路由器可沿权重反传;未被选中的边界变化不是普通光滑导数。原文因此加入可学习噪声,并另设重要性/负载相关约束,避免少数专家一直被选中而其余缺乏学习机会。稀疏限制每token工作量,均衡限制跨token的工作分配。
教学算例。 四个专家分数为 ,top-2后权重约 。若一个batch的100个token全都选相同两位,平均每token仍仅算两位,但另外两位没有任务梯度,承载热门专家的设备也可能成为瓶颈。这个四专家、top-2的例子激活了50%的专家,仍不能直接换算成2倍墙钟加速。
构造四个专家,初始化时第一位碰巧稍好。路由把更多输入送给它,它得到更多训练,再变得更好,形成正反馈。其他专家数据不足,参数容量虽然存在却没有被有效利用。辅助平衡目标试图打断这一过程。
用路由矩阵区分稀疏度和拥堵
给4个token各选2个专家,共有8次分支调用;若全部选专家1和2,四个专家中的后两位完全空闲。另一个路由同样有8次调用却均匀分成每专家2次。两者稀疏计算总数相同,最忙设备的工作量相差一倍;同步完成时间因此不能只由Top-k决定。
教法联系:Lilian Weng的How to Train Really Large Models on Many GPUs?。算例为本文自构。
三、先路由再分发,记录专家负载和通信
输入:一批隐藏表示 x、专家集合、稀疏选择数 k
为各输入计算路由分数,训练时按协议加入噪声
保留 top-k 专家并对保留分数归一化
按专家将输入分组并发送到对应设备
各专家仅处理分配给自己的输入
将结果按门控权重组合回原输入顺序
loss ← 任务损失 + 重要性平衡项 + 负载平衡项
联合更新被访问专家及路由相关参数
输出:专家层结果和用于监测的负载统计
再把专家放在不同设备。一次 token 只算两个专家,FLOPs 不多,却要传输输入输出;batch 很小时通信占比可能很高。这解释了为什么大 batch、专家放置和互联对实际收益至关重要。
四、用相同计算预算读容量、困惑度与设备效率
平衡负载是训练与系统条件,不是语言质量本身;均匀路由也不代表专家已经学到有用分工。
把计算和通信分开后,再看相近激活预算下增加总容量的收益。
| 项目 | 原文范围 |
|---|---|
| 任务 | 大规模语言建模与机器翻译相关实验 |
| 容量变化 | 专家数量和结构,以及低、中、高计算预算模型 |
| 指标 | 测试困惑度、训练时间、每步运算与设备效率 |
| 资源 | 表1 使用 K40 GPU 配置,参数统计明确排除部分层 |
| 平衡 | 检查专家重要性与负载,避免少量专家吸收大部分输入 |
| 重复 | 不能从配置表推断未报告的多种子可靠性 |
证据一,第 2—4 节的门控与系统设计。说明稀疏选择如何落地,以及为何通信、batch 分组和负载必须一起考虑。它支持可计算方案,而不仅是理论上少用参数。
证据二,表1。在列出的 10 epoch 条件下,低预算 MoE 测试困惑度 34.1,而所列既有最好结果为 34.7;表内非嵌入等排除条件后的参数为数十亿,运算却低得多。这说明容量与激活计算可分离,但不能把该表的参数口径套到现代全模型统计。
证据三,图2 与附录 C。不同预算与容量的曲线、具体模型配置共同支撑取舍。只截取最大参数模型或最快模型,会丢掉质量、时间和硬件利用率之间的变化。 左右子图回答不同问题:左侧在相近每步计算预算下改变容量,右侧改变计算预算。只沿容量横轴比较,不能推出所有部署费用都不变。
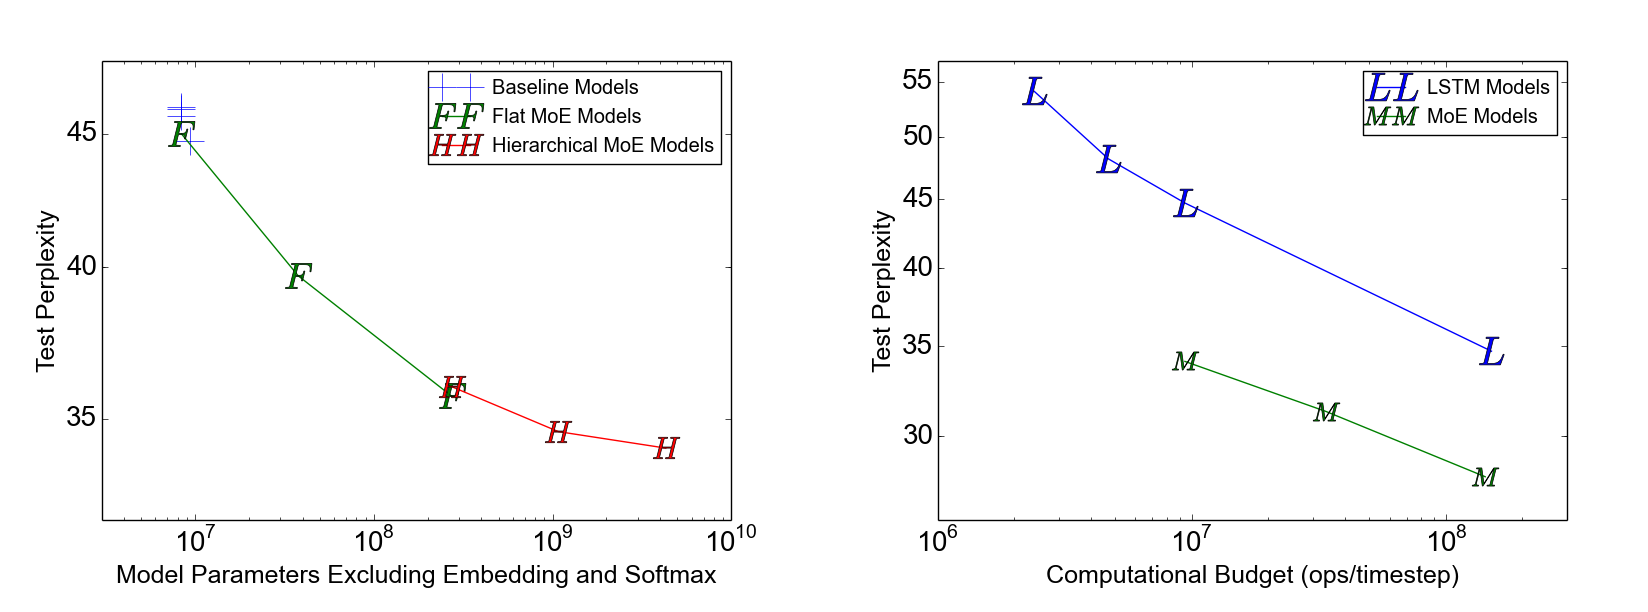
表中跨模型训练使用不同设备数量和时间,真实成本不能只看“小时”。更全面的比较需要 GPU 小时、通信、内存与质量阈值。原文也报告 TFLOPS/GPU,说明作者并未将理论稀疏直接等同于硬件效率。
五、闲置专家与数据分配会耗掉名义容量
但若强迫每个 batch 完全均匀,也可能把本该由同一模块处理的相似输入拆散。负载均衡与任务最优路由之间需要取舍,因此辅助项权重不是纯系统参数。可以同时绘制质量与专家分配熵,观察均匀化是否真正带来有用容量。
还有一个容易漏掉的维度是每个专家的有效样本量。增加专家总数、保持训练 token 总量和每 token 激活数不变时,每个专家平均看到的样本可能变少。容量更大与单参数训练更充分之间因此存在张力。可以固定总激活计算,逐步增加专家数,同时记录路由覆盖、各专家更新次数和验证损失;若质量停止改善,不能只解释为硬件问题,也可能是分配到各参数的数据不足。这一实验是本文提出的检查方式,不是原文补充结果。
本文证明稀疏条件计算可以在大规模神经序列任务中落地,提供了一条扩展总容量的路径。它不意味着拥有相同激活参数量的稀疏模型与稠密模型成本完全相等,也不意味着专家天然可解释。
限制包括路由不稳定、负载不均、跨设备通信、总权重存储和较小 batch 效率。推理服务还可能面对动态请求和专家访问偏斜,这些实际条件不能仅凭训练实验推断已经解决。
六、把本篇机制再推进一步
1. 总token与每token激活数都固定,专家翻倍后为何可能学不充分?
参考答案:平均分配到每个专家的训练样本可能减少,路由偏斜还会使部分专家更缺更新。应检查各专家的访问和更新次数,而不只检查总参数。固定激活计算下的质量变化同时涉及容量与数据分配,不能预设专家越多一定越好。
七、沿分布式扩展、简化路由与解码器组合继续读
稀疏路由的负载与通信问题在GShard进入大规模分片设计,Switch再尝试Top-1。沿这条后继线,应同时记录激活数、容量溢出和设备负载,而非只比较总参数。
自测与参考答案
1. 总参数增加十倍,为什么每个 token 的运算可以只增加少量?
路由只激活少数专家,未选专家不执行前向。总容量与本次路径分离。但所有权重仍需存储或调度,路由和通信也有成本,不能据此说资源几乎不变。
2. 负载均匀是否说明专家分工优秀?
不说明。均匀只描述输入分配,随机平均路由也可能均匀。要判断有用分工,需要任务质量、路由消融以及对输入变化的分析,而不是单一负载指标。
3. 为什么小 batch 可能削弱 MoE 的速度优势?
每个专家收到的样本更少,矩阵运算利用率下降,跨设备通信和调度占比增加。实际速度取决于数据分组与硬件,纸面激活 FLOPs 不能直接预测延迟。