004|word2vec:把昂贵语言模型拆成便宜的表示学习任务
论文:Tomas Mikolov 等,Efficient Estimation of Word Representations in Vector Space,2013。原文 · PDF。本篇聚焦 CBOW 与 Skip-gram;负采样和短语处理在下一篇单独讨论,不把两篇贡献混在一起。
先接住前作的问题
NNLM与RNNLM把表示放进完整条件词预测,但隐藏计算和输出层限制了训练规模。如果最终交付的是可复用词向量,是否还必须承担完整语言模型的代价?本篇从这一计算问题分叉,改变任务目标;它不是把 RNNLM 的循环记忆直接加速。
五个前置概念
理解本篇需要区分上下文窗口、输入与输出嵌入、代理任务、余弦相似度和类比检索。它们分别回答数据怎样构成、参数怎样分工、训练为什么设计、距离怎样衡量以及评价如何运行。
一、问题设定:只需要词向量时,哪些语言模型计算可以省去
如果最终要把词向量交给其他任务,训练完整神经语言模型是否必要?NNLM 的输出层和复杂隐藏映射消耗大量计算,本篇改用邻词与中心词的局部预测,把省下的预算用于更多文本;需要检验的是这种便宜代理任务保留了哪些有用关系。
CBOW 与 Skip-gram 的“上下文”可以同时包含左右邻词,因此它们并非严格因果的下一词预测器。左右信息在表示学习阶段是允许的,但若把它们直接当作在线生成概率,就可能使用未来信息。区分预训练代理任务与部署任务,是理解这篇论文的第一步。
二、从 CBOW 聚合与 Skip-gram 配对推导共享信号
设中心词为 ,窗口半径为 。Skip-gram 的目标可以写成:
每个训练对只用中心词向量预测一个邻词,因此一段文本贡献多个局部关系。CBOW 则先聚合邻词向量,再预测中心词:
为输入词向量, 是上下文位置集合。平均是一种教学表示,具体实现的求和、归一化与窗口采样应以原实现为准。聚合通常忽略邻词内部精确顺序,这正是“词袋”的含义。
如果输出使用普通 softmax,需要对整个词表归一化。论文讨论分层 softmax 等效率方案;下一篇的负采样不应回填成这里唯一的训练方式。输入向量与输出向量也属于不同参数角色,最后选哪组或怎样组合,是表示使用协议的一部分。
为什么去掉隐藏层能改变训练规模
令上下文平均向量 ,其中 是窗口内输入词数, 是输入嵌入, 是候选输出词的嵌入, 是本次预测交叉熵;CBOW 直接用 打分。交叉熵的梯度先到 ,再平均分给 个输入词:。同一窗口中的词共享这次预测信号,速度快但丢失窗口内词序。Skip-gram 则分别产生中心词到各邻词的预测项,稀有中心词也会提供多次输出约束。原文 §2—3 的计算比较关键在删掉昂贵的非线性隐藏层,并配合分层 softmax;负采样属于下一篇。
构造一个小语料,“咖啡”“茶”经常与“喝”“杯”“热”一起出现。为了预测相似邻词,两者的表示可能接近。若“冰”也经常出现在这些上下文里,它未必是饮料,却可能共享部分方向。这说明分布相似是由使用环境定义,不等于严格的类别同一。
从四个词直接列出两种监督样本
自构片段“猫 坐 在 垫上”,中心位置取“坐”、窗口半径取1。CBOW的一条输入由“猫、在”合成,目标为“坐”;Skip-gram则产生“坐→猫”和“坐→在”两条预测。扩大窗口首先改变训练对及其距离分布,随后才影响梯度;不能只把窗口看作网络张量的尺寸参数。
教法联系:Jay Alammar的The Illustrated Word2vec。算例为本文自构。
三、先固定窗口采样,再选择输出层和导出向量
输入:分词语料、窗口范围、词表、向量维度
初始化输入词向量和输出参数
遍历中心位置 t:
    采样允许的上下文窗口
    若使用 CBOW:
        聚合邻词向量,预测中心词
    若使用 Skip-gram:
        对每个邻词,以中心词向量预测该邻词
    通过选定输出层计算损失并更新涉及的参数
导出词向量
在独立词关系、相似度或下游任务中评价
窗口不是均匀采样的同义词。 自构长度上限 ,若每次均匀抽取实际半径 ,距离 的词被纳入的概率为 。距离1总被纳入,距离5仅有20%机会。即使窗口内的单次损失不显式乘距离权重,重复采样后的目标已偏向近邻。讨论“用多大窗口”应同时交代这个隐含加权。
四、同时读类比类别、CPU预算与句子补全
训练没有直接给出“国王减男人加女人等于女王”这类标签;某些几何规律来自分布统计,但不能因此假定所有语义关系都线性可解。
省去隐藏层是否值得,要同时看表示质量与训练成本;下游补全还能检验被省掉的信息是否重要。
评估对象要与目标对应。 §4.1 的类比测试只收录单 token 词,以最近邻是否等于指定答案判对,且排除题目给出的词;同义答案仍会判错。因此该实验直接支持特定线性关系检索,并不单独证明句子理解或开放式推理。
| 项目 | 论文中的比较重点 |
|---|---|
| 语料 | 多种规模配置,包括 Google News;不能把所有表看成等语料 |
| 表示 | NNLM、RNNLM、CBOW、Skip-gram 等,维度和训练量会变化 |
| 关系评价 | 语义与句法类比,使用向量运算检索候选词 |
| 任务评价 | Microsoft 句子补全挑战,包含与其他模型组合 |
| 效率 | 报告训练时间与资源配置;分布式开销影响实际成本 |
| 重复报告 | 表格为具体配置结果,统一多种子置信区间未报告 |
证据一,架构部分。CBOW 和 Skip-gram 的计算路径说明减少隐藏计算的原因。复杂度分析支持训练可以更便宜,但真实墙钟速度仍取决于词表、输出方法和硬件。
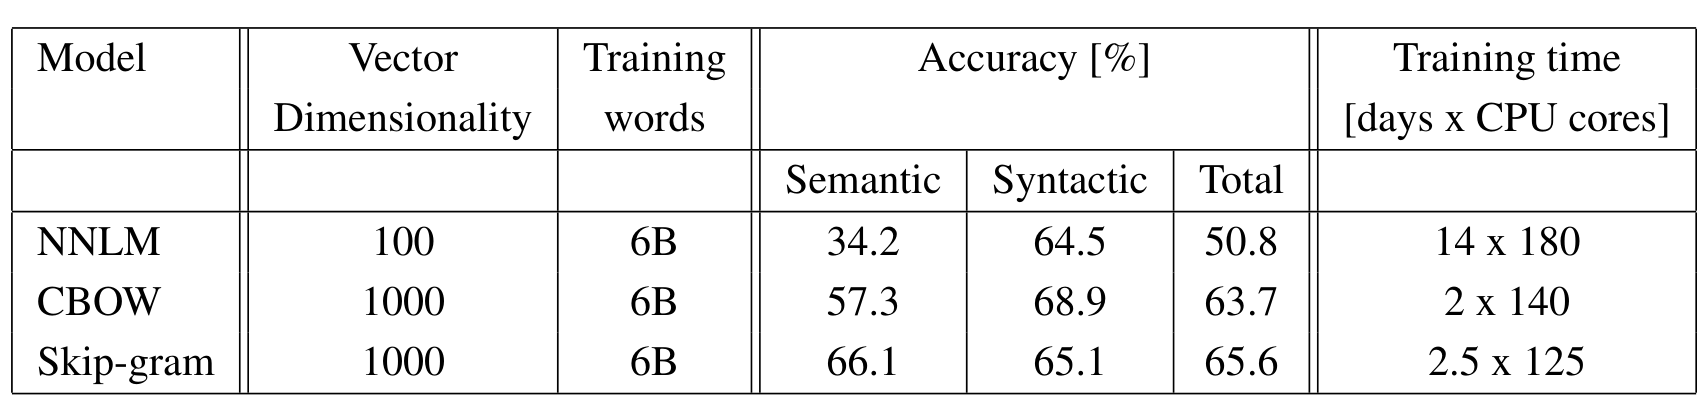
证据二,表6。大规模配置把表示质量与训练时间放在一起,展示规模和架构之间的取舍。不同模型维度不完全相同,因此不能把这一表当作“只替换一个模块”的纯消融。
读表6。 中间三列分别是语义类比、语法类比和总准确率,越高越好;最右列是“天数 × CPU核心数”,不能把乘号前的天数独自当作总计算成本。CBOW与Skip-gram在两类题上的排序不同,总分也不能替代逐类表现。
证据三,表7。句子补全中 Skip-gram 单独为 48.0%,RNNLM 为 55.4%,组合为 58.9%。这说明表示信息可以与序列模型互补,同时直接反驳“词向量在任何语言任务上都胜过语言模型”的泛化说法。
表8 的关系例子很直观,但例子是展示,不是完整统计。若只挑成功的近邻,几乎任何高维表示都可能显得有语义。因此应同时查看完整测试集准确率、未登录词处理及候选排除规则。
五、便宜代理任务主动舍弃了哪些上下文信息
再把“银行”同时用于金融机构与河岸,单一向量需要兼顾两种上下文。模型可能形成折中位置,导致相似词列表混杂。增加数据有助于稳定估计,却不会自动消除单向量表示的结构限制。
可以做一个小实验:固定语料,打乱每个局部窗口内的词序。CBOW 的聚合几乎不变,但严格序列语言模型的目标会变化。这个实验揭示 CBOW 主动丢弃什么信息,也说明简化带来的效率来自真实的信息取舍。
word2vec 使大规模词表示学习成为更易使用的基础工具。最值得借鉴的研究思想是:围绕最终需要的表示,重新设计足够便宜而仍有信息的训练任务,而不是一味扩大原有复杂模型。
代价包括静态多义词混合、局部窗口信息损失、罕见词估计困难以及对语料偏差的继承。词类比可能受到词频和候选空间影响;向量相近也不提供事实真实性保证。本文的分析是,后续大模型仍沿用“从预测中学习表示”的原则,但通过上下文化、数据规模和交互深度改变表示能力。
六、把本篇机制再推进一步
1. 窗口半径上限相同,就能把两个词向量训练视作等数据吗?
参考答案:不能。固定半径与随机半径产生不同的词对频率,正文的例子中距离5只有20%的纳入机会,而距离1总被纳入。应比较实际训练对及距离分布,再控制输出层和更新次数;否则看似架构差异可能包含样本权重差异。
七、继续降低输出成本,或改变统计与表示对象
输出词表仍可能昂贵,下一篇负采样把计算转成数据与噪声判别。再用GloVe作平行比较,追问局部预测与全局共现怎样分别约束向量。
自测与参考答案
1. CBOW 为什么速度可能更快,却会丢失信息?
邻词被简单聚合,省去复杂的逐位置非线性交互,但精确顺序可能消失。不同词序若含相同词集合,可能得到相同输入表示。速度收益与表示限制来自同一个设计选择。
2. Skip-gram 类比准确率高,为什么不保证句子补全最好?
类比测试偏重词向量几何,句子补全还需要顺序、句法与更完整的上下文建模。代理任务和下游任务存在差异,原文表7 也显示单独 Skip-gram 不及所列 RNNLM,而组合能获得互补收益。
3. 为什么不能只展示十个漂亮近邻就证明词向量质量?
手工选择容易隐藏失败,近邻还受词频、词表和多义词影响。需要完整测试集、明确检索规则以及至少一种下游评价。展示帮助理解,统计比较才支撑总体结论。