008|GloVe:让词向量解释全局共现统计
论文:Jeffrey Pennington、Richard Socher、Christopher Manning,GloVe: Global Vectors for Word Representation,EMNLP 2014。论文页面 · PDF。本文讨论加权共现拟合、词关系实验与命名实体识别,不把静态词向量等同于上下文化语言模型。
先接住前作的问题
负采样通过真实搭配与噪声的对比学习局部点积,但尚未给出一个显式拟合全局计数的目标。本篇换到平行统计路线:用共现概率比解释词关系,并对对数计数加权拟合。这个教学连接不能把 GloVe 的偏置和权重函数说成负采样的同一损失。
五个前置概念
五个前置概念是共现矩阵、条件概率比、低秩表示、加权最小二乘和秩相关。它们分别解释统计来源、设计动机、压缩形式、优化目标与评价尺度。将这五层拆开,就不容易把“全局向量”误认为一个没有边界的语义模型。
一、问题设定:怎样让向量反映词之间的相对共现关系
“冰”和“蒸汽”都与水相关,“固体”对二者的关联差异却更有区分度。共现矩阵 记录词 出现在词 上下文中的次数,但常见词的巨大计数与罕见搭配的不稳定性会影响直接低秩分解;问题是怎样利用相对关系,又控制频率尺度。
GloVe 的动机强调条件共现概率的比值。一个上下文词如果与两个候选词同样相关,就不太能区分它们;若明显偏向其中一个,则可能承载关系信息。这不是先定义人类语义类别,而是从分布差异寻找可编码结构。
局部预测方法和全局计数方法并不是互不相关的两派:二者都利用共现规律,只是目标、抽样和权重不同。GloVe 的问题是怎样把全局信息放进一个直接可优化的目标,而不是证明所有局部预测都丢掉了全局统计。
二、从概率比推到带偏置的对数共现拟合
核心损失为:
与 分别是词和上下文向量,偏置吸收部分频率效应; 控制不同计数项的相对影响。对数压缩极大计数的尺度,权重函数使极少见项不过分主导,同时避免频繁项无限加权。仅对正共现项求和,也避开 。
这个目标没有对每个中心词计算全词表 softmax。它直接让内积加偏置接近某个统计量,因此训练损失不是下一词交叉熵,不能直接拿来与语言模型困惑度比较。想要生成语言,还需要定义序列条件概率模型。
两组向量有对称但不同的角色。论文使用词与上下文表示的组合来获得最终向量;不同组合会改变下游结果,应把它写入评价协议。向量维度、窗口大小、语料来源与训练次数也都是实质条件,不是可以忽略的实现尾注。
从概率比走到内积差
设 ,其中 是目标词 与上下文词 的共现次数,; 是两个目标词向量, 是上下文向量, 是待选的标量映射。以下对数推导只讨论正计数项。要求关系由向量差表达,即 ;选择把加法映为乘法的指数函数后,取对数得到 。再把与上下文 无关的词频项交给偏置,形成对 的近似拟合。这里是模型设计约束导出的动机,并非任意真实共现矩阵都存在精确低维解。
教学算例。 若上下文“固态”在两个目标词周围的概率为0.08和0.01,比值8对应对数差 ;共同相关词若概率为0.20和0.20,对数差为0。相比单看“共同相关词出现很多”,比值指出哪个上下文真正区分目标词。若某项计数为零,不能直接把 代入数值程序;原目标以零权重排除未观察项,而不是声称未出现就绝无关系。
构造词“水”与大量上下文共现,而稀有化学术语只出现几次。若没有频率偏置,模型可能把“很常见”硬塞进向量方向,妨碍表示关系。偏置提供吸收总体频率的通道,让内积更专注于词对之间的结构,但不能保证完全剥离频率。
用共同平移检验偏置吸收了什么
对固定中心词,将它与所有上下文的非零共现数都乘2,会给各个对数目标共同加上log 2。若权重函数暂不变,这个共同偏移可由中心词偏置吸收,未必需要改变所有向量方向;真实目标还会因计数权重变化而改变。这个分步检查把共现比例信号与高频样本权重区分开。
三、先建非零共现矩阵,再优化并组合两组向量
输入:文本、上下文窗口、向量维度
统计非零共现对 X[i,j]
初始化词向量 w、上下文向量 u 与各自偏置
重复抽取非零共现项:
    residual ← dot(w[i],u[j]) + b[i] + c[j] - log(X[i,j])
    loss ← weight(X[i,j]) * residual^2
    更新该项涉及的向量和偏置
按既定规则组合词与上下文向量
独立评价词类比、相似度及命名实体识别
四、把类比、相似度排序和实体识别分开评价
作者关于概率比值的动机帮助解释设计,但不能被当作“所有语义关系一定是向量差”的证明。
损失拟合统计量,评价却是另一层:先看词关系,再看这些表示能否为下游模型提供信息。
| 项目 | 原文范围与解释 |
|---|---|
| 语料 | Wikipedia、Gigaword、Common Crawl 等不同规模配置 |
| 内在任务 | 词类比及多种词相似度集合 |
| 外在任务 | CoNLL-2003 英语命名实体识别,与 CRF 等下游设置结合 |
| 对照 | SVD 类统计方法、CBOW、Skip-gram 等词表示 |
| 变量 | 向量维度、窗口、语料和训练配置,部分比较并非完全相同 |
| 预算 | 需同时考虑共现统计构建与训练,不只看向量优化循环 |
| 不确定性 | 未对所有设置报告统一的多随机种子区间 |
证据一,第 2 节模型推导与目标函数。它把共现比值的动机落成可计算损失。这里应分清设计动机和经验验证:一个解释合理的损失仍需要数据证明其用途。
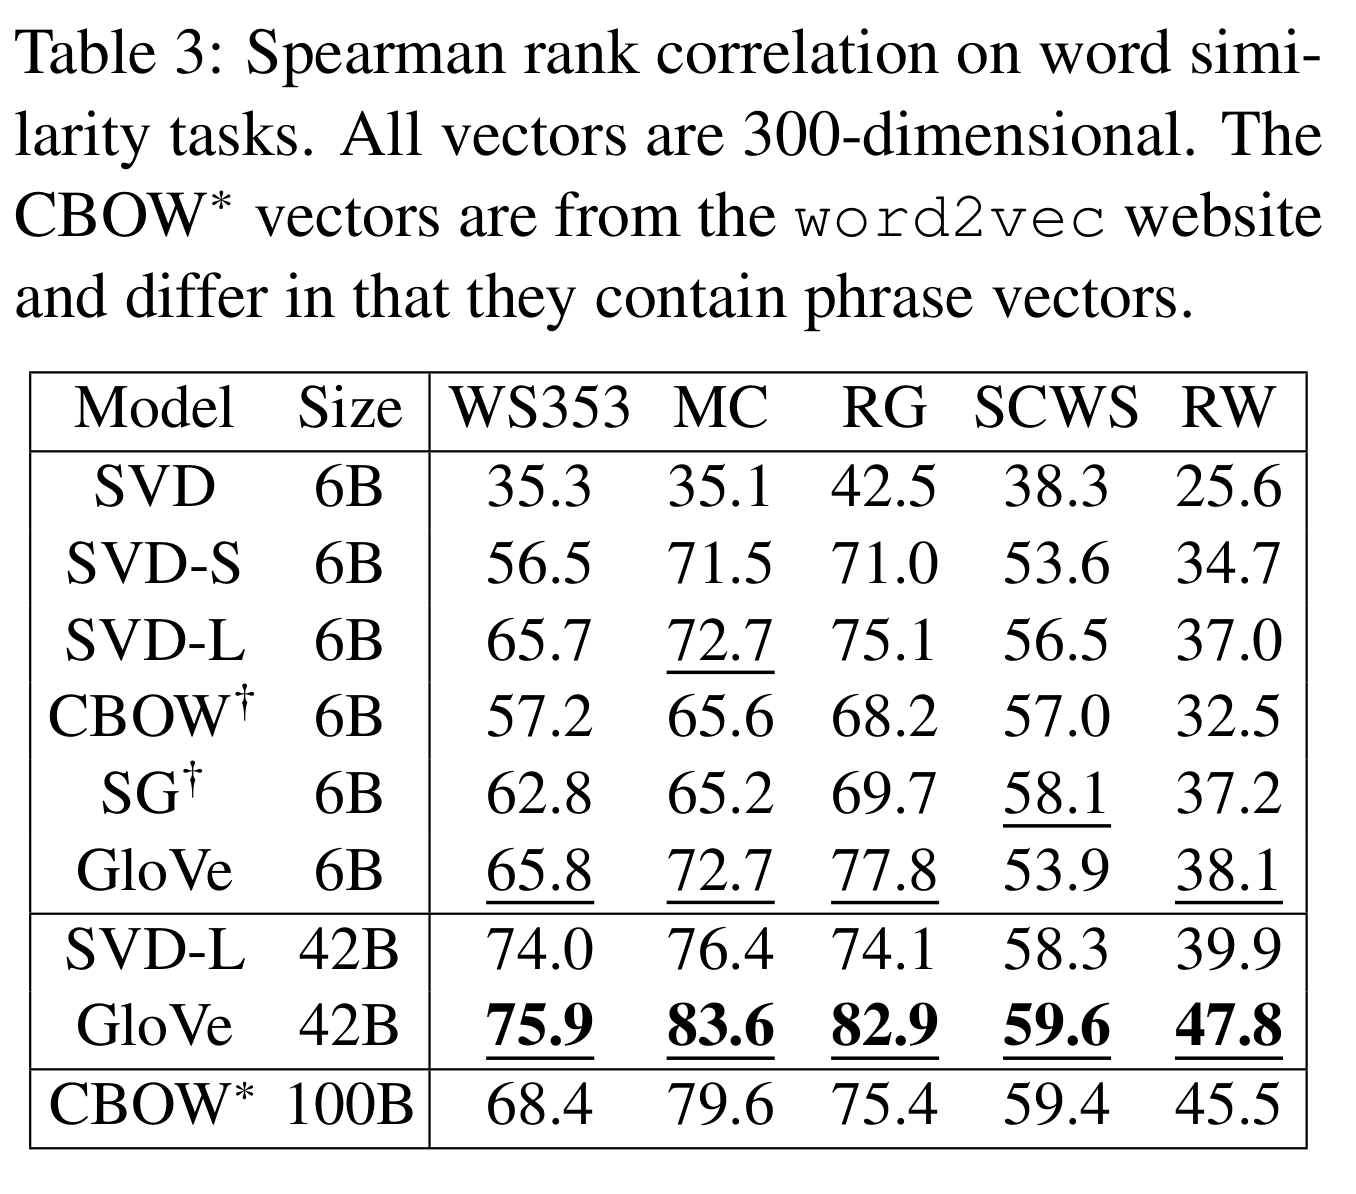
证据二,表2 与表3。类比和相似度分别检验不同性质,不能因为一种任务提升就概括为所有语义更好。表3 使用 Spearman 相关,比较的是向量相似度排序与人工判断排序,不是词语分类正确率。
证据三,表4 的命名实体识别。把向量交给下游模型,检验内在几何是否能够转化为任务信息。这比只展示近邻更接近应用,但结果仍依赖下游模型、特征和训练数据,不能推断向量单独完成了实体识别。
论文包含从十亿级到更大网页语料的设置。不同语料不仅数量不同,体裁和词汇覆盖也不同。因此“使用较少文本优于另一个公开向量”可能是有意义的系统比较,却不自动等于严格的数据效率定律。
这些例子是教学构造,并非论文报告数据。一个可操作的验证是固定共现矩阵,分别移除偏置、改变权重、保持其他参数不变,观察低频词和高频词分组表现。只看整体平均,可能隐藏某组获益、另一组受损。
五、共现几何仍受频率、窗口与语境混合约束
再设某罕见词对只出现一次,可能是真实关联,也可能是拼写错误。若给所有非零项相同巨大影响,噪声会被过度拟合;若彻底忽略少量共现,稀有知识又学不到。权重函数是在可靠性与覆盖之间折中,不存在脱离任务和语料的唯一正确形状。
余弦相似度消除了向量模长的一部分影响,但仍可能受到空间各向异性与高频方向影响。类比通常把若干向量相加减再检索近邻,结果依赖候选排除规则;如果测试词不在词表,处理方式也改变分数。
词相似与可替换性也不是一回事。“热”和“冷”可能因为相似语境靠近,尽管意义相反。GloVe 学到的是文本分布中的结构,不是带逻辑公理的概念库。这样理解才能既看到其价值,也不要求它完成训练目标没有规定的任务。
局限是静态多义词混合、词表外问题、窗口信息丢失,以及共现矩阵构建和存储成本。更大语料能够改善估计,但同时继承语料中的偏差和错误。
六、把本篇机制再推进一步
1. 未观察到的词对在损失中被跳过,能否解释为模型认定它们没有关系?
参考答案:不能。跳过是为避免直接拟合零计数的对数,也是稀疏目标的选择;未观察到可能来自语料不足。向量还受其他共现项共享约束,因此仍可能对未见词对产生相近表示。要判断遗漏是否有害,需要按频率和覆盖分组评价,而非把稀疏零项当成语义否定。
七、从静态词类型转到上下文中的词
静态向量仍把一个词的多种用法压在同一位置。ELMo改变表示对象,让特征依赖当前句子;这是上下文化方向,而不是仅换一种共现拟合损失。
自测与参考答案
1. 为什么 GloVe 训练损失下降,不等于语言困惑度下降?
它拟合的是对数共现统计,未定义每一步归一化的条件词概率。语言困惑度需要完整的概率模型与一致分词。两者目标不同,只有把表示放进语言模型并评价,才能讨论困惑度变化。
2. 表示中有偏置项,是否说明向量完全不含词频?
不是。偏置提供吸收频率的自由度,但优化结果、数据分布和维度限制仍可能让频率进入向量。要判断频率影响,需要相关性分析和控制实验,不能仅凭公式中有偏置作保证。
3. 如何证明新词向量改进不只是类比测试特化?
使用不同关系类型、词频分组和至少一种独立下游任务,固定词表覆盖与模型配置。若只在某一个检索规则下提升,应把结论限定为该评价,而不是泛称语言理解全面改进。