007|可学习对齐:解码每个词时,重新决定该看输入的哪里
论文:Dzmitry Bahdanau、Kyunghyun Cho、Yoshua Bengio,Neural Machine Translation by Jointly Learning to Align and Translate,2014 年预印本、ICLR 2015。原文 · PDF。讨论对象是循环编码解码器中的软对齐,不是后来的 Transformer 自注意力。
先接住前作的问题
Seq2Seq所代表的固定摘要接口留下一个具体瓶颈:编码结束时要把哪些源细节保存在同一向量里,才能服务全部输出位置?本篇与该工作同期发展,以每步重新读取多个源表示回答这一问题,属于平行编码解码路线;不能据目录相邻伪造直接继承。
五个前置概念
五个前置概念分别是双向编码、条件生成、softmax、可微加权和与教师强制。它们对应输入信息范围、任务目标、权重尺度、梯度通路和训练前缀来源。区分源侧双向与目标侧因果尤其重要。
一、问题设定:每个目标词需要的源信息是否必须提前挤进一个摘要
长源句包含多个实体、修饰和重排,固定向量接口要求编码器在解码开始前把所有有用细节压到同一状态。可是生成不同目标词需要不同信息:本篇保留每个源位置的注释,让“此刻读哪里”随解码状态改变。
双向循环编码器让每个注释 包含该位置附近的左右上下文。解码器仍是顺序生成模型:当前状态依赖之前输出,当前输出不能使用未来目标答案。编码源句时使用右侧源信息是合法的,因为完整源句本来就是输入,两种“未来”必须区分。
翻译目标仍然是 。
二、由软加权推导对齐网络接收翻译梯度
设解码器上一状态为 ,源位置表示为 :
是可训练的对齐打分网络, 是归一化权重, 是本次解码读取到的上下文。随后解码器结合 、上一状态和前一目标词更新,并预测当前词。每个输出位置都有自己的 ,而非全句固定一个摘要。
软加权让梯度可以通过上下文向量回到权重和源表示,所以翻译损失同时训练“读哪里”和“读到后怎么输出”。这里没有非可微的硬位置选择,也不需要 REINFORCE 来训练一个离散指针。把所有注意力都理解为强化学习选动作,会误读最基本的训练机制。
权重归一化使它们便于比较,但一个高权重源位置的注释本身已经包含邻近上下文。因而“权重落在第六个词”不等于输出只由第六个表面词决定。双向编码与下游变换共同参与结果,这也是解释热图时必须保留的边界。
对齐网络为什么能收到翻译误差
固定当前解码步,令 。这里 是源位置 的编码向量, 是匹配分数, 是读取权重, 是下游损失; 为相等时取 1 的指示量。softmax 的导数为 ,代入可得 。若下游误差梯度为 ,则 。某个位置能否提高分数,取决于它相对当前加权摘要的内容是否有助于降低损失,而非另有一名老师告诉它“应该对齐第几词”。
教学算例。 两个标量注释为1与3,分数同为0,则权重各半、上下文为2。若目标希望上下文接近3,使用 ,可得两个分数梯度分别为0.5与−0.5;梯度下降压低第一个分数、抬高第二个。连续权重让正确读取方向从任务误差中产生,无需采样离散位置或策略梯度。
构造源句“昨天,来自巴黎的工程师把红色箱子交给了医生”。生成目标语言中的“red box”时,模型可以对相关注释分配较大权重;生成“doctor”时再调整读取位置。原模型不再要求最后编码状态一次性承载所有细节的全部可用形式。
把对齐向量的归一化轴写进尺寸
若源句有4个位置、编码状态宽度6,则一次解码的对齐权重是4项,和为1;将它与4个六维状态加权相加,得到的上下文仍是六维。下一解码步重新得到另一组4项权重。归一化沿源位置,不是在六个特征通道上选一个,也不要求每个源词只被读一次。
教法联系:Jay Alammar的The Illustrated Transformer。算例为本文自构。
三、联合训练注释、打分和解码,推理时替换前缀
输入:源句 x 和训练目标 y
H ← 双向循环编码器对每个源位置的注释
初始化解码器状态 s
对每个目标位置 i:
    对每个源位置 j 计算 e[j] = align(s, H[j])
    alpha ← softmax(e)
    context ← sum_j alpha[j] * H[j]
    s ← decoder_step(s, previous_target, context)
    p ← target_distribution(s, context, previous_target)
    累加真实目标词的负对数概率
联合更新编码器、对齐网络与解码器
推理时用已生成目标词替代真实前缀,并进行候选搜索
四、分开读句长曲线、BLEU列与四个对齐样例
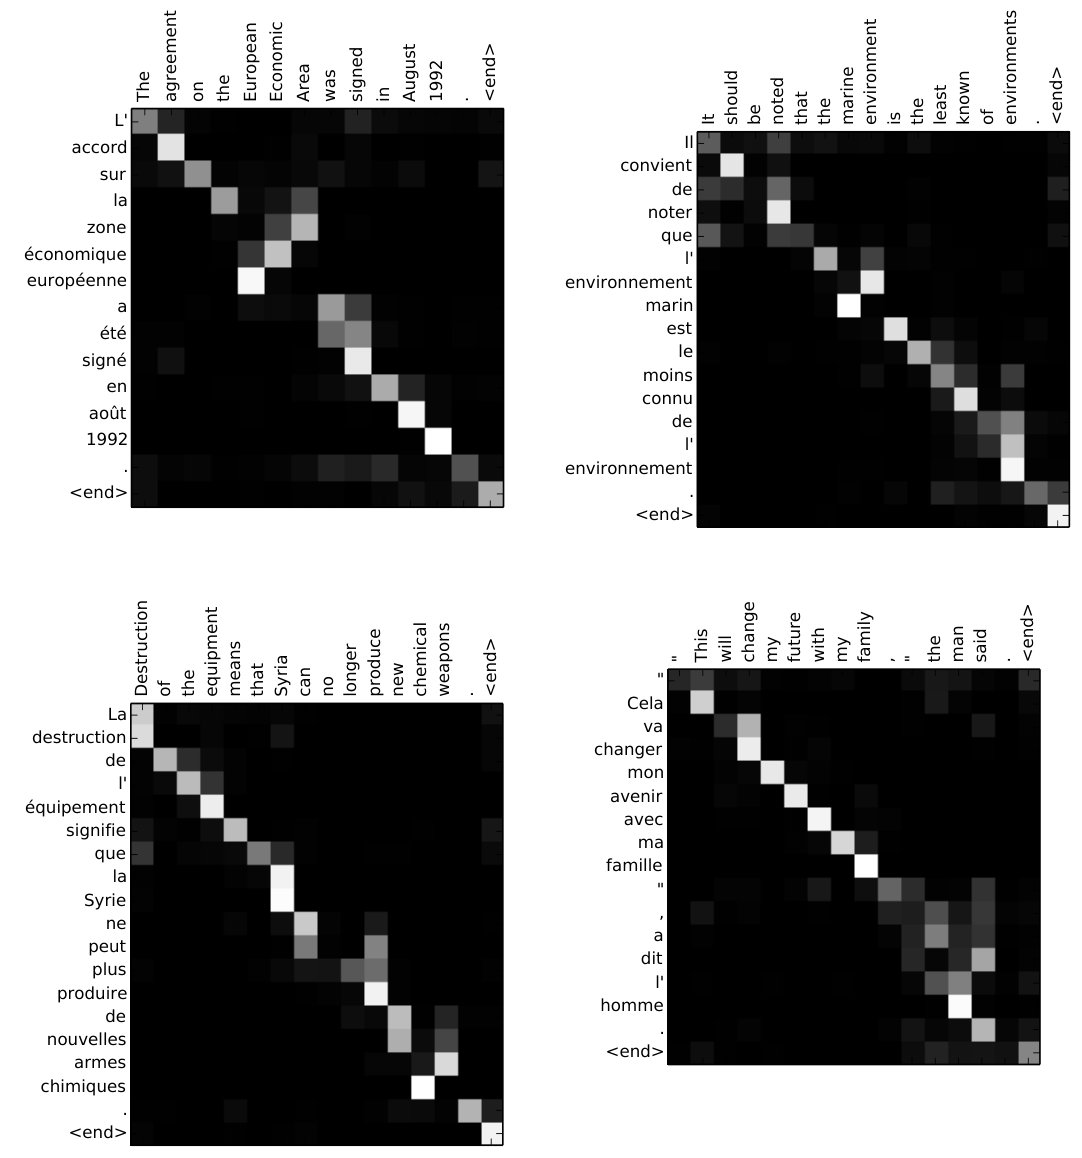
对齐图像是辅助分析,不应取代翻译性能或被当作独立证明。
如果动态读取确实缓解摘要瓶颈,句长分析应提供线索;但词表、训练时长和样例筛选必须先固定。
| 项目 | 原文范围 |
|---|---|
| 任务 | 英语到法语神经机器翻译 |
| 对照 | 固定摘要 RNNencdec 与带对齐 RNNsearch,以及 Moses |
| 长度 | 训练长度限制 30 与 50 的不同配置,需分别读 |
| 词表 | 有限词表;表1 分全部句子与无未知词条件 |
| 指标 | BLEU,附按句长分析和对齐可视化 |
| 预算 | 带星号配置训练更久;不能当作完全等训练量对照 |
| 重复 | 未报告覆盖所有模型的现代统一随机种子置信区间 |
证据一,第 3 节方法。公式定义每个输出位置的软对齐,建立可微路径。这证明算法能联合训练,但不保证得到唯一或语言学正确的对齐。
证据二,表1。全部句子列中,RNNencdec-50 为 17.82 BLEU,RNNsearch-50 为 26.75;更久训练的带星号版本为 28.45。这里同时需要保留词表条件:无未知词子集是另一列,不能拿其分数与全部句子列混比。
证据三,图2的句长曲线与图3的对齐热图。长句趋势支持固定摘要瓶颈的解释,对齐图帮助理解动态读取。图2包含未知词的完整测试集;图3横轴是英语源词,纵轴是生成的法语词,黑到白表示权重由0到1。热图只有四个样例,后三个来自长度10—20且无未知词的子集。曲线不能证明任意长度都不退化,少数可视化也不能证明所有输出都忠实使用正确源词。
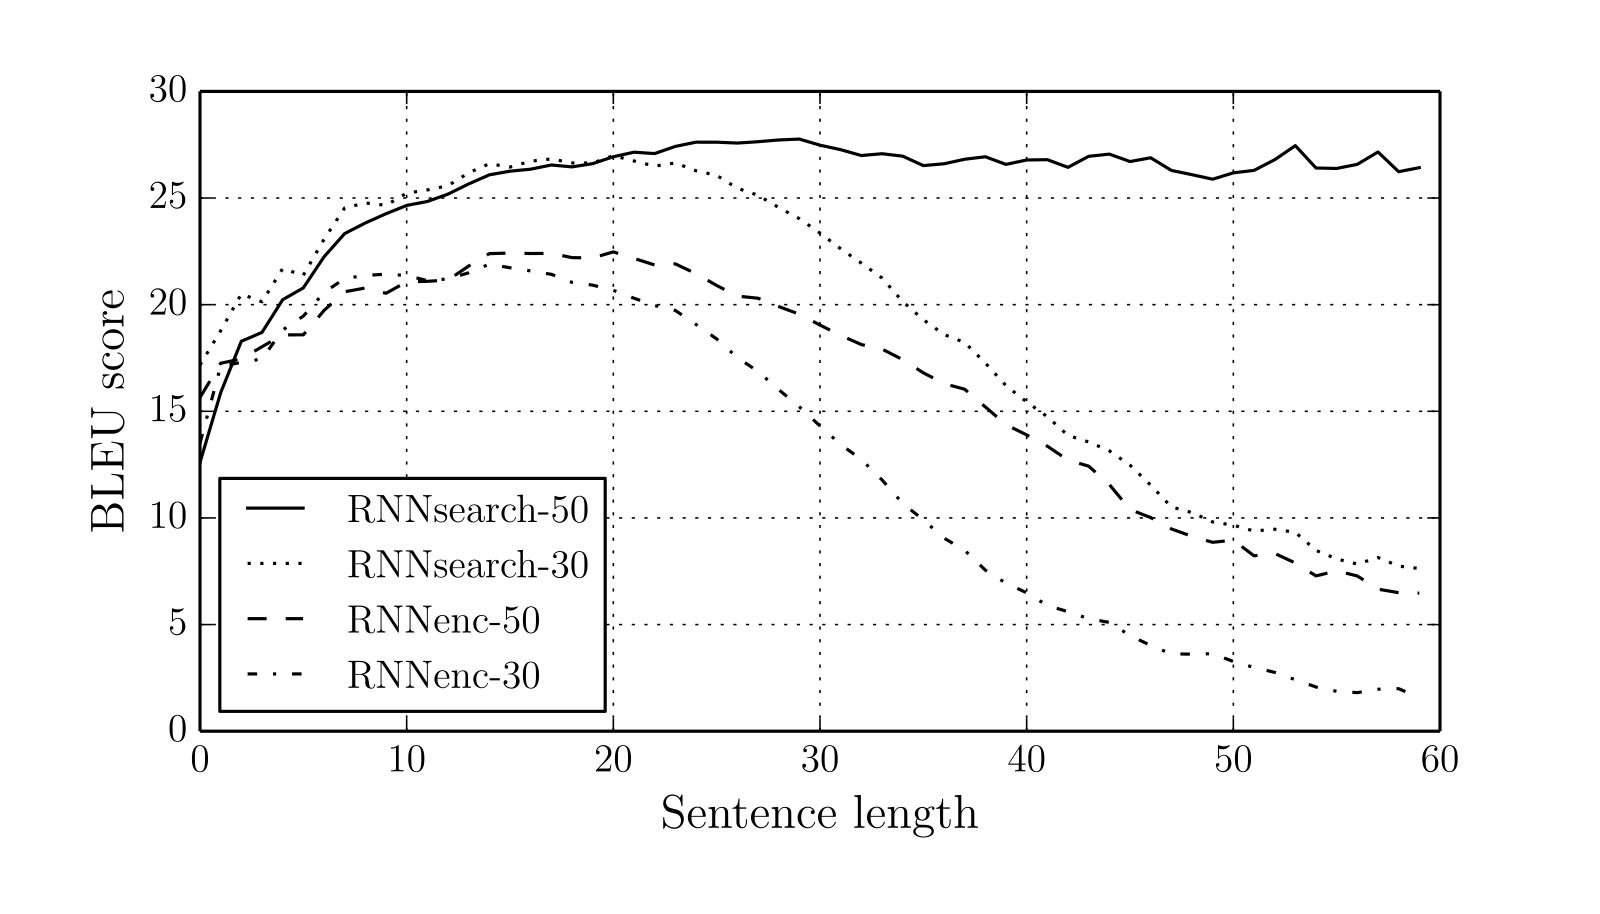
评价更长输入时,还要区分训练分布内长句和远超训练长度的外推。模型在长度约 50 的测试句子上稳健,不等于能处理数千词文档。源位置交互数量、隐藏状态表达与搜索问题仍会随长度变化。
还可以把无关插入语加长,比较基础模型与注意力模型的性能变化。若收益主要来自更容易访问远处信息,长度增长时差距可能扩大。但这只是待验证的假设,应控制词汇难度、搜索预算和训练量,避免把多种因素一起改变。
五、可访问源位置,仍不保证读对实体关系
如果两个源位置都是同名人物,模型仍可能把角色弄反。注意力只提供读取机制,不保证关系推理正确。若源表示已经混淆两个实体,动态访问也不能完全修复。因此适合做的自构测试是保留词汇但交换人物关系,看翻译是否随关系改变,而非仅检查热图是否漂亮。
后续注意力架构继承了按查询读取多个表示的思想,但原论文仍依赖循环计算,不能把 Transformer 的完全训练并行性归给它。
代价是源长乘目标长的交互计算,以及对源表示和打分质量的依赖。注意力可能分散、重复或漏读;它不自动提供覆盖约束、事实校验或长文档可靠性。本文的分析是,它的重要性在于给模型可学习的访问接口,而不是以一种权重图解决全部语言理解问题。
六、把本篇机制再推进一步
1. 若全部源注释完全相同,单改对齐权重还可能改变读取内容吗?
参考答案:不能。在本篇的加权和中,权重之和为一;相同注释的任意加权和仍是该注释。推导中的注释与当前上下文之差也变为零,因此单靠打分网络无法恢复被编码器抹掉的区分。这说明保留多个位置与保留有用差异是两项条件。
七、把动态读取扩为注意力架构
读取全部源位置已经可微,顺序解码与循环编码的路径仍在。Transformer进一步重排序列计算;可沿本篇的归一化轴与梯度检查,比较多头和位置表示引入了什么新约束。
自测与参考答案
1. 为什么软对齐可以不依赖人工词对齐标签?
加权上下文进入目标词预测,翻译损失可以通过它反传到对齐打分网络。凡是能帮助预测的读取方式都可能得到强化,因此无需独立标签。但学到的权重只受预测目标约束,不保证等于人工对齐。
2. 注意力热图能否证明某个词造成了输出?
不能单独证明。源注释包含周边信息,模型还有其他计算路径;高权重与因果贡献并非同一量。可以结合遮挡、替换和对照输入检验,但这些干预本身也需要控制分布变化。
3. 与 Seq2Seq 相比,最根本的改动是更多参数吗?
不是。关键是从固定上下文向量变成每个输出位置动态读取多个源表示。参数增加可能影响表现,但机制区别在信息通路。公平实验应尽量控制规模,检验动态访问本身的贡献。