006|Seq2Seq:用一个条件生成模型连接两种长度不同的序列
论文:Ilya Sutskever、Oriol Vinyals、Quoc V. Le,Sequence to Sequence Learning with Neural Networks,2014。原文 · PDF。以下以论文的 LSTM 编码器—解码器为对象,不把后来注意力加入到原始方法中。
先接住前作的问题
LSTM提供可学习的循环存储模块,RNNLM给出逐词条件预测;两者仍未规定怎样把一个可变长输入交给另一条可变长输出。本篇把循环模块组合成编码器—解码器。它与注意力编码解码在2014年前后并行发展,目录顺序不代表后者由本篇直接改造。
五个前置概念
理解本篇的五个前置概念是条件概率分解、编码器状态、教师强制、结束符与 beam search。分别对应训练对象、输入接口、训练前缀来源、可变长度终止及近似解码。只要明确这些,许多后来的编码解码模型便容易比较。
一、问题设定:长度不同的源句与目标句怎样共享训练接口
翻译输入有十个词,输出可能有十二个词,也未必逐位置对应。传统系统把词组、对齐和语言模型分开处理;本篇希望直接学习源句 到目标句 的条件分布,用编码状态连接两条不同长度的序列,并用结束符决定何时停止。
是编码器从源句得到的状态, 是此前目标词。链式分解允许输出长度变化,只需把结束符也当作候选 token。编码器与解码器承担不同角色:前者整理输入,后者根据输入摘要与已生成内容预测下一词。
“端到端”描述参数通过统一目标学习,并不表示系统没有任何预处理、词表或搜索选择。分词、未知词、长度限制和 beam search 都属于实际方法。若只画两个网络方框,很容易忽略这些对最终结果很重要的条件。
二、先分解条件概率,再辨析反转与状态瓶颈
编码器用多层 LSTM 顺序读源词。输入结束后,所得状态作为解码器的条件信息;解码器读开始符,再根据前一目标词逐步更新。训练时通常提供真实目标前缀,最大化参考翻译的对数似然;测试时前缀来自模型自己,错误可能累积。
源句反转并不改变句子包含哪些词,而是改变递归路径长度。假设源句开头的信息最先在目标句中使用,不反转时,它距离解码开始较远;反转后,它更靠近编码结束,从而减少某些关键依赖的距离。这是对优化的帮助,不是对所有语言重排的通用最优规则。
解码寻找高概率序列通常无法穷举。Beam search 保留若干当前得分较好的前缀,继续扩展。更大的 beam 增加搜索计算,也可能改变长度偏好与错误类型。搜索找到模型更偏好的答案,不保证找到人类认为最好的翻译,因为模型概率与翻译质量并不完全一致。
反转缩短的是哪一种距离
用理想单调对齐说明原文的解释:源句 后接目标 。忽略分隔符,正向排列中每个 都相隔4步;源句反转后,距离依次变成1、3、5、7,平均仍为4。改善并不是“所有依赖都缩短”,而是先出现容易学的短依赖,有助于建立源与目标的联系。原文 §3.3 同样明确平均距离未变;这是一种受实验支持的优化解释,作者没有把它证明为一般定理。
构造源句“红色的小球在桌上”。编码器不必把每个词保存在固定槽位,而是形成一个向量状态。解码器生成英语时,先预测“The”,再根据状态和“The”预测下一词。训练时即便第一词预测错,下一步仍可能喂入真实“The”;测试时却要面对自己的错误前缀。
按时间表追踪教师强制与部署分叉
设目标是“我 喜欢 猫”。训练预测“猫”时解码器读取真实前词“喜欢”;部署若第二词误生成为“看见”,第三词就条件于不同前缀。两个过程使用同一组权重,却走过不同状态。检查实现时可分别喂真实前缀与模型前缀,观察分叉从哪一步开始;源句反转并不消除这项差异。
教法联系:Christopher Olah的Understanding LSTM Networks。算例为本文自构。
三、把教师强制和搜索拆成训练、生成两套流程
训练输入:源句 x、参考目标句 y
将源句按论文协议反转
encoder_state ← EncoderLSTM(x)
decoder_state ← encoder_state
loss ← 0
对目标位置 t:
    用真实的前一目标词更新 DecoderLSTM
    计算下一词分布 p
    loss ← loss - log p[y[t]]
反向传播更新编码器和解码器

推理:编码输入,从开始符建立候选前缀
重复扩展并保留 beam 中候选,直到结束符或长度上限
输出得分最高的完整候选
搜索的教学反例。 假设第一步 ,而最佳后续完整序列的条件概率分别为0.2与0.9。贪心先选A,得到联合概率0.12;宽度2保留B,能找到0.36的序列。若模型却把正确翻译对应的B概率压到接近零,扩大beam只会更准确地优化错误的模型目标。这个两层树把搜索错误与建模错误分开了。
四、区分反转、集成、句长和SMT重评分的收益
不能说训练直接最大化 BLEU,也不能把 beam 搜索改进等同于参数能力提高。模型、搜索和集成必须分别列出。
沿训练、搜索两个层次读表:先比较单模型反转,再增加集成与候选重评分。
| 项目 | 原文范围及条件 |
|---|---|
| 任务 | WMT 2014 英语到法语翻译 |
| 模型 | 多层 LSTM 编码器—解码器,源序列正向与反转对比 |
| 输出 | 有限词表,未知词问题是明确限制 |
| 解码 | 不同 beam 宽度与多个模型集成,表格分别列出 |
| 对照 | 传统翻译基线,以及结合 SMT 候选重评分的设置 |
| 指标 | 测试 BLEU;不是逐词准确率,也不是人工充分性评分 |
| 重复 | 集成模型数可见,不应把集成解释为多随机种子误差条 |
证据一,方法与源序列反转讨论。论文给出条件生成目标与反转输入的动机,说明优化路径可以通过数据排列改变。这并不意味着模型学习了显式对齐矩阵。
证据二,表1。相同 beam 12 下,单个正向 LSTM 为 26.17 BLEU,单个反转 LSTM 为 30.59;五个反转模型集成、beam 12 为 34.81。反转与集成是两项不同变化,不能把最后分数全部归给反转。
证据三,第 3.7 节与图3。按句长观察表现,检验固定状态是否立即在较长输入上失效。论文结果表明该设置下长句仍可处理,但不证明固定向量可无损表达任意长度。表2 的 SMT 重评分也应作为额外系统条件阅读。 读图时分开两幅横轴:左侧按句长排序,右侧按平均词频排名排序;长句退化与罕见词退化不是同一个控制实验。
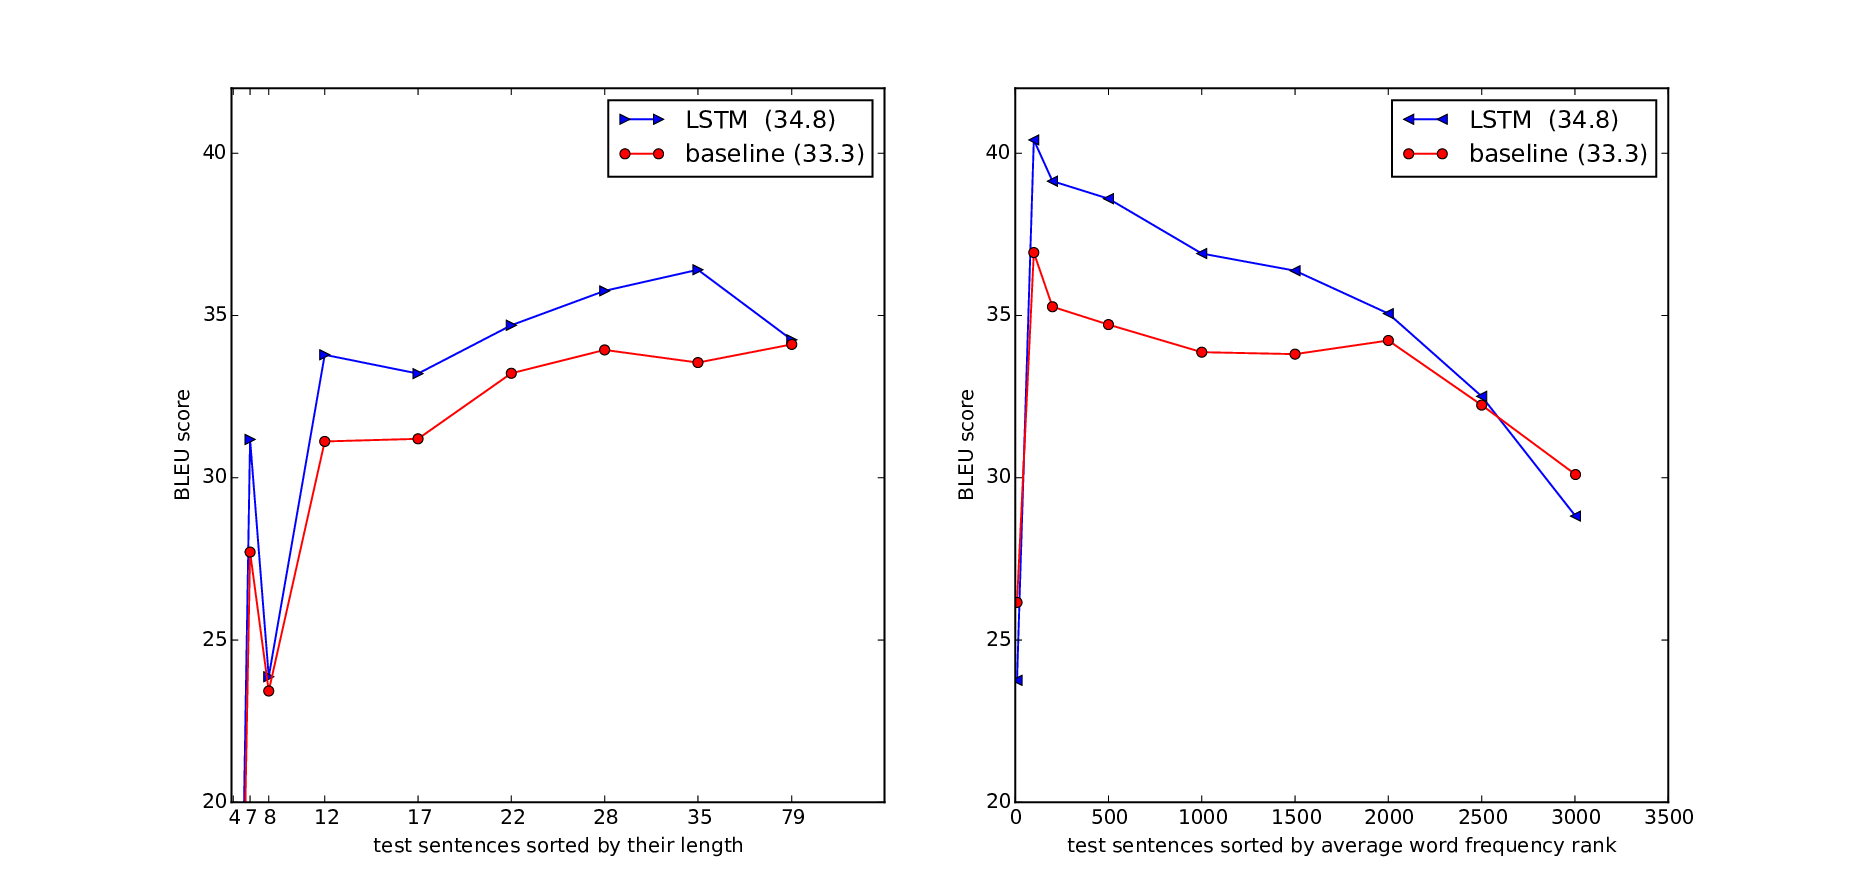
还有一个重要比较边界:生成式模型可能无法输出未知词,传统系统却有不同的词表处理方式。若只比较一个总 BLEU,不说明词表与数据筛选,就会遗漏能力上限。评分差异既可能来自建模,也可能来自可输出符号集合。
五、固定状态与近似搜索各自遗漏了什么
若模型把“红色”信息在编码过程中丢掉,增大 beam 通常无法凭空恢复。若颜色信息仍在,正确翻译只是早期被贪心选择淘汰,那么 beam 可能有帮助。这个区别解释为什么搜索预算只能修复某类错误,不能代替表示能力。
再把源句末尾加入“不是红色,而是蓝色”。状态需要整合更晚的否定信息,单纯让最初词离解码更近不一定足够。反转是针对当时训练问题的有效技巧,其价值来自实验,不是普遍语义定理。
Seq2Seq 提供了可复用的任务接口:翻译、摘要和其他序列转换都可以写成条件生成。它把不同长度与非逐位置对齐放进统一概率模型,减少手工模块边界。这里的通用性指形式统一,不等于一个在翻译上训练的模型无需新数据就能完成任意任务。
代价是顺序计算、有限状态瓶颈、教师强制下的前缀分布差异,以及昂贵集成搜索。本文的分析是,下一篇注意力通过让解码器直接访问多个源状态,改变了最关键的信息通路;它不是简单增大原来的摘要向量。
六、把本篇机制再推进一步
1. 反转后平均源目标距离不变,为什么仍可能更容易训练?
参考答案:教学单调对齐中距离从全部4步变为1、3、5、7步,最早的短依赖可能先帮助模型建立输入输出联系。优化不只由平均距离决定,还与梯度首先能学到哪些关系有关。原文把它作为受结果支持的解释,并没有证明所有排列或语言都受益。
七、保留条件生成接口,改写信息读取路径
固定句向量仍要承载所有源信息。Attention直接松开这一瓶颈,让每个目标位置重新读取源状态;比较时应问改善来自可访问信息,还是仅来自更宽隐藏层。
自测与参考答案
1. 为什么反转源句可能有帮助,却不是翻译时把意思倒着理解?
反转改变词在循环计算中的时间位置,从而缩短部分输入输出依赖路径。词的身份和监督翻译没有改变,模型仍学习正常目标句。它主要影响优化和信息路径,不是语义规则。
2. 更大的 beam 为什么不能保证更高 BLEU?
Beam 更接近模型的高概率解,而模型似然与 BLEU 不完全一致;长度偏好、错误校准也可能被放大。它还无法补回编码器没有保留的信息,因此需要实测质量与搜索成本。
3. 怎样区分架构、集成和重评分的收益?
先固定数据、词表、单模型和 beam 比较架构,再固定模型比较 beam,再单独增加集成;使用 SMT 候选时另列系统结果。只有把变化拆开,才能把每个提升绑定到相应机制。