003|RNN 语言模型:让预测器携带一个不断更新的过去
论文:Tomáš Mikolov 等,Recurrent Neural Network Based Language Model,INTERSPEECH,2010。会议页面 · 正文。本文围绕网络结构、WSJ 与 NIST RT05 实验展开,表格位置以四页会议论文为准。
先接住上一篇的问题
第002篇 NNLM已经让不同句子通过共享词向量传递统计经验,但预测时仍显式截取固定宽度的词窗口:窗口外的话题要怎样影响下一个词?本篇保留条件语言建模任务,把这条硬截断改为可递推的隐藏状态,这是结构上的直接延伸。第001篇 LSTM研究的则是长时延梯度,本篇使用简单 Elman 网络,并未把 LSTM 门控接进来;两者是不同循环单元的教学对照。
五个前置概念
理解本篇需要五项概念:隐藏状态保存输入相关信息;参数保存跨样本学到的规则;BPTT 将输出误差传播到较早计算;插值组合多个概率模型;WER 衡量整个识别输出中的词错误。把状态和参数严格分开,是后续理解上下文学习和测试时适配的基础。
一、问题设定:固定词窗口之外的话题怎样参与预测
想象会议先讨论数据库,几十个词后出现“索引”。此前话题可能有助于预测这个词,却不一定处在最近五个词中。把所有历史词拼进窗口会直接扩大输入;本篇改为维护一个有限维循环状态。因此具体问题是:每读入一个词,怎样更新这个压缩表示,让窗口外的话题仍能影响下一词预测?
模型的输出仍是下一个词的条件分布,任务仍是文本似然学习。应用到语音识别时,声学系统提供候选序列,语言模型辅助重新评分;语言模型本身不直接从音频波形识别所有词。区分模块权限很重要,否则会把整个识别系统的结果误归给单个神经网络。
原论文同时讨论静态与动态使用。静态模型在评估时不再改变权重;动态适配会利用已经观察到的文本继续更新。只利用过去已揭示的信息可以是一种合法在线协议,但它与完全冻结参数的测试条件不同,必须单独标明。
二、从循环状态推到下一词分布
用简化记号表示网络:
表示当前词输入, 为此前状态, 为更新后的历史表示, 给出下一词概率。 是共享权重。输出误差既训练预测映射,也训练状态如何保留对未来有用的信息。
对比固定窗口模型,递归权重在每个时间步复用,所以增加序列长度不要求新增一组位置专属参数。但是状态仍然有限,不会把过去每个词原封不动存下来。网络需要压缩、覆盖和选择,训练也受反向传播范围及梯度质量限制。
可见历史与梯度历史各自到哪里
原文将词输入与旧状态 拼接为一个输入;拆开后是 ,再用 预测下一词。与上式对应: 就是 , 就是 , 分别对应 ;上式额外写出的偏置 是教学通式,取零才对应这里的原文简式。 是输出矩阵, 是逐元素 sigmoid。
原文第2页明确使用 的截断反传:只用当前步误差更新权重,不把本次梯度继续传入生成旧状态的计算图。旧状态的数值仍参与前向,所以“当前误差只教一步”与“只能看一个词”不是一回事。
用相同当前词检验状态是否真的不同
教学算例。 设两段历史产生状态 与 ,当前词相同,下一词二分类 logit 差为 。两次预测概率分别为 与 ,全过程无需更新任何权重。若在线训练随后修改系数 2,才属于参数适配。测跨句能力时应分别控制状态是否重置、权重是否更新与句子顺序。
三、实现时分别固定状态、梯度与适配协议
状态、反传范围和权重更新是三个独立开关。实现时先明确这三个开关,才有可能把静态与动态结果放进同一张可比较的表。
原文输出误差写成 desired−y;用最小化交叉熵的记号则是 ,方向相反是因为一个写增量、一个写损失梯度。令 ,当前步有 、、。SG只切断旧状态的梯度,不抹掉它的值;这使共享循环权重仍能用当前输入—旧状态对学习。这里按前述无偏置简式写梯度。
原文逐词更新,初始学习率为0.1;每个epoch后看验证似然,改善不明显时降低学习率。动态模型在测试流中以固定0.1做一次在线更新,静态模型只递推状态。测试得分必须先于使用该词作为已揭示目标的更新。
输入:词序列、隐藏维度、词表;初始化 U、W、V 与状态 h
逐词训练:
    old_h ← stop_gradient(h)         # 保留数值,只切断跨步反传
    h ← sigmoid(U * current_one_hot + W * old_h)
    p ← softmax(V * h)
    loss ← -log p[next_word]
    对当前计算图反传;用SGD更新 U、W、V
    携带 h 的数值进入下一步,不清空前向历史
每个epoch后用验证似然决定继续训练和学习率下降
静态测试:只算概率并递推状态,不更新权重
动态测试:先给当前目标评分,观察该词后做一次当前步更新
语音重评分:按论文的候选与模型混合协议结合其他系统得分
四、读 WSJ 与 RT05:概率改善能否转为识别收益
WER 统计替换、删除和插入错误,相对于参考词数归一化。它并不是交叉熵,因此困惑度下降不必产生同比例的 WER 下降。尤其当正确转写不在候选列表里,语言模型无法仅靠重排恢复它。
现在把实现协议带回证据:先看使用哪些数据和模型组合,再看 PPL 与 WER 是否一起变化,最后检查 DEV 上的排序能否延续到 EVAL。
| 项目 | 原文设定与比较条件 |
|---|---|
| WSJ 数据 | 文中 RNN 实验使用 6.4M 词训练数据;部分传统对照使用更多数据 |
| 另一任务 | NIST RT05,进一步考察较强语音识别系统中的作用 |
| 基线 | 修改 Kneser–Ney 的高阶 n-gram,与神经模型及其组合 |
| 指标 | PPL 检验概率拟合,WER 检验识别结果 |
| 变化因素 | 隐藏单元、模型混合、静态或动态更新,不可混作同一配置 |
| 预算与重复 | 论文给出具体模型设置;完整现代硬件吞吐与统一多种子置信区间未报告 |
证据一,网络结构与复杂度部分。递归状态使历史影响不被固定窗口直接截断,但没有证明所有远程信息都可恢复。读者应把结构表达能力与训练可达能力分开。
证据二,表2 的 WSJ DEV。KN5 基线为 PPL 221、WER 13.5;三模型动态 RNN 与 KN 组合达到 PPL 121、WER 11.1。按显示值计算 WER 相对下降约为 17.8%。这个对比包含模型组合和动态处理,不是一个静态小网络相对基线的纯架构收益。
证据三,表3 与表4。论文把 WSJ 开发与评估、以及 RT05 结果分别报告,检验收益能否出现在不同识别条件中。RT05 中 RNN 使用约 5.4M 词域内数据,传统模型训练来源和数量不同,因此不能将所有结果解读为严格等数据实验。
读一个反直觉结果。 原文表3的 WSJ EVAL WER,静态混合模型为 15.5,动态模型为 16.3;作者脚注指出评估句子并不连续,跨句适配可能因此失效。DEV 上变好并不保证 EVAL 同向变化。表4在 RT05 的改善又包含与大规模 backoff LM 的混合,不能全部归于单个 RNN。
读表3时固定评价列。 DEV WER 与 EVAL WER 都越低越好,分别对应开发集和评估集。动态组合在 DEV 列低于静态组合,到了 EVAL 列却高于静态组合;不能只凭开发集排序就宣称动态更新处处更好。前段表2的 PPL/WER 数值也不是这张表3的同一组单元格。
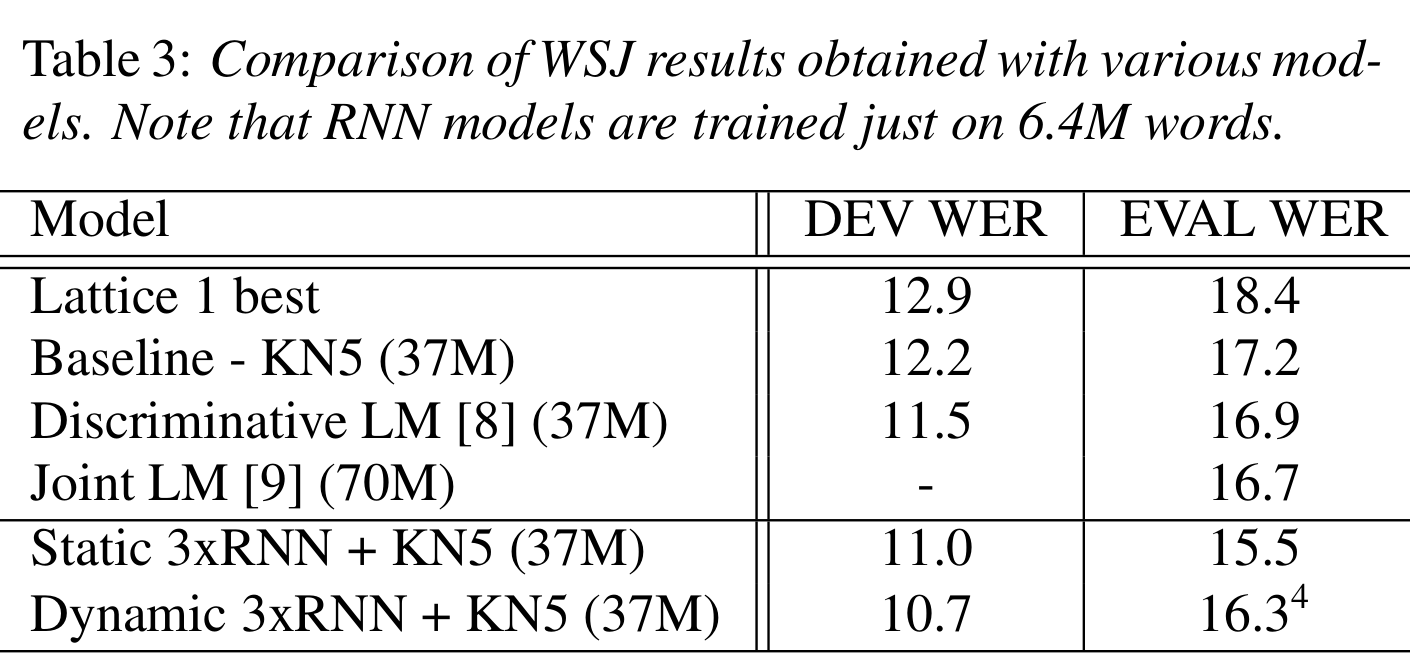
这种证据结构比只报告一个困惑度更有说服力,因为它触及实际下游任务;同时也更需要小心归因。声学候选质量、插值系数、动态更新和集成数量都可能影响 WER。架构有价值与收益完全由架构独立造成,是不同结论。
五、识别收益受哪些状态容量与流水线条件约束
再构造两个不同长前缀,经过压缩后得到很相似的状态。如果任务要求区分其中一个早期专名,而模型已经把它覆盖,后续输出就无从恢复。递归依赖不是无损存储,这正是后来门控记忆与注意力持续研究的原因。
它没有取消 n-gram 的实用价值,也没有证明神经模型在所有数据量和延迟要求下占优。
训练和推理的顺序依赖是直接代价。要得到第 步状态,通常先要计算前一步;长序列的并行方式受到限制。小状态可能丢信息,大状态又增加计算与优化难度。与 Transformer 比较时,应同时看上下文访问方式、状态内存、计算随序列增长的规律,而不是只比名称新旧。
六、沿状态与适配继续追问
1. 保留跨句状态但冻结权重,是否等同于论文中的 dynamic 模型?
参考答案:不是。保留状态改变的是下一次预测所条件化的信息;dynamic 还会用已经读到的文本改变权重。可以把“句界是否清空状态”和“是否更新权重”做成两个独立开关,在相同句序上比较四种协议。这样即便某个设置更好,也能分辨收益来自前向上下文还是参数适配。两种做法都不能利用当前尚未揭示的目标词。
2. 截断反传后,模型是否立刻退回固定窗口 NNLM?
参考答案:不一定。若前向状态继续传递,它仍可能包含截断范围以前的信息;截断的是当前损失向更早计算传播梯度的路径。若同时重置状态,才另外截断了可见历史。复现实验因此需要分别报告反传长度与状态重置条件,不能只给一个“上下文长度”就认为两种模型使用了相同信息。
3. 怎样检验动态适配失败是否与句子不连续有关?
参考答案:可以提出一个受控实验:固定权重初值、候选列表、插值系数和更新预算,对同一批句子分别保留原次序与打乱次序,并在每种次序下比较静态和动态协议;另行控制句界状态重置。若差异随次序改变,才为连续性解释增加证据。原文表3及脚注给出了这种解释的线索,没有完成上述因果隔离,因此不能把这个实验设想写成论文已经证明的结论。
七、从压缩状态走向另外两条路线
- 压缩状态的另一种训练机制:LSTM用门控和内部存储路径处理长时延信用分配。这是较早工作的机制对照,不是 2010 年 RNNLM 之后才出现的改进。
- 计算目标分叉:word2vec转向便宜的词表示学习。本篇学习序列条件概率,后者的表示目标不能直接替代 PPL/WER 评价,二者是相关但不同的路线。
- 跨片段记忆的教学延伸:Transformer-XL也需要区分前向可读的历史与可反传的历史,但读取的是片段表示,不能视为本篇简单循环状态的同名替换。
自测与参考答案
1. RNN 看到了任意长历史,为什么仍可能忘记第一句话?
历史通过有限维状态压缩,新的内容会改变状态;训练梯度也未必能指导长期保留。公式中的递归依赖只说明存在信息路径,不说明每条信息都被保留,更不说明能在需要时正确读出。
2. PPL 从 200 降到 100,WER 是否也应减半?
不应。PPL 衡量真实词概率的几何平均,WER 依赖候选排序和完整识别流程。概率可以明显改善,却不足以改变最高分候选;也可能少量概率变化恰好纠正关键排序。两者要分别报告。
3. 如何公平比较静态与动态语言模型?
明确动态模型能访问哪些已观察文本、何时更新、是否使用真实标签,以及总更新成本。静态对照应共享候选系统和测试集。合法的在线适配仍然是额外能力与预算,不能在结果表里省略。