002|神经概率语言模型:用共享表示跨越没见过的句子
论文:Yoshua Bengio 等,A Neural Probabilistic Language Model,JMLR,2003。论文页面 · 正文 PDF。
先接住前作的问题
LSTM关注远程误差能否穿过时间,本篇回到另一条问题线:即使只看短窗口,没出现过的词组合该怎样分配概率?两者是优化记忆与统计共享的平行问题。这里先建立神经条件概率接口,后续RNNLM才在该接口上把固定窗口改为循环状态。
五个前置概念
理解这篇最需要掌握条件概率、最大似然、softmax、词嵌入和困惑度:分别对应预测对象、训练原则、归一化方式、共享参数与评价尺度。
一、问题设定:没出现过的词组合怎样获得合理概率
训练文本有“猫坐在垫子上”,没有“狗坐在垫子上”,模型需要用已知句子帮助预测未知组合。若词表有 个词,长度为 的组合可达 ,逐一观察不现实;任务因此是在未见词序列上泛化,同时让全部候选概率相加为一。连续共享表示要与成熟的平滑计数方法比较,而不是与只会背句子的查表比较。
本文将序列概率按链式法则分解,再以固定长度上下文近似条件概率:
链式法则是精确恒等式,截取有限历史才是建模近似。混淆这两者会把任何语言模型都误认为只能利用 n-gram。这里的训练任务属于自监督下一词预测,正确词直接来自文本,不需要额外人工给每句话分类。
离散计数模型也有成熟的平滑与回退方法,因此正确对比并非“神经网络对完全不会泛化的查表”。真正的问题是:连续共享表示是否能在给定数据与训练条件下提供更有效的统计共享?论文实验使用修改 Kneser–Ney 等对照,正是为了回答比稻草人比较更有意义的问题。
二、从共享词表推到条件分布与梯度
每个词 对应矩阵 的一行。把上下文中各词的向量拼接为 ,送入隐藏层,得到候选词分数 :
构成非线性预测路径, 表示可选的输入到输出直接连接, 为偏置。词向量矩阵与这些参数同时更新。直接连接与具体配置应按论文实验区分,不能假定所有列都使用同一个网络。
训练最小化真实下一词的负对数概率,并可加入正则项。一次样本更新不仅改变整句的评分,也改变上下文词向量。当“猫”和“狗”在相似环境中出现时,它们可能获得使预测行为相近的表示,从而把一条经验迁移到相关句子。
这是一种可学习的泛化机制,不是“距离近就一定是同义词”的约束。表示由任务和数据决定:反义词也可能拥有类似上下文,专名和罕见词则可能估计不准。用模型训练目标解释向量,比把每个维度想象成人类定义的语义轴更准确。
一个词怎样从别的句子获得梯度
以无直接输出连接的版本为例,、、。这里 是词的嵌入, 是输入至隐藏、隐藏至输出的权重, 是偏置, 是词表分数,; 是真实目标词的 one-hot 向量, 是单次预测损失。交叉熵首先给出 ,再经 与隐藏层导数回传到 。取出对应位置的分量,就得到同一张词表 中被访问行的更新;同一个词在不同句子、不同位置的梯度累加到同一行。泛化由共享参数产生,不是人为把同义词标签加入损失。原文 §2 还允许 直接连接;解释简化版本时不能把它说成唯一实现。
教学算例。 词表有 10,000 词、上下文长 4、每词向量 50 维、隐藏层 100 维。忽略偏置及可选直连,嵌入、隐藏、输出矩阵分别需要 、、 个参数。增加上下文一个词仅增加 个隐藏层参数,而一个完整条件概率表的上下文数量还会再乘 10,000。节省来自受约束的参数共享,也意味着模型不能为每个历史任意指定完全独立的分布。
让共享词向量的两次更新可见
把词表暂设为三项、嵌入宽度为2,查表得到的不是三个新参数,而是同一个三行矩阵中的一行。某词先出现在“喝一杯…”、又出现在“杯子里有…”的窗口时,两次误差都累加到这行;其它输入行本步可无梯度,输出softmax参数却仍受全部类别归一化影响。输入查表稀疏与输出计算便宜不是一回事。
教法联系:Jay Alammar的The Illustrated Word2vec。算例为本文自构。
三、联合更新嵌入和预测器,再统一评价单位
输入:分词文本、有限词表、上下文宽度 n-1
初始化词向量矩阵 C 与预测网络参数
重复遍历训练样本:
    取上下文词 ID 和真实下一词 y
    查 C 并按位置拼接为 x
    计算隐藏表示及全部词表 logits
    p ← softmax(logits)
    loss ← -log p[y] + 正则项
    反向传播,同时更新 C 和预测网络
在验证集选择模型;在独立测试文本累计负对数概率
输出:归一化的条件词概率与联合学得的词表示
四、把 Brown 与 AP News 的困惑度放回条件中
它没有直接优化翻译质量、回答真实性或句子可读性。下游能力可以与似然相关,但这种关系需要另外检验。
在比较论文数字前,先固定困惑度的单位,再读两种语料各自的对照。
| 项目 | 原文设置与应读条件 |
|---|---|
| 数据 | Brown 与较大的 AP News,两种语料分别比较 |
| 基线 | 回退 n-gram、修改 Kneser–Ney、插值或类别方案等 |
| 变量 | 上下文长度、词表示维度、隐藏层、直接连接及模型混合 |
| 指标 | 验证和测试困惑度,越低表示分配给真实文本的几何平均概率越高 |
| 计算 | AP News 实验说明约三周、40 CPUs、5 个 epoch;这不是现代训练速度基准 |
| 不确定性 | 不将最佳表格项当作多随机种子均值;误差条与种子协议未形成现代统一报告形式 |
证据一,模型定义与训练章节。公式明确词表示和概率网络联合优化。这支持“表示来自预测任务”的解释,不支持向量必然对应可解释概念。
证据二,表1:Brown。原文比较不同神经网络与平滑 n-gram 配置,并讨论较长上下文的利用。阅读时需沿同一列比较测试困惑度,不能把训练集较低的数值当作泛化提升。
证据三,表2:AP News。表中神经模型测试困惑度为 109,所列五阶 Kneser–Ney 为 117。按这两个显示值自行计算,相对下降约为 。原文文字给出约 8% 的概括;应保留比较条件与取整差别,而不是强行让两者看起来完全一致。
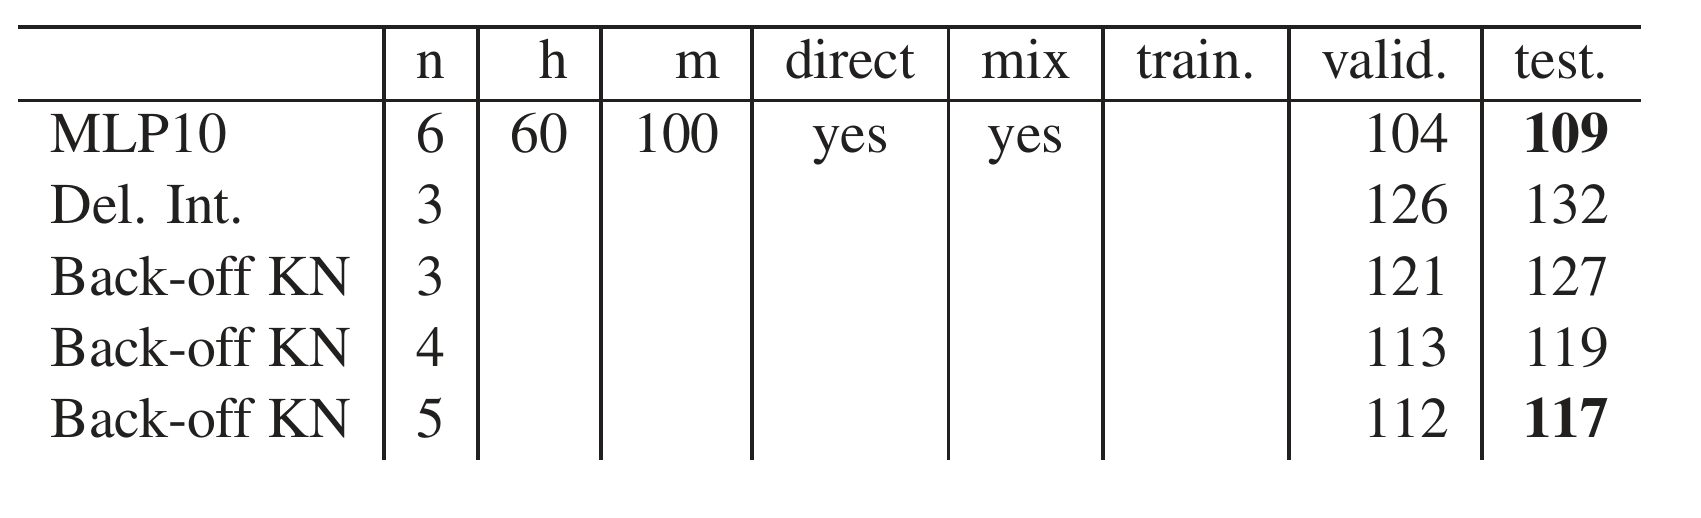
额外需要检查“神经模型”和“混合模型”的区别。若最终分数结合神经网络与传统模型,它说明两者具有互补信息,不应被描述成单个神经网络独立达到同一结果。论文的历史价值也不要求它在所有成本指标上胜出;当时的训练代价恰好说明为何后来会发展分层输出和采样近似。
困惑度定义为 。它是每词负对数似然的指数,依赖分词、词表和未知词处理。若一个模型把文本切成词,另一个切成字节,两者的每 token 困惑度不能直接横比。
教学构造中,模型给四个真实下一词都分配概率 0.25,困惑度为 4;若分别给出 0.5、0.5、0.125、0.125,几何平均概率仍是 0.25,困惑度同样为 4。相同总体指标可以隐藏不同位置的错误,因此还应观察罕见词、长上下文和不同文本类型。
五、共享泛化仍受窗口、词表与输出成本约束
这也说明低困惑度并不等价于总能选对最高概率词。概率校准和候选排序都可能改变对数损失。评价模型是不是“理解语言”,需要比单一数字更明确的任务定义。
局限包括固定窗口不能直接访问更早信息、全词表归一化成本高、罕见词表示数据不足,以及词表外表达问题。
本文的分析是,后续词向量工作将表示训练变得更便宜,循环模型扩展历史建模,Transformer 改变跨位置交互。它们分别缓解不同瓶颈,不能把后续所有能力都当作 2003 年模型已经具备。
六、把本篇机制再推进一步
1. 把所有上下文词的向量固定,只训练输出层,还能检验本文的全部贡献吗?
参考答案:不能。这样仍能检验已有表示的预测价值,却移除了“下一词误差反过来塑造词表示”这条联合学习路径。应将冻结嵌入和联合训练放在相同数据、词表及预测网络下比较,才知道收益中有多少来自表示适配;不能把这个消融结果预先假定为一定下降。
七、按历史长度与表示成本分出两条路
固定窗口之外的词仍不可见。RNNLM直接改变历史表示;Word2Vec则删去昂贵隐藏层,把目标转向廉价表示学习。前者扩展条件信息,后者改变计算与任务取舍。
自测与参考答案
1. 为什么一个词向量被更新,会影响许多没出现过的句子?
同一个词在不同上下文中查到的是同一行参数。改变它会改变所有包含该词的输入表示,预测网络又共享跨样本的计算规则,因此影响不局限于当前句子。这种共享既带来泛化,也可能让不相关词义互相干扰。
2. 两个模型困惑度分别为 20 和 30,能否立刻说前者更好?
需要先确认相同测试文本、分词、词表、未知词和评估单位。即使这些相同,也只能说明前者在该文本的平均对数概率上更好;不能直接推出问答、真实性或计算效率全面更优。
3. 若把上下文宽度翻倍,为什么不保证效果提升?
更多位置提供潜在信息,也增加输入维度和参数需求。有限数据下可能更难优化或过拟合,远处内容也可能无关。应固定数据并比较验证损失、训练代价与不同距离的信息利用,而不是把输入更长等同于学到了长程关系。