005|负采样与短语表示:把全词表预测改成可扩展的局部判别
论文:Tomas Mikolov 等,Distributed Representations of Words and Phrases and their Compositionality,2013。原文 · PDF。重点是负采样、频繁词下采样与短语构造,而非重新介绍全部词向量历史。
先接住前作的问题
word2vec已经删除昂贵隐藏层,但输出训练仍需处理很大的词表,高频词还会占去大量更新。本篇直接扩展其训练路线:用少量噪声词替换全词表判别,并分别改变样本分布与短语单位。这三个改动要独立追踪,不能只称作换了一个更快损失。
五个前置概念
理解本篇需要掌握 sigmoid 二分类、负例分布、下采样、共现统计和代理目标,特别要区分“抽样近似同一目标”和“换成另一个便宜目标”。
一、问题设定:每个真实词对是否必须遍历全词表
训练“中心词—邻词”关系时,完整 softmax 要把全部候选得分归一化,成本随词表扩大。既然最终主要使用词向量几何,能否转而区分真实搭配和少量噪声搭配?这会改变学习目标,而非只是更便宜地计算同一个精确条件分布。
另一个问题来自词频。像冠词、介词这样的常见词产生大量训练对,却不一定提供同等多的新信息。下采样主动改变这些词出现的训练频率,节省计算,也改变中心与上下文统计。效率与表示质量因此可能同时变化。
二、从数据噪声比推导点积,再调整样本和词项
设 是中心词向量, 是上下文向量。一对真实词 的目标为:
为 sigmoid, 为负例抽样分布, 为负例数量。第一项推高真实搭配得分,第二项压低抽样噪声搭配。只需更新涉及的少量向量,不必遍历全部词表。论文使用词频分布的幂变换构造噪声,不能把“均匀随机抽词”当作完全相同的算法。
这是判别式代理目标。某个点积很高,意味着它在给定噪声比较下更像真实搭配,而不是已经可以直接当成某个校准概率。要得到归一化语言模型,还需要另行定义输出和训练方法。
频繁词下采样以较高概率跳过高频词,使模型减少重复学习常见搭配。短语检测则根据词对出现次数相对于各自频率的关联程度,合并如专名这样的组合。它是基于统计的预处理,不是一个已经理解所有语法结构的解析器。
“纽约”和“新”加“约克”的意义并非总能简单相加,因此给短语一个独立词项可能有用;但合并过多会扩大词表、制造稀疏项,还可能把偶然共现当作固定短语。阈值和多轮合并影响数据,必须进入实验条件。
负样本到底把点积推向哪里
把一对词 的点积暂视为可独立调节的标量 。若真实共现计数为 、负例期望计数为 ,局部目标是 。求导为 ,驻点满足 ,故 。这是本文给出的教学推导:有限维共享向量不能同时独立实现所有驻点,但它说明点积表达“相对噪声有多异常”,不是可直接归一化的下一词概率。
教学算例。 同一词对真实出现20次,负例期望为5次,最优独立点积为 ;若噪声分布改变令负例变成10次,则点积变为 ,真实语料完全未变。调整负例数量或分布会改变学习问题;不能把更多负例只看成无关紧要的加速参数。
构造语料中“咖啡—喝”为真实词对。若负例大多是极少见的专名,模型容易把真对与噪声区分,未必学会区分“咖啡—喝”和“咖啡—购买”这类更细关系。若负例集中为过于常见词,又会改变被强调的判别边界。负例不是纯粹计算附件,而是目标的一部分。
区分一次负例抽样与负例期望目标
在式中的期望训练实现里,某次只抽到噪声词甲,不代表词乙永远没有排斥梯度;乙在多次更新中的出现频率由噪声分布决定。若把同一正例的负例数从5改为10,且逐项求和不改权重,负例期望贡献也翻倍。要做“仅增加估计精度”的对照,就必须另定义归一化目标,不能假定原算法自然保持同一个最优点。
教法联系:Jay Alammar的The Illustrated Word2vec。算例为本文自构。
三、把短语合并、下采样与负例抽样分开执行
输入:词序列、词频、短语阈值、负样本数 k
根据局部共现统计识别并合并候选短语
构建词表与负例分布 P_n
遍历语料:
    按词频规则跳过部分高频词
    为中心词和窗口邻词构造真实训练对
    对每个真实词对抽取 k 个噪声词
    最大化真实对 log-sigmoid 与噪声对负向 log-sigmoid
    更新参与本次计算的输入、输出向量
导出表示,分别评价词关系和短语关系
目标函数改变、训练分布改变、词表改变,是三条独立的信息路径。若三者一起启用后成绩提高,不能仅凭一个总分判断哪个是主要原因,应阅读对应消融与交互比较。
四、逐块读负例数与下采样的交互结果
现在按开关拆开表1与表3:负例更多是否值得,以及下采样会不会改变输出方法的排名。
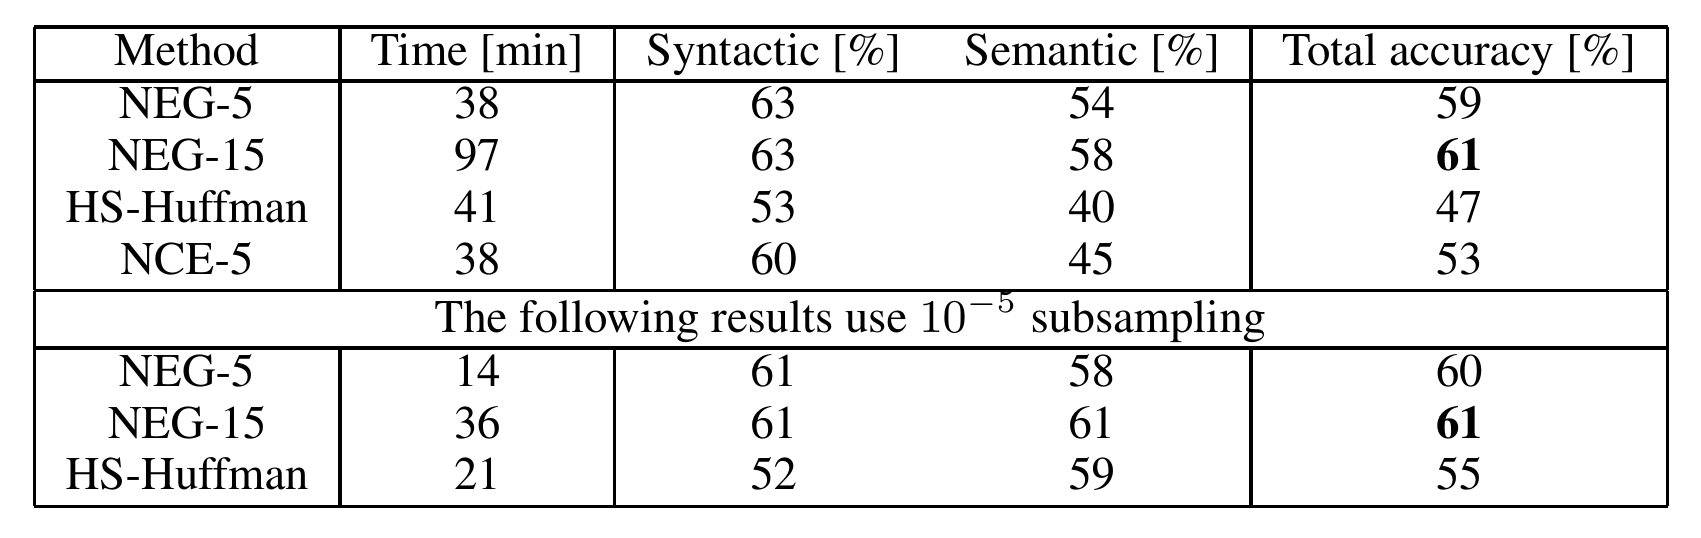
表1值得拆开读。 不下采样时,NEG-5 与 NEG-15 的总类比准确率为59%与61%,耗时38与97分钟;加上下采样后分别为60%与61%,耗时14与36分钟。增加负例与改变输入分布是两项干预;不能用最终一行把收益全算作负采样本身。
| 项目 | 论文范围 |
|---|---|
| 基础语料 | 新闻文本配置,部分实验约十亿词;大规模配置另行扩大 |
| 输出对照 | Hierarchical Softmax、Negative Sampling、NCE 等 |
| 关键变量 | 负例数量、频繁词下采样、词或短语单位、数据规模 |
| 指标 | 词类比和短语类比准确率,以及训练效率 |
| 展示 | 短语近邻与向量加法例子,用于解释而非代替统计 |
| 不确定性 | 未提供覆盖所有配置的现代多种子置信区间体系 |
证据一,第 2 节与表1。负采样及下采样的定义配合词类比比较,说明廉价目标仍可学习有用表示。但这并没有证明与完整 softmax 相同的概率拟合质量。
读表1先看上下两块。 下半块启用了高频词下采样,上半块没有;在同一方法的两行之间比较,才看得出样本选择的影响。第二列是分钟,后三列是语法、语义和总类比准确率。增加负例数要同时查看准确率与耗时,不能把NEG-15的总分单独当作免费提升。
证据二,表3。短语类比中,NEG-15 从无下采样的 27% 到下采样的 42%;层次 softmax 从 19% 到 47%。这些是该表具体设置下的结果,展示下采样与输出方法的相互作用。不能只摘“负采样有效”而忽略另一方法在组合配置中更高。
证据三,第 4.1 节及表4、表5。作者进一步改变数据量、维度和上下文,并给出短语近邻与组合示例。展示说明向量承载了部分结构信息,但多项配置同时变化,无法仅归因于数据量或某个单独技巧。
评估还受词表覆盖影响。若某方法没有一个测试短语,是算错、跳过还是限定共同词表,会影响分数。比较词表示时,这种数据接口细节与网络公式同样重要。
五、代理判别的几何不等于校准概率或世界事实
再想象一个真实但罕见搭配恰好被抽成负例。这不意味着训练立即矛盾到无法进行:目标是在统计上区分数据和噪声,抽样过程允许局部冲突。但它提醒我们,单次“负样本”不是人工确认的错误知识,不能将负采样标签解释成世界事实。
向量加法也应这样理解。两个词的向量相加可能汇集共同上下文方向,得到相关概念,但没有机制保证逻辑合取、数值计算或事实关系都被准确执行。漂亮的几何例子可以启发机制分析,不能代替逻辑正确性的证明。
它提供的可迁移研究原则是,把计算资源集中到更有区分度的训练信号,并明确代理任务与最终用途的联系。
局限包括对噪声分布与窗口的依赖、静态词义混合、短语阈值误差和数据偏差。高效率让更多数据可用,但若新数据重复、偏斜或污染评价集,也不会自动提供更可靠的语义。
六、把本篇机制再推进一步
1. 负例数翻倍却保持相同训练词数,是纯粹多花计算吗?
参考答案:不是。正文的独立点积推导给出数据计数与负例期望计数之比;负例期望改变时,最优点积也改变。比较时既要报告计算量,也要承认判别目标的权重变了。有限维共享向量还会使各词对相互约束,所以不能把标量驻点当作每个真实词向量都精确满足的公式。
七、从噪声对比转向全局共现拟合
噪声分布决定点积的参照系;GloVe从共现比例构造另一种统计目标。若问题转为未登录词,读fastText检查子词参数共享,增加负例并不能补出不存在的整词行。
自测与参考答案
1. 负采样是否就是用少量词精确估计 softmax 梯度?
不是。它使用真实搭配与噪声搭配的判别目标,通常不等于完整 softmax 的无偏梯度估计。目标由噪声分布和负例数量共同定义,因此训练出的点积不能直接当作归一化语言概率。
2. 为什么减少高频词样本可能同时加快训练、提高类比准确率?
常见词占据大量更新,包含的信息可能重复。下采样释放预算,并改变语义相关搭配在训练中的相对影响。但它也改变数据分布,效果依任务而定,不能理解成对所有任务都无损压缩。
3. 表3 是否支持“负采样在任何条件下都优于层次 softmax”?
不支持。该表显示方法排序随下采样配置变化。更准确的结论是输出目标、样本选择和短语任务存在交互,比较时必须保留完整设置,而非给算法贴永久优劣标签。