009|Adam:同时估计梯度方向与每个参数的更新尺度
论文:Diederik P. Kingma、Jimmy Ba,Adam: A Method for Stochastic Optimization,2014 年预印本、ICLR 2015。原文 · PDF。以下以算法 1 和第 6 节实验为主。Adam 是优化器,不是一种语言模型;将其列入主线,是因为训练算法决定了大模型能否有效利用数据与计算。
先接住前作的问题
NNLM与GloVe都把表示学习写成可微损失,但目标确定后仍要处理随机梯度的方向波动与不同坐标尺度。本篇讨论可组合的优化模块,而不是继续改造词表示结构;后来的Transformer才把 Adam 和自己的学习率计划组合使用。
五个前置概念
五个前置概念是随机梯度、指数滑动平均、未中心化二阶矩、坐标缩放和训练—验证区分。能解释这五项,才算理解了优化器正在保存什么、更新什么,以及曲线能够证明什么。
一、问题设定:一个学习率怎样兼顾方向噪声与坐标尺度
不同参数的梯度频率与尺度可能差别很大,小批量梯度 的方向还可能在相邻 batch 反转。直接使用当前梯度会摆动,只平滑方向又未必解决统一步长难兼顾各坐标的问题;本篇同时维护方向与平方尺度的滑动统计,再处理它们从零开始的偏差。
自适应方法利用过去梯度大小调整各坐标更新。这里的“自适应”指特定统计规则,不是优化器理解了任务语义。它看见的是梯度,而不是模型哪些参数代表事实、句法或推理。数据分布变化与极端梯度仍可能让历史统计暂时不合适。
另外,优化速度与泛化是不同指标。更快降低训练损失,可能提高固定预算下表现,也可能更快拟合噪声。需要把训练曲线、验证表现与计算资源分别报告,不能将“收敛快”当作所有意义的“模型更好”。
二、展开矩估计,推导零初始化的偏差修正
是一阶矩估计, 是未中心化二阶矩估计,平方按坐标进行。二阶矩不是方差:方差还需要减去均值平方。 控制遗忘速度,越接近一,历史影响越长。
由于二者从零开始,早期估计偏小。算法采用:
是基础学习率, 避免分母过小。修正针对零初始化的指数平均偏差,不是让非平稳训练中的全部统计误差消失。学习率计划、梯度裁剪与正则化仍是另行指定的选择。
分母按坐标缩放,使历史上梯度较大的坐标获得较小的有效比例。但分子也受历史与方向抵消影响,所以不能只看 断言某个参数一定更新更大。更不能把 当作完整曲率逆矩阵,它不包含一般的跨参数相关项。
偏差修正从几何级数得到
设 为第 步梯度, 为零初始化的一阶矩估计, 为衰减系数。展开递推,。若各步梯度期望近似同为 ,则 ;除以括号才补回因零初始化缺失的总权重。对平方梯度同理。若真实期望随时间变化,修正后只是一个归一化的历史加权平均,不会变成当前梯度期望的无偏预言。这是“修正初始化偏差”比“消除估计偏差”准确的原因。
构造一个标量梯度 ,取 、。从零开始得到 、;修正后 、。忽略很小的 ,第一步更新约为 。
若去掉修正,比例约为 ,并不是同样一步。这个自构例子解释为何两个看似“只是除个系数”的步骤会影响早期稳定性。它不意味着之后更新总是符号梯度,因为历史方向与大小会不断变化。
接着算第二步。 沿用 ,令 ,则 、,修正后 、。第二步更新为约 ,远小于单看当前梯度得到的 。动量抵消抑制来回震荡,也说明Adam不是逐步把梯度变成符号。
第一次更新怎样受epsilon影响
偏差修正后,第一步的一阶量等于当前梯度,二阶量等于其平方。若忽略epsilon,非零标量梯度的更新近似只取正负号;梯度极小时epsilon不可忽略,步长会缩小。由此做实现检查应同时测试普通梯度、接近零的梯度和全零梯度,不能只用大数样例验证偏差修正。
三、连同矩状态和步数保存完整更新过程
输入:参数 theta、可微随机损失、alpha、beta1、beta2、epsilon
m ← 0; v ← 0; t ← 0
重复训练:
    t ← t + 1
    g ← 当前小批量损失对 theta 的梯度
    m ← beta1*m + (1-beta1)*g
    v ← beta2*v + (1-beta2)*(g*g)
    m_hat ← m/(1-beta1^t)
    v_hat ← v/(1-beta2^t)
    theta ← theta - alpha*m_hat/(sqrt(v_hat)+epsilon)
输出:优化后的参数及可用于恢复训练的矩状态
检查点必须保存矩状态和步数,才能忠实恢复同一优化轨迹。只保存模型权重再重启,会重新经历早期统计阶段。Adam 的额外内存也正来自每个参数对应的状态,这与后面的 ZeRO 分片问题直接相连。
四、按相同调参条件比较损失与墙钟时间
恢复轨迹与单步成本明确后,再比较同样初始化和调参预算下的训练进展。
| 项目 | 原文第 6 节 |
|---|---|
| 凸任务 | MNIST 多类逻辑回归、IMDB 稀疏词袋逻辑回归 |
| 非凸任务 | MNIST 多层网络和 CIFAR-10 卷积网络 |
| 基线 | 动量 SGD、Adagrad、RMSProp、AdaDelta 或 SFO,按实验分别列出 |
| 初始化 | 比较优化器时使用相同参数初始化 |
| 调参 | 密集网格搜索后报告最佳超参数设置,并非所有方法只用默认值 |
| 指标 | 训练目标随数据遍历次数变化,部分同时比较墙钟时间 |
| 理论边界 | 原文明确其分析不直接适用于非凸网络实验 |
证据一,算法 1 与第 2—3 节。给出矩估计和偏差修正,明确实现机制。参数默认值是实践建议,不能被解释为所有训练任务都无需选择超参数。
证据二,图1。逻辑回归比较涉及密集与稀疏特征,说明不同梯度结构下方法关系并不相同。这些图的横轴是迭代或遍历数据次数,纵轴是训练负对数似然或训练代价。下降更快首先表示优化更快,不能直接读成测试准确率或泛化提高。
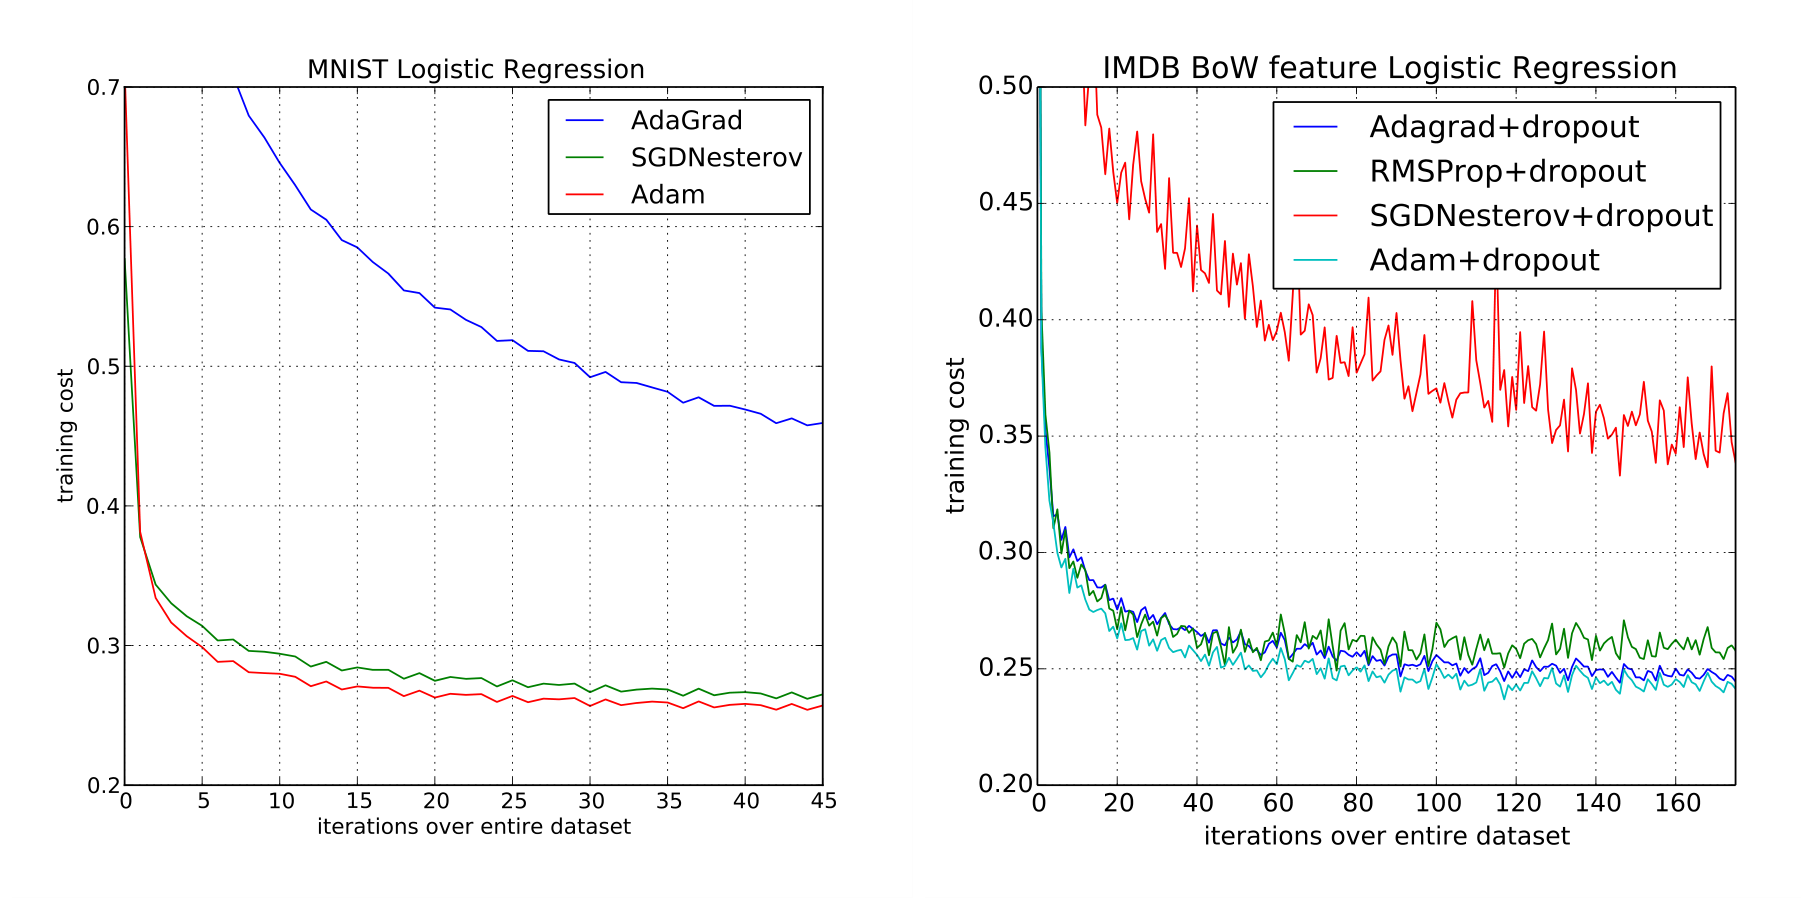
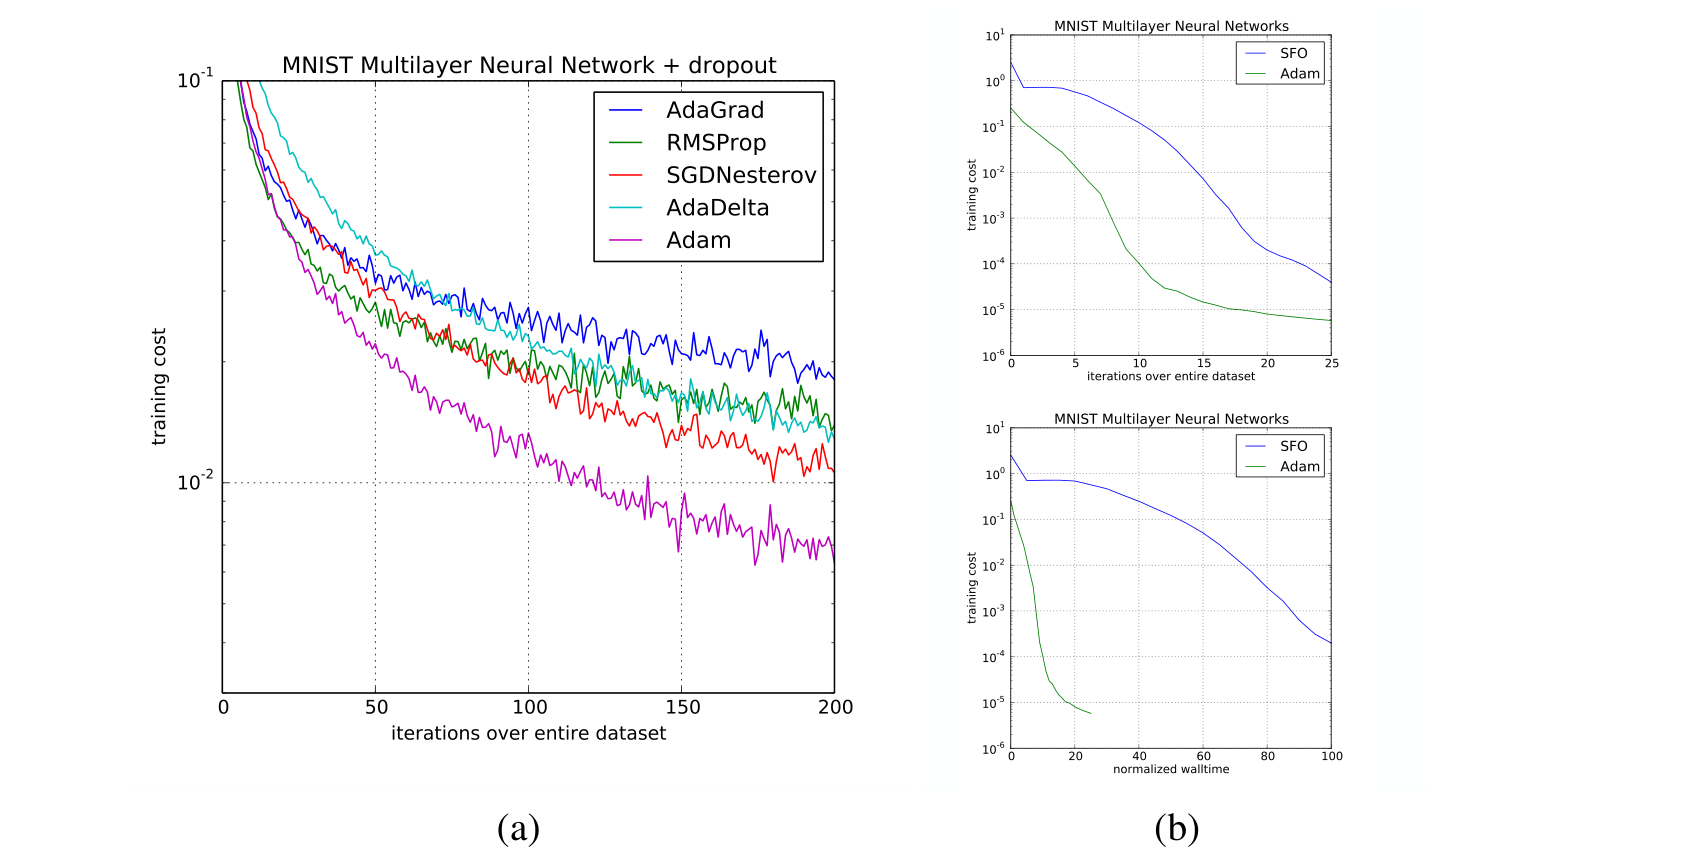
证据三,图2、图3。全连接和卷积实验观察非凸优化,在图2 的相关比较中还讨论每次迭代成本。训练进度与时间同时呈现,是区分“更新次数少”和“实际更快”的必要步骤,但这些硬件条件不能直接映射到今天的大语言模型。
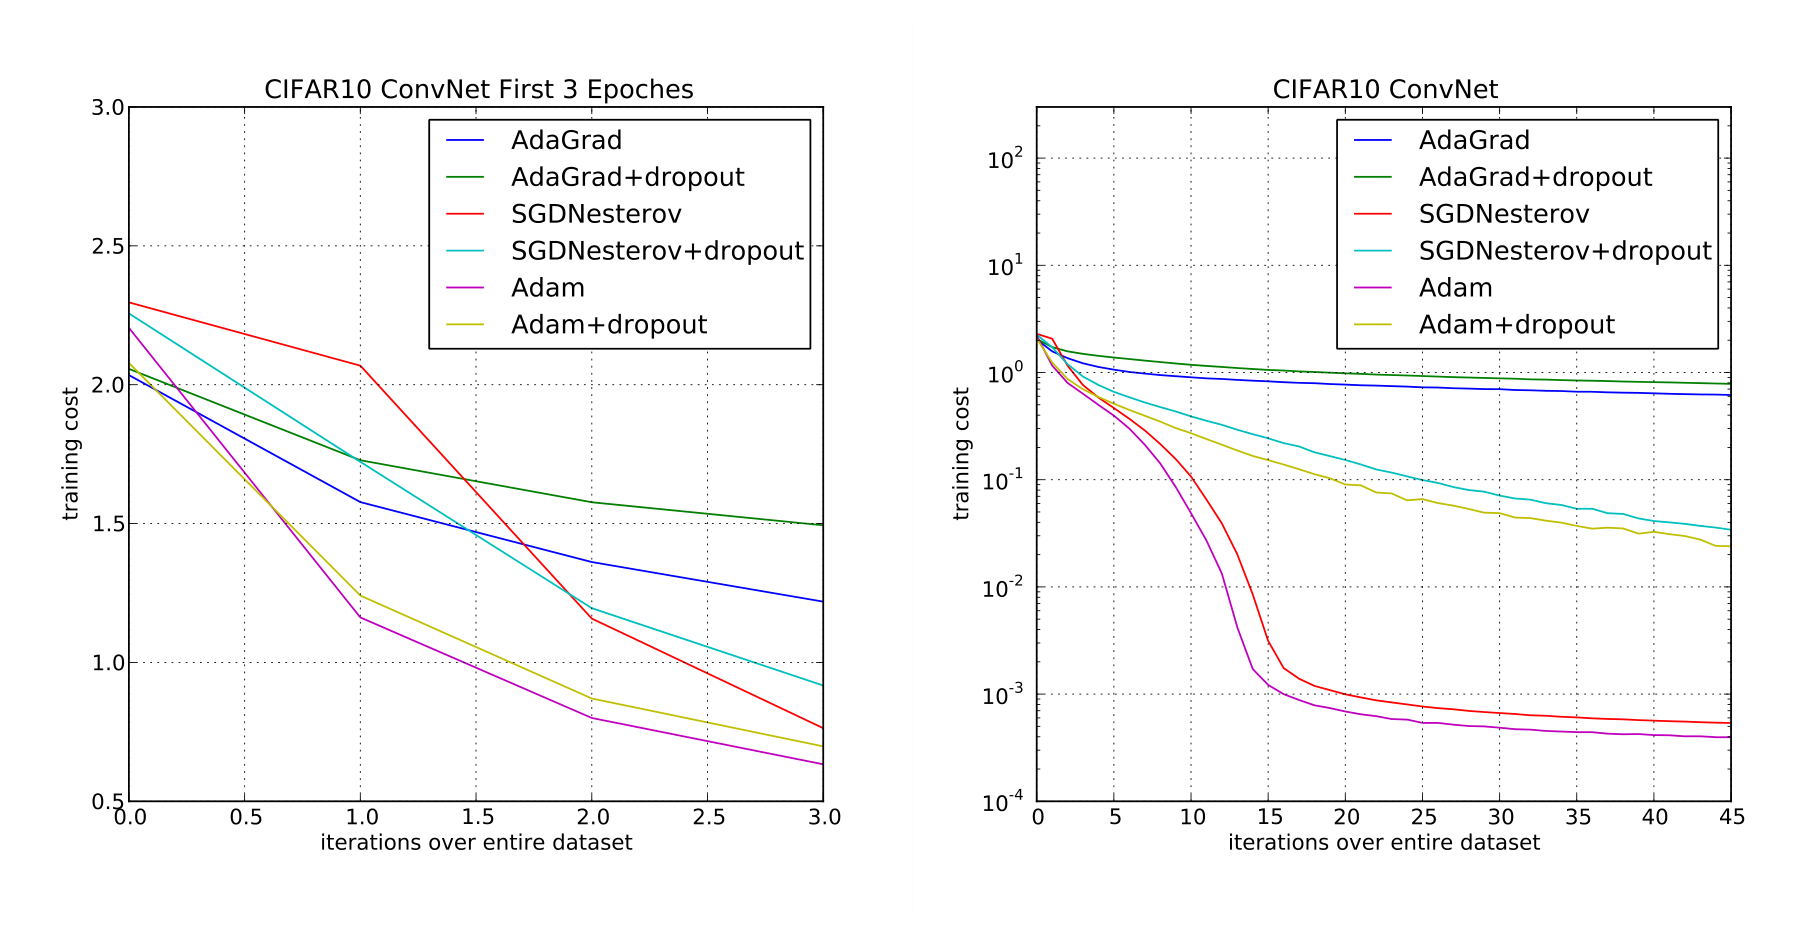
读图2的三个面板。 左侧在带dropout的网络上按遍历整份数据的次数比较训练损失,纵轴是对数刻度;右侧另做Adam与SFO的比较,上面按数据遍历次数,下面按归一化墙钟时间。要判断实际速度,应在同一个右侧面板里比较达到相同损失的位置,不能把不同网络设置的曲线拼成一次排名。
算法论文的常见误读是忽略调参预算。如果新方法被精细搜索,而对照只用一个不合适学习率,结果无法说明更新规则更好。原文说明进行了超参数搜索,阅读时应把这点保留,而不是将曲线误称为零调参比较。
五、更快优化不提供无条件收敛或泛化保证
再设接下来梯度突然变为相反方向。 不会立即翻转,历史惯性可以过滤偶发噪声,也可能拖慢对真实分布变化的响应。滑动统计的收益与延迟是同一个机制的两面。
每步按参数线性计算,易于大规模实现;代价是额外矩状态、超参数及与精度、正则化、学习率计划的交互。
本篇不把 Adam 与 AdamW 混同:在自适应缩放下,把 L2 项加进梯度与直接按比例衰减权重通常不是同一个操作。若实现使用解耦权重衰减,应明确它是后续变体,而非原算法 1 的所有配置天然如此。
外部后续研究补充:Reddi、Kale、Kumar 的 On the Convergence of Adam and Beyond(ICLR 2018,2019年存档)明确给出Adam在简单凸优化中不收敛的反例,并指出原收敛分析的问题。因此限制并非仅存在于深度网络的非凸场景。此处核对其原始摘要所陈述的结论,未在本文展开反例推导;这不否定Adam的经验价值,但排除了无条件的收敛保证。
六、把本篇机制再推进一步
1. 把训练分成两段但只将第二段的步数归零,会发生什么?
参考答案:偏差修正分母会与已经积累的一阶、二阶矩不再匹配,更新不再等价于不中断轨迹,也不等价于完整重置优化器。忠实恢复要同时恢复参数、两个矩和步数;若研究重启策略,应明确哪些状态重置,并将其当作不同训练协议。
七、将更新规则接入模型,再分片存储状态
状态恢复和逐参数矩缓存还会影响大模型训练。Transformer给出优化器与调度的模块组合,ZeRO再追问这些训练状态由谁保存;二者都不改变Adam原本的统计量定义。
自测与参考答案
1. 为什么不能直接叫梯度方差?
它平均的是 ,属于未中心化二阶矩。方差还要减去均值的平方。这个区别影响对分母的解释:Adam 并不只是根据梯度“噪声大小”调节步长。
2. 恢复训练只加载权重,会与不中断训练相同吗?
通常不同。矩估计和步数决定下一次更新,丢失它们会改变有效方向与尺度。若刻意重置优化器,可以是一种实验策略,但应明确记录,而不是声称完全恢复。
3. 训练损失下降更快,是否证明最终测试泛化更强?
不能。它证明特定训练目标被更快优化。还需比较相同数据、调参和计算预算下的验证及测试指标;更快拟合也可能包括更快拟合噪声。