010|知识蒸馏:让学生学习教师的概率关系,而不只复制答案
论文:Geoffrey Hinton、Oriol Vinyals、Jeff Dean,Distilling the Knowledge in a Neural Network,2015。原文 · PDF。本文以温度软目标、MNIST 和语音实验为主;语言模型中的序列蒸馏是后续应用,不把它与原论文分类蒸馏混为一谈。
先接住前作的问题
RNNLM的模型组合展示了互补预测信息,却留下部署时运行多个模型的代价。本篇借这个共同问题切到分类蒸馏:能否把教师的概率关系交给一个便宜学生?这是系统问题的教学联系,原论文实验以 MNIST 与语音为主,并非对 RNNLM 架构的直接修改。
五个前置概念
理解本篇需要掌握 logits、温度、交叉熵、教师冻结与模型容量。它们分别对应分布前的分数、平滑尺度、匹配目标、监督来源和可表达信息上限。能把这五项讲清楚,才不会把蒸馏理解成简单“抄答案”。
一、问题设定:便宜学生怎样接收集成模型的类别混淆结构
多个模型集成能平均部分个体误差,却要求推理时运行多个网络。若教师把数字3判得最像3、同时更容易与8而非1混淆,只给学生硬标签会抹去这层关系。本篇问的是:一个较小学生能否从完整软分布学到集成决策结构,并把主要成本留在训练阶段?
迁移数据可以有标签,也可以仅由输入与教师软输出构成。有硬标签时,可以同时保留真实监督,防止完全跟随教师错误。使用未标注数据并不意味着没有监督来源,教师训练所用的知识与资源仍然存在。
二、从温度分布推导软硬目标与梯度尺度
教师 logits 为 ,学生 logits 为 ,温度为 :
教学损失可以写成:
是交叉熵, 是真实硬标签, 控制软硬监督的权重。教师通常冻结,学生更新;软目标双方使用相同温度,普通预测时再回到温度 1。若无硬标签,可只保留软目标项。
补偿温度增大带来的梯度尺度变化,使调温度时两项相对影响不至于无意大幅改变。它不是关于信息量的神秘常数,而是由 softmax 梯度近似推导出的尺度修正。
高温极限下,在逐样本 logits 做适当中心化等条件下,分布匹配与 logits 差的平方拟合相关。条件非常重要:softmax 对所有 logits 同加常数不敏感,直接无条件声称“蒸馏等价于 MSE”并不准确。
温度平方不是额外知识,而是链式法则
令学生logit为 ,教师为 。这里 分别为同一温度 下的教师、学生分布, 是类别数,横线表示对所有类别求平均。软交叉熵梯度是 ;当温度远大于logit尺度时,。两分布相减再除一次温度,得到梯度约为 。乘 才保持高温近似中的尺度。中心化不可省略,因为将所有logit同加常数并不改变softmax。
教学反例。 教师logit为 ,学生为 。两者任何相同温度下的概率完全一致,蒸馏交叉熵梯度为零;直接计算未中心化MSE却得到每维100的平方误差。若另一个学生为 ,虽然第一类仍是答案,概率关系并未匹配。蒸馏学的是分布形状,既不要求绝对logit相等,也不等于只模仿最高类。
构造三类问题,硬标签为第一类。两个教师分布分别为 和 ,最高概率和硬答案相同,但混淆结构不同。学生只学硬标签无法区分二者,拟合软目标则会受到不同梯度影响。
把学生的一步梯度接到非最高类
温度设为1、学生暂时给三类各三分之一概率。对正文的两个教师,第二类梯度分别为1/3−0.09和1/3−0.01,下降方向相同而力度不同;第三类恰好交换。硬标签训练会对两类给相同梯度,软目标才保留“哪一种错误更像”的区别。教师若判断失真,这个差异也会被传给学生。
教法联系:Lilian Weng的Large Transformer Model Inference Optimization。算例为本文自构。
三、冻结教师,分别记录迁移训练和学生部署成本
输入:冻结教师或教师集成、迁移输入、可选硬标签
初始化学生参数
重复训练:
    teacher_logits ← 教师对输入的预测(不更新教师)
    student_logits ← 学生预测
    soft_teacher ← softmax(teacher_logits / temperature)
    soft_student ← softmax(student_logits / temperature)
    loss_soft ← temperature^2 * CE(soft_teacher, soft_student)
    若有真实标签,加入温度1下的硬标签交叉熵
    更新学生参数
部署:仅运行学生,使用约定的正常预测温度
四、对照 MNIST、语音指标与迁移集覆盖条件
学生模型大小、单次推理成本和总训练成本是不同量,不能用一个“压缩率”替代全部。
输出分布匹配是否有效,要同时看教师、硬标签学生和蒸馏学生;特殊测试集调偏置条件不能省略。
一个需要保留的实验条件。 §3删除迁移集中的数字3后,再提高该类输出偏置得到更好成绩,偏置值是在测试集上优化的。因此这项探针可以说明软目标传递跨类别信息,却不能把调整后的数字当成严格未触及测试标签的部署泛化成绩。
| 项目 | 原文设置 |
|---|---|
| MNIST | 大教师与较小学生,比较硬标签和软目标训练 |
| 语音 | 强声学基线、10 模型集成及蒸馏单模型 |
| 数据 | 语音实验约 2000 小时英语,约 700M 训练样本;不是只有少量玩具数据 |
| 指标 | 测试错误、帧分类准确率和词错误率 |
| 变量 | 温度、学生容量、软硬目标权重、迁移集覆盖 |
| 成本 | 推理可使用单学生,但教师和软目标生成成本必须保留 |
| 重复 | 独立教师用于集成,不等同于每个学生配置有完整置信区间 |
证据一,第 2 节与第 2.1 节。温度分布、梯度尺度和高温近似说明机制。它们支持为何软目标可提供不同监督,不证明温度越高越好。
证据二,第 3 节 MNIST。文中教师有 67 个测试错误,较小硬标签模型为 146,蒸馏学生为 74。学生结构与正则方式具有具体设置,因此这一结果说明有效转移,不能直接概括为任意小模型都能达到教师性能。
证据三,表1 语音结果。基线帧准确率 58.9%、WER 10.9%;10 模型集成为 61.1%、10.7%;蒸馏单模型为 60.8%、10.7%。帧指标改善更明显,WER 的变化较小,说明代理训练目标与最终系统指标并不一一对应。
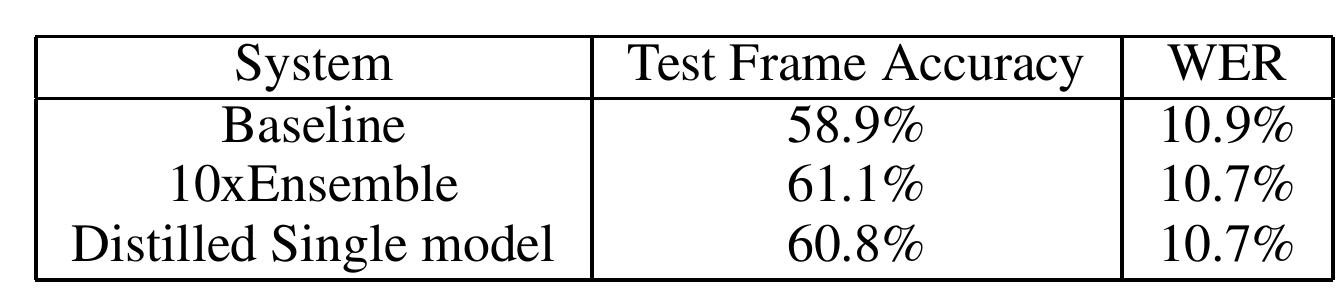
表5 进一步讨论减少学生迁移数据时的软目标价值,但教师使用过更完整训练数据。若只说“学生用 3% 数据就接近全数据表现”,却不说明软标签来自全数据教师,就会把知识来源从成本账本中抹去。
五、学生容量和教师错误限制了转移内容
如果第二类确实与第一类在输入特征上相近,这种结构可能帮助泛化;如果教师只是系统性混淆某个人群或罕见模式,学生也可能继承错误。软监督更丰富,不等于所有丰富信息都正确。
再让学生只有极低容量,无法同时表达教师所有细节。它必须选择拟合哪些模式,温度便影响哪些概率差异更受重视。论文观察到容量与合适温度有关,这与“知识完整装进更小模型”的无损压缩想象不同。
代价是教师成本、迁移数据覆盖以及容量限制;作者关于 specialist 集成的进一步讨论也不是今天稀疏 MoE 的同义词。
六、把本篇机制再推进一步
1. 两个教师硬预测相同但次高类别不同,是否能用同一份硬标签蒸馏重现它们?
参考答案:不能重现这种差异。硬标签丢掉非最高类别的相对概率,而软目标会给学生不同梯度。若接口只返回文本或类别,就无法假装获得完整分布监督;后续采用生成答案的蒸馏可以有用,但应单独说明它保留和丢失的信息。
七、从分类分布匹配走向语言模型轨迹监督
学生节省的是部署资源,教师与迁移数据仍有前期成本。用Switch Transformer的稀疏教师蒸馏继续核对“教师增益保留比例”;用QLoRA比较另一种压缩与适配组合,勿把两类成本混成一个压缩率。
自测与参考答案
1. 为什么软目标可能比硬标签提供更多训练信息?
它同时描述非最高类别之间的相对关系,同样硬答案的输入可以有不同混淆结构。学生由此获得更多梯度约束。但信息来自教师,错误关系也可能传递,所以丰富不等于正确。
2. 为什么改变温度时需要关注 ?
温度影响概率差异和对 logits 的导数,软目标梯度在相应近似下随 缩放。乘回该因子有助于保持与硬标签项的相对尺度,否则调温度同时偷偷改变了损失权重。
3. 学生只用少量迁移数据,能否宣称整个方法只需这么多数据?
不能。教师可能已经使用大量数据,学生通过软标签继承其中信息。应分别列教师训练数据、迁移输入和学生训练预算;部署成本降低并不消除上游知识获取成本。