011|BPE 子词翻译:有限词表怎样生成没见过的词
论文:Rico Sennrich、Barry Haddow、Alexandra Birch,Neural Machine Translation of Rare Words with Subword Units,2015 年预印本、ACL 2016。原文 · PDF。讨论的是将压缩算法 BPE 适配为子词分割,而不是声称本文发明了 BPE 压缩,也不是现代所有 byte-level tokenizer 的统一说明。
图表来源:Rico Sennrich、Barry Haddow、Alexandra Birch,2015,原文;CC BY 4.0。本篇展示做了图形区域裁切,图中数据与标签未改动。
先接住前作的问题
Seq2Seq与注意力翻译改善了条件生成和源信息读取,但有限整词词表仍让模型无法输出某些新名字与变形。本篇组合带注意力的循环翻译骨干,修改输入输出符号接口;它解决可表示性,不直接重做对齐机制。
五个前置概念
五个前置概念是词表、OOV、字符组合、贪心合并与可逆解码。理解这些就能进一步比较 BPE、字节级编码与其他分词目标,而不会只凭“使用 BPE”推断完全相同的输入分布。
一、问题设定:遇到新名字时,翻译器能否避免把它整个变成UNK
新名字可能要复制或音译,复合词要组合翻译,词缀变化又需要共享词根。把整词替换成UNK会丢掉内部结构;扩大词表虽能覆盖更多已见词,却增加输出层,也覆盖不了未来所有构词。问题是能否让陌生词由已知片段组成,并交给翻译网络学习其用法。
纯字符模型具有更强覆盖,但每个词被拆成许多步骤,学习距离与计算增加。子词处于单词和字符之间:频繁组合成为较长单位,罕见表达回退为更细片段。因此词表大小与序列长度形成实际取舍,而不是越细或越粗都更好。
本论文使用带注意力的循环翻译模型,分词是其输入输出接口。数学上的翻译似然目标并未因为 BPE 自动改变为语义监督;改变的是 token 序列、词表和模型可以生成的组合空间。
二、按频率学习有序合并,而不是寻找语言学词素
先把训练词拆成字符并标记词边界,统计相邻符号对在语料中的频率。每一步选择最常见对,把其合并为一个新符号,重复预定次数。合并规则形成有序列表;处理新词时按同一规则应用,剩余部分保留为更小单位。
可以把一次规则选择写成:
是训练词频, 是当前分割中相邻对出现次数。这里优化的是局部频率贪心选择,不是通过翻译损失端到端学出的最优词表。合并步数控制粒度,但同样步数在不同语料上会形成不同片段。
论文还比较分别学习与联合学习源目标分割。联合规则可以让共享字形获得更一致的切分,但字母表和语言差异会影响适用性。它不意味着两个语言的同形片段一定同义,也不保证每种测试字符都已经被训练词表覆盖。
合并次序是模型的一部分
BPE 学习的是有顺序的替换规则,而不是一个任意可重排的子串词典。每轮先按词频累计当前符号对,再合并频次最高的一对,下一轮必须重新计数,因为候选对已改变。应用到新词时复用训练得到的规则顺序;不能在测试文本上重新学习最频繁对,否则分词器及词表定义就变了。原文算法1中的频次加权,是区别“某种拼写出现几种”与“语料实际出现几次”的关键。
原创教学轨迹。 词表有 ab×5、ac×2,均附结束符。初始对 a,b 计5次,a,c计2次;若并列时先选a,b,则ab整体变成一个符号,之后的候选是ab与结束符,而非再独立统计a,b。新词abc可沿已学规则切为ab、c、结束符。它可被编码不代表翻译器理解其词义;分词解决的是可表示性,语义泛化仍要靠模型学习。
构造训练词“play”“played”“playing”。若规则形成“play”和常见词尾,新组合可能继续拆成这些共享单位。模型能够通过已知部分处理一个较少出现的形态,而不必为每种变化单独学习完整词向量。
用合并排名处理同一串字符
设词内字符为a、b、c,已学规则先合并a+b,再合并b+c。处理abc时应先得到ab、c,第二规则已经没有相邻的b、c可合;若反过来就得到a、bc。两者长度相同而token身份不同,因此只测试输出token数不能验证分词器一致,必须保存合并排名及词边界约定。
三、固定分词、边界标记和解码规则
输入:带词频的训练词表、合并次数 M
将每个词表示为字符序列与词尾标记
规则表 ← 空
重复 M 次:
    统计当前所有相邻符号对的加权频率
    选最高频对 (a,b)
    在词内将 (a,b) 合并为新符号 ab
    将该规则追加到有序规则表
用规则表切分训练、验证和测试文本
训练子词翻译模型;生成后按边界规则拼回词
输出:固定子词表、确定的编码解码规则与翻译模型
词边界规则是可逆重建的重要部分。若把训练时使用的边界标记丢掉,输出片段可能无法正确恢复空格或单词。分词器并非只有一个词表文件,还包含规范化、规则顺序和解码约定。
四、同时比较稀有词、OOV、词表与序列长度
分割改变了模型实际看到的序列,所以不能只看总BLEU,必须把覆盖与长度成本一起读。
| 项目 | 原文范围 |
|---|---|
| 任务 | WMT 2015 英语到德语、英语到俄语 |
| 对照 | 单词模型 UNK、词典回退、字符 n-gram 与 BPE 子词方案 |
| 数据处理 | 比较词表大小、token 数量和未知项,另列联合 BPE |
| 指标 | BLEU、CHRF3、全部词及稀有/OOV 词的 unigram F1 |
| 集成 | 单模型与 8 模型集成分列,不混为同一预算 |
| 随机性 | 表格不是完整多种子分布;集成数量不等于统计重复次数 |
证据一,第 3 节与分割算法。说明不同未知词类别为什么可能由较小单位处理,并给出 BPE 适配。它支持构词机制的动机,不保证任意分割都语义透明。
证据二,表1。德语语料在不分割、字符、BPE 等方案下的 token 与类型数明显不同。它直接显示词表压缩和序列增长的取舍;不能只取“词表更小”而不计算序列长度带来的成本。
证据三,表2、表3。英德表中,集成条件下稀有词 F1 从词典回退的 36.8% 到联合 BPE 的 41.8%;但 OOV 子项并非所有子词方案都更高。整体改善与每个细分指标改善不是同一结论。
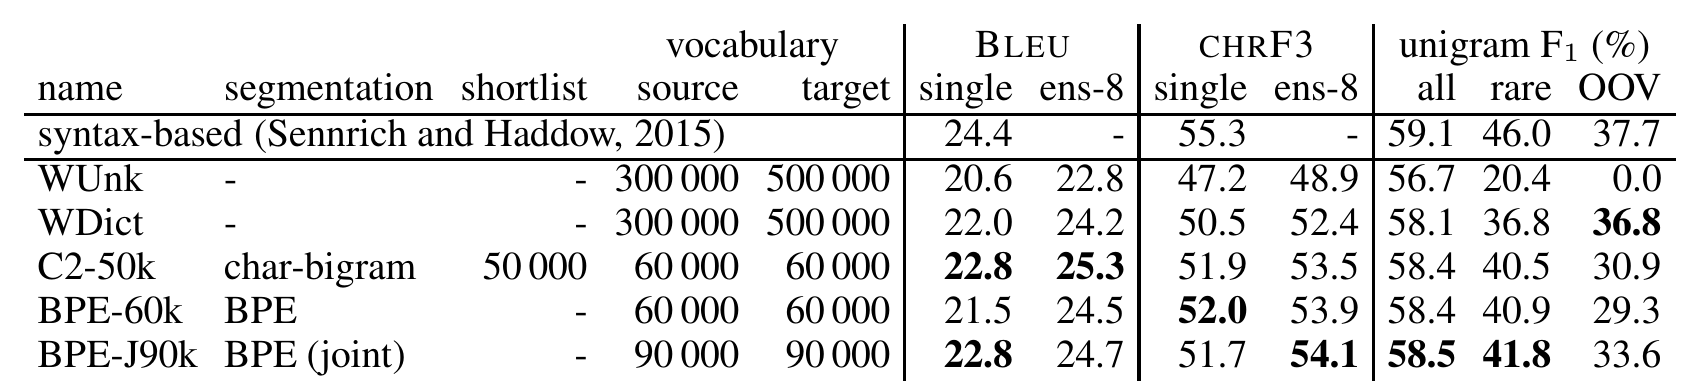
这类实验应特别关注“rare”和“OOV”的定义。稀有可以指不在最常见五万词中,OOV 则可能指训练集中从未出现,两者难度不同。分词后能够表示一个 OOV 词,只说明输出空间允许它,不能证明它的训练语义已被获得。
再考虑一串随机序列号。字符层覆盖让系统可以输出它,但 token 分割方式可能使精确复制变难。对需要逐字符精确性的任务,应另外测量复制正确率与长度,而不是仅用自然语言 BLEU 判断分词好坏。
词表较小会减少某些嵌入和输出计算,却可能产生更多解码步骤。对自回归系统,步骤数量直接影响延迟;对注意力系统,序列长度还影响交互成本。因此两个 tokenizer 的比较应固定文本内容,再报告 token 数、覆盖、训练与推理开销,而非只匹配“相同 token 数”。
跨语言场景更需要小心。同一字数的两种语言,可能因训练语料比例不同得到截然不同的 token 长度。这样一来,相同上下文窗口能容纳的信息量也不同。这个分析是从分词接口推导的后续含义,不是原论文已经完整测量的现代多语言结论。
五、可编码的新词仍可能难理解、复制或翻译
但 BPE 是频率合并,不是词素分析器。一个片段可能跨越人类认为的语义边界,甚至只是拼写上的常见组合。只要模型有足够数据,它仍可学习这些单位的作用;若数据很少,错误分割可能增加学习负担。这就是“可编码”和“易学习”的差别。
限制包括新字符、规则语料偏差、非语义分割和更长序列。它处理的是表示单位,不是事实知识、推理或译文忠实性本身。
六、把本篇机制再推进一步
1. 相同原文在两种分词器下token数不同,固定token预算是否公平?
参考答案:它固定了计算单位,却未固定看到的文本量。更细切分的模型可能读到更少原文,也会产生更多解码步骤;应同时报告原始文本量、token数量、词表和实际成本。要比较分词本身,至少说明控制的是数据量还是计算预算,不能把两者混为一项。
七、区分子词向量共享与字节级分词
BPE解决可表示与序列长度,不保证同一子词在不同句子里有合适语义。对照fastText的片段求和,再到Transformer看切分后的token如何获得上下文化表示,三者是可组合模块。
自测与参考答案
1. BPE 能拆开新词,是否表示模型理解了新词?
不是。可表示意味着输入输出有合法符号序列;理解还依赖训练中是否学到这些片段的组合关系。新名字或随机串可以被编码,却可能被误译或复制错误。
2. 更小词表为什么不一定更快?
更小输出层可能节约计算,但更细分割增加序列与解码步数。最终成本取决于两者,以及具体架构和硬件。应按同样原始文本比较,而不只比较词表参数量。
3. 为什么训练与测试必须共享完全相同的分词规则?
模型的每个 token ID 对应训练时学到的含义。规则顺序、规范化或边界改变会导致不同序列甚至不可逆输出,相当于改变输入接口。只有词表名称相同并不足以保证兼容。