042 · Switch Transformer:每个词只选一个专家
返回目录 · 上一篇:The Pile · 下一篇:CLIP
论文:William Fedus、Barret Zoph、Noam Shazeer,Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity,2021年公开,JMLR 2022。原始论文。
先接住前作的问题
GShard让token最多走两个专家,但通信和调度仍复杂。本篇直接简化稀疏MoE路线,追问top-1是否能在质量与时间之间取得更好取舍;Mixtral后来仍用top-2,也说明选择数不是永久优劣排名。
五个前置概念
五个前置概念是:top-1选择一个专家,容量因子提供负载缓冲,辅助损失调节分配,混合精度兼顾稳定与效率,知识蒸馏把大模型信息迁移到学生。理解后再看现代MoE,才不会只比较总参数而忽略激活与路由。
一、问题设定:每token只用一个专家,能省掉哪些路由成本
沿用T5式缺失片段恢复时,部分前馈层可改成专家集合。这里不改文本目标,而把每token候选执行路径从最多两位缩为一位;需要同时回答路由如何得到梯度、容量不足怎样处理,以及节省通信是否真的转成达到目标质量的时间。
设专家数 ,路由概率为 ,选取:
门控概率仍乘在专家输出上,所以选中路径上的路由概率可以接收梯度;argmax本身不成为平滑可微操作。论文并未声称所有专家在每个token上都得到相同训练信号。
容量约为:
是相应路由批次的token数,是容量因子。多出的缓冲减少溢出,却增加填充计算、内存及通信。溢出token跳过专家支路,通过残差继续传递,不是从序列中消失。
二、推导top-1概率梯度和负载辅助项
设 为实际分配到专家 的token比例,为整批平均路由概率,辅助损失为:
通过可微的 促使路由减少拥挤。来自硬选择,不直接求导。原论文使用的相关设置;这是实验配方,不是通用最优常数。
选择性精度只在路由内部使用float32,输出分发与组合张量再转回bfloat16,避免跨设备传输全高精度张量。较小初始化尺度减轻训练早期不稳定。微调时则对专家使用更大的dropout,因为大量稀疏参数在小任务数据上容易过拟合。
top-1仍能训练路由概率
若输出为 ,其中 为输入, 为专家变换, 是路由概率, 是 argmax 选中的专家,任务梯度仍可经连续的 回到router;离散选择本身则不按普通导数传播。均衡项 中, 为辅助损失系数, 为专家数、 为专家 的实际分派频率、 为其 batch 平均概率;f通常视作不求导统计,P提供可微路径。若把top-1权重归一化为恒等于1又去掉其他梯度通路,机制便与原式不同。
教学算例。 两专家分派比例 、平均概率 ,除去系数α后的均衡项为 ;完全均衡时为1。该值给训练方向,不是每个batch都被硬性均分的保证;实际容量上限仍可能产生溢出。
只执行一个专家时检查路由是否被错误归一化
若选择到的专家概率为0.7,输出应保留这项门控系数。若实现把唯一入选项重新归一成1,输出不再随它的概率变化,这条连续路由梯度也会消失。Top-1的“只算一位专家”与“把门值强制为1”不是同一操作;辅助平衡梯度不能替代被误删的主任务路径。
教法联系:Lilian Weng的How to Train Really Large Models on Many GPUs?。算例为本文自构。
三、按敏感组件设置精度、容量与初始化
输入:token表示、专家集合、容量因子、平衡权重
    在float32中计算路由概率
    每个token选概率最高的一个专家
    计算实际负载和平均概率的辅助损失
    按专家容量截断分配,构建分发与组合张量
    将通信张量转为低精度,发送token到对应专家
    执行专家前馈,并乘路由概率合并回原位置
    接回残差;优化任务损失与辅助损失
微调时对专家层使用单独的dropout设置
输出:稀疏模型及逐专家负载统计
总参数随专家数增加,但每token激活的专家计算约保持不变。路由器仍需给更多专家评分,存储与通信也不会消失,所以“固定FLOPs”是近似的主要计算口径,不应理解成所有系统开销严格不变。
自构批次有100个token、10个专家,容量因子1时每专家只能接收约10个。若30个token都选专家A,即使总容量等于token数,仍会出现局部溢出。这说明足够的总空位不等于每个专家都有适当负载。
四、同时比较时间阈值、稳定性和蒸馏增益
先按容量因子比较时间与质量,再读精度和初始化;蒸馏表的分母则是教师增益。
| 项目 | 原文设置与解释 |
|---|---|
| 预训练 | C4,T5式片段恢复;不同实验采用不同训练长度 |
| 路由比较 | 表1使用128专家、隔层替换FFN,32个TPUv3 cores,对比T5、top-2 MoE与top-1 Switch |
| 预算口径 | 表1分别列100k步质量、达到指定质量阈值的小时数、每秒样本;阈值实验需要超过100k步 |
| 稳定性 | 表2比较精度,表3用32专家模型训练3.5k步、每配置3种子报告均值与标准差 |
| 下游正则 | 表4模型先读34B C4 tokens,再比较专家及普通层dropout;后续主微调实验预算不同 |
| 主要微调配方 | §4.1预训练550k步、每批tokens约576B,再按任务微调与验证选择 |
| 指标 | 负对数PPL越高越好;下游GLUE聚合、摘要ROUGE-2、问答EM等分别计算 |
负对数困惑度是负数,较接近零表示更好。不要把表中-1.55误读成低于-1.73所以更差。不同阶段的34B与576B也不能混成一个训练量。
可以设计未执行实验,在固定token量和设备数下改变容量因子与辅助损失,记录溢出率、空槽比例、每步时间、验证损失与不同内容群体表现。若溢出降低但时间增加,需比较达到同质量的总时间;若负载均匀却质量下降,可能均衡压过了有用分工。
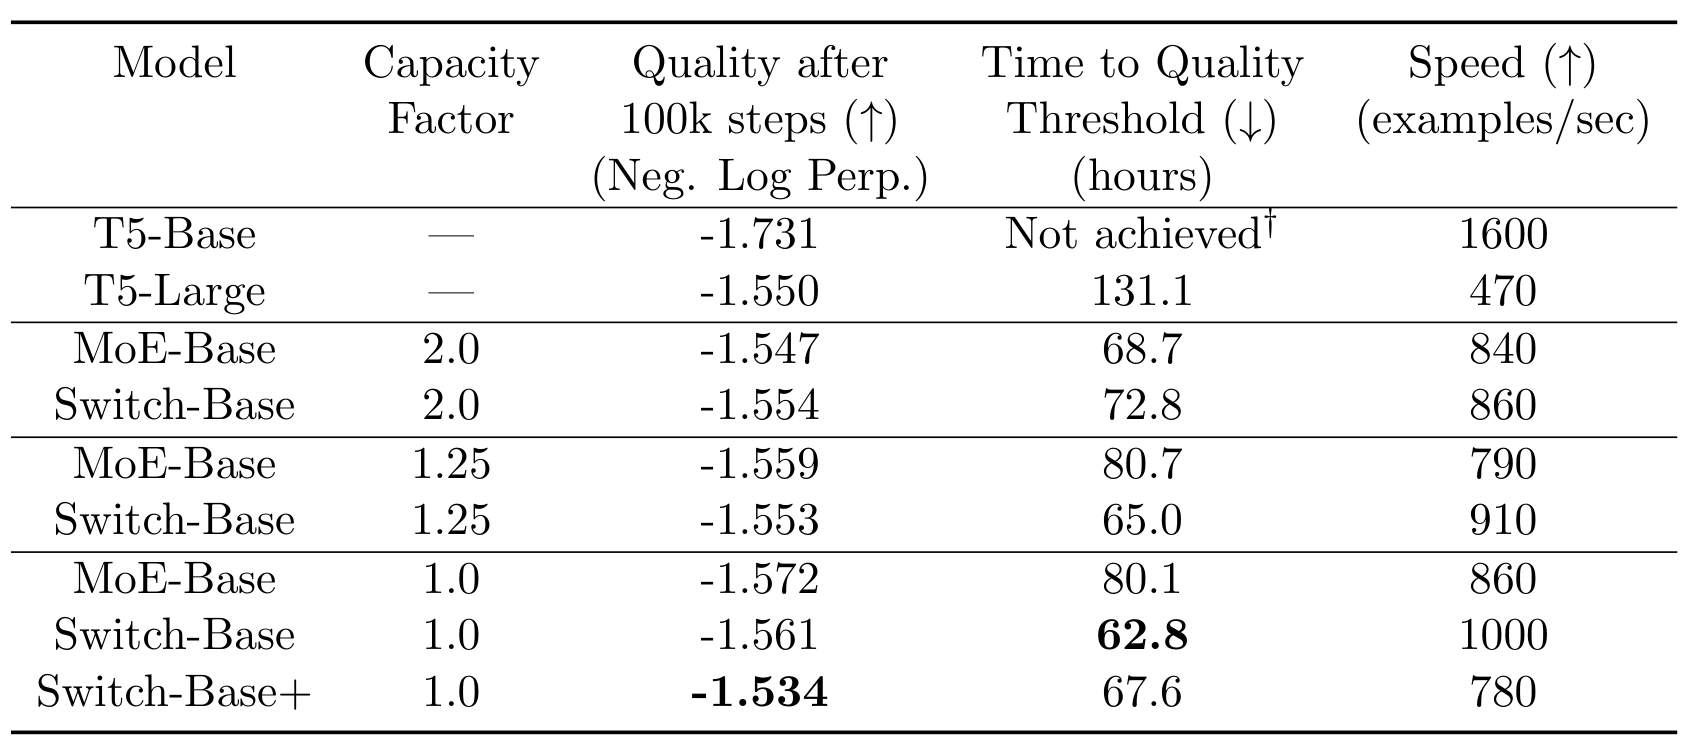
证据一:表1,单路由的时间—质量比较。 容量因子1.0时,MoE达到指定质量阈值需80.1小时、速度860 examples/s,Switch为62.8小时、1000 examples/s;100k步质量分别-1.572和-1.561。它支持该配置下简化路由的效率优势,但其他容量因子下排序与差距不同,不能宣称top-1无条件胜过top-2。
证据二:表2,精度应按敏感组件配置。 全float32质量-1.718、1160 examples/s,选择性精度-1.716、1390 examples/s;全bfloat16配置发生发散。这里测的是特定32专家模型早期阶段,支持路由高精度的实用性,不保证所有规模不会再发生数值故障。
证据三:表3、表4,训练与微调各有问题。 较小初始化的早期质量标准差0.01,对比原尺度0.68,来自3种子。表4中简单提高所有层dropout不一定有利,而普通层0.1、专家0.4的配置表现更均衡。证据支持定向稳定与正则,不能只记住“专家更多所以更好”。
证据四:表8,蒸馏保留的是增益的一部分。 T5-Base SuperGLUE74.6,Switch-Base81.3,蒸馏学生76.6。保留比例约为,不是学生只剩教师30%的绝对成绩。压缩可以带回部分收益,却不能假装完全保留稀疏大模型能力。
多语言部分报告的步数加速也需要与墙钟加速分开。步数比衡量达到同质量需要多少更新,实际每步时间仍受路由与设备配置影响。
五、存储、溢出与微调风险没有随top-1消失
还可比较top-1与top-2在相同每tokenFLOPs、相同墙钟预算、相同参数三个不同口径下的表现。这三个约束通常不能同时满足,应分别组织实验,而不是挑选对某种方案最有利的一列。
限制是模型权重仍很大,推理批量较小时专家利用率可能不足,负载与精度依然需要工程处理,预训练优势也不自动在所有下游任务等比例出现。
六、保留专家路线,继续比较激活数与系统目标
Top-1降低执行分支数,未让专家存储和调度消失。Mixtral提供Top-2的另一组语言模型证据;DeepSeek-V3进一步比较负载控制与系统设计,不能只沿“专家更多”排名。
自测与参考答案
1. 只选一个专家,路由器怎样获得梯度?
选中专家输出仍乘对应softmax概率,且有可微平均概率辅助项;这些路径能更新路由参数。argmax选择本身并没有变得可微。
2. 总容量等于token数,为何仍会丢弃专家计算?
token可能集中选少数专家,各专家容量不能随意借用。局部满载与其他专家空闲可以同时发生,所以还需要负载控制。
3. 蒸馏保留30%教师表现是什么意思?
表8指保留相对于原学生基线的约30%提升,学生分数76.6并非教师81.3的30%。必须区分绝对成绩与性能增益。