092|DeepSeek-V3:让模型、数值精度与通信共同接受成本约束
论文:DeepSeek-AI,DeepSeek-V3 Technical Report,首次公开于 2024 年。原文 · 正文 v2 · 官方代码与权重入口。
先接住前作的问题
Mixtral帮助区分专家总容量与活跃计算,本篇是MoE的平行系统设计,直接沿用DeepSeek-V2的MLA与细粒度专家。后训练组合DeepSeekMath的GRPO,R1则以V3-Base为起点;两条直接联系分别在优化与基座。
五个前置概念
五个前置概念:MoE 是按输入选择少数子网络;KV 缓存 保存已处理前缀的注意力信息;教师强制 在训练中使用真实历史输入;混合精度 对不同运算选择不同数值格式;流水线并行 将层分配到不同设备并交错执行微批次。
一、问题设定:扩大专家容量时,怎样同时约束活跃计算与数据搬运
预训练仍由前缀预测下一token,不含外部环境转移;SFT与GRPO属于后训练。扩大稀疏容量并不会自动解决专家通信、负载等待或历史缓存,本篇要让架构、监督与执行调度在同一资源账本中工作。
MoE 让每个 token 只调用少数专家,但所有专家权重仍须存储,路由还会触发跨设备通信。专家负载不均时,最忙的设备决定整批速度。传统辅助损失强迫每段文本平均使用专家,又可能压制数学、代码等领域的专门化。MLA 主要处理另一瓶颈:生成越长,注意力缓存越大。
论文依赖的条件包括大规模专家并行、高带宽节点内网络、能实现细粒度量化的内核,以及足够大的批次。把同一套参数放到少量消费级显卡上,不能自动继承论文的吞吐表现。
二、拆开MLA、专家负载偏置和多token监督
MLA:缓存压缩后的历史
设当前隐藏向量为 ,先形成低维表示 ,再由上投影得到不同头所需的键和值。位置编码另保留解耦的 RoPE 键。V3 使用 512 维 KV 潜变量与 64 维位置键,因此每层每个历史 token 的主要缓存是 576 个数,而不是所有头的完整键值。
这项机制继承自 V2。它压缩每个时间步的历史表示,并不把历史变成固定大小状态:序列长度翻倍,缓存仍相应增长。实际计算还通过矩阵吸收减少重复展开,不能把概念公式直接当成最快的实现。
专家路由:把选择与混合权重分开
令 为 token 对专家 的 sigmoid 亲和分数, 为负载控制偏置。选择集合近似写成:
偏置参与“让谁进来”,混合权重仍由原始亲和分数计算。全批次中超载的专家降低偏置,欠载的专家提高偏置;这不是让语言建模梯度同时承担全部负载平衡任务。模型每个 MoE 层包含一个共享专家与 256 个路由专家,每 token 选八个路由专家,并约束通信涉及的节点数。
需要细读“无辅助损失”的含义:最终 V3 仍使用系数 的小幅序列级辅助项,避免单序列极端失衡。主平衡机制不靠该项,不等于整个训练目标完全没有辅助损失。
用一次手算拆开“调度分数”和“模型权重”
原创路由例。 为简化取4个专家、每次选2个,原始亲和分数为 ,负载偏置为 。选择分数变成 ,于是专家3与2入选,但混合仍使用原亲和分数,二者权重是0.2与0.8。若误用加偏置的0.9、0.8归一化,则变成约0.529与0.471,已经改了论文的算子。
偏置的目的在于给欠载专家进入候选集的机会,并没有宣称它突然更懂当前token。选择与混合分开,允许以较少的语言目标梯度干扰调节负载;与此同时,强行改选集合仍会改变模型输出,不能描述成负载控制对语义计算完全没有影响。例子只隔离路由公式,没有模拟真实的节点限制、共享专家或256专家部署。
缓存压缩也可以做一个代数检查。只看MLA不含位置的键分支,令压缩缓存为 ,上投影为 ,当前查询为 ,其中 是压缩维数、 是该头内容向量的维数, 为历史位置、 为当前时间,则
左边为每个历史位置展开键,右边先把当前查询变换一次,再与缓存点积;两者在精确算术中相同。独立的RoPE键分支另算,不能把这条内容分支等式扩展成任意位置编码都可直接吸收。真正节省了哪些读写,还须取决于推理内核是否采用这个顺序。
多 token 预测:让表示考虑更远一步
普通主干用位置 预测 ;额外模块把当前位置表示与下一 token 的嵌入结合,预测 。论文使用一个额外深度,目标可概括为:
控制额外预测监督, 是小幅序列平衡权重。训练时使用已知的下一 token 属于教师强制:模块预测的是再后一个 token,而非把答案直接作为同一预测目标的输入。额外模块共享嵌入与输出头,可以在普通推理时丢弃,也可以用于投机解码。
FP8 不是“所有量都用八位”:矩阵乘法采用低精度,归一化、路由、部分注意力及关键训练状态保留较高精度;激活与权重使用不同粒度的缩放。DualPipe 尝试把计算与通信重叠,效果依赖内核和网络。数学目标的改变主要来自 MTP 等训练项;量化与调度主要改变实现成本,二者不应混为一个“新损失函数”。
自构例子。 某批文本中一半是代码、一半是诗歌。若每篇都必须平均使用所有专家,代码专家也被迫大量处理诗歌。改成整个批次平衡后,两个领域可以分别集中使用合适专家,同时总体负载均衡。若部署时突然全是代码,这种训练时的平衡就未必保持;因此质量与调度必须一起考虑。
路由偏置改选择,不应悄悄改混合权重
设两个专家原亲和分数为0.6和0.4,偏置可让原本较低者进入候选,但混合仍按被选专家的原亲和分数归一。若将偏置也加进归一化分子,就把负载控制额外变成输出幅度控制。检查时应分别保存选择分数、入选集合和实际门值,不能只打印一个router tensor。
教法联系:Lilian Weng的How to Train Really Large Models on Many GPUs?。算例为本文自构。
三、用混合精度、流水线与通信重叠执行训练
输入:训练文本、主干参数、MTP 参数、各专家路由偏置
重复处理一个全局批次:
    对每个 token 计算主干隐藏状态与压缩注意力缓存
    用“亲和分数 + 偏置”选择路由专家
    用原始亲和分数归一化,混合被选专家与共享专家输出
    主输出头预测下一 token
    MTP 模块结合后移一位的输入,预测再下一个 token
    计算主交叉熵、MTP 交叉熵与小幅序列平衡项
    使用规定的混合精度与流水线更新参数
    汇总专家负载:超载则下调偏置,欠载则上调偏置
输出:主模型;MTP 模块可选用于推理加速
四、分离基础模型、模块消融与后训练的证据
先辨基础与后训练表,再看MTP、负载策略的同配置消融;V2.5蒸馏结果不能算成V3模块收益。
| 项目 | 论文设置与应回答的问题 |
|---|---|
| 全规模预训练 | 14.8T token,2048 张 H800;验证整个系统能否持续完成大型训练 |
| 训练长度 | 预训练上下文 4K,随后分阶段扩展到 32K、128K;长上下文检索测试不等于长篇推理无损 |
| 总训练预算 | 表1:预训练 2.664M GPU 小时,长度扩展 119K,后训练 5K,合计 2.788M |
| 基础模型对照 | 表3:V2、Qwen2.5 72B、Llama 3.1 405B;采用内部统一评估设置,训练数据与预算并不相等 |
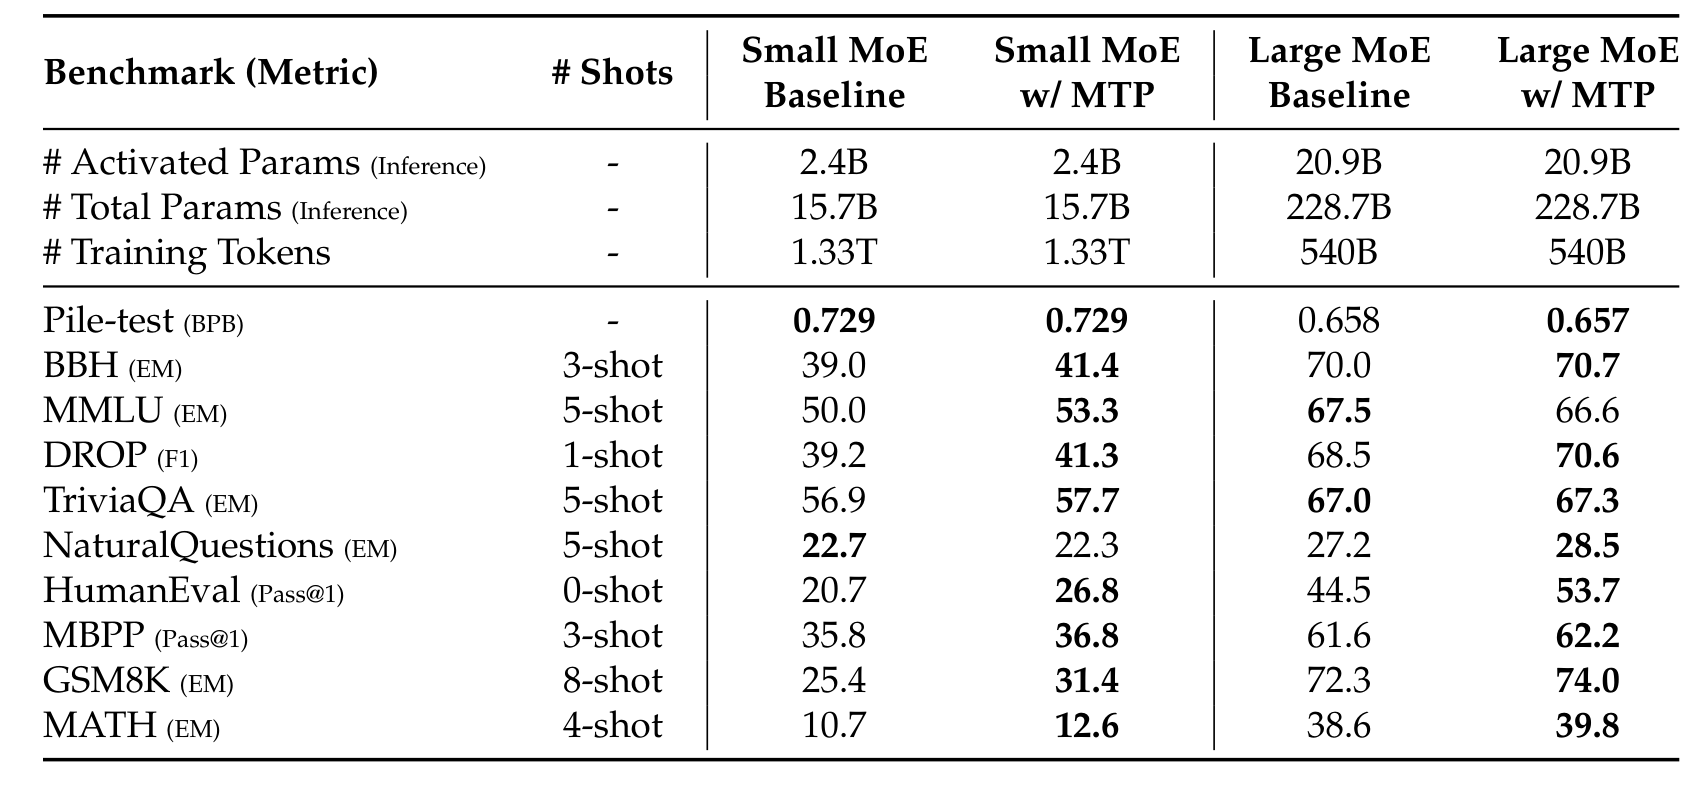
| MTP 消融 | 15.7B 模型训练 1.33T token;228.7B 模型训练 540B;推理时丢弃额外模块 |
| 路由消融 | 小模型 1.33T、大模型 578B;比较辅助损失与偏置控制,另检查批次级约束 |
| 指令训练 | 1.5M 条监督实例,训练两轮;随后混合规则奖励与模型奖励执行 GRPO |
| 评估重复 | AIME、CNMO 温度 0.7,平均 16 次;MATH-500 贪心解码;不能把所有任务都称为 16 个随机种子实验 |
| 统计限制 | 全规模模型没有多次从头训练的置信区间;“差距不超过 0.3 视作同水平”是表3 的比较约定,不是显著性检验 |
按报告假设每 GPU 小时两美元,训练费用为 557.6 万美元。该数排除了前期研究与消融费用,不代表整个项目、数据处理和研发的总成本。稀疏激活参数也不是可直接兑换成美元的统一计量单位。
证据 1:表3,基础能力。 V3 的 MATH 四样例得分 61.6,Qwen2.5 72B 为 54.4,Llama 3.1 405B 为 49.0;HumanEval 零样例分别为 65.2、53.0、54.9。这支持该模型在这些设置下有较好的数学、代码表现。相反,RACE-Middle 的 V3 为 67.1、Llama 为 74.2,不能写成全面胜出。训练规模、数据和架构一起改变,主表不能单独归因于路由算法。
证据 2:表4,MTP 消融。 大模型 HumanEval 从 44.5 到 53.7,上升 9.2 个百分点;MMLU 却从 67.5 到 66.6。推理时额外模块被移除,因此能力变化不是测试时多算一步造成的;训练期却增加了计算,所以它不是严格等训练 FLOPs 的比较。
证据 3:表5 与 §4.5.3,平衡作用来自哪里。 大模型偏置策略使 HumanEval 从 40.2 到 46.3,但 MMLU 从 68.3 降到 67.2。更关键的是,1B 模型使用序列辅助损失时验证损失 2.258,偏置策略和批次级辅助损失都为 2.253;3B 上后两者同为 2.080。这说明约束的作用范围可能很重要,不能据此宣判所有辅助损失都会损害模型。
证据 4:表6,后训练模型。 V3 在 AIME 2024 得到 39.2,GPT-4o-0513 为 9.3;SWE-bench Verified 为 42.0,Claude 3.5 Sonnet-1022 为 50.8。前者按 16 次采样评估平均,后者使用 Agentless 框架。它们既不是同一种任务,也不是“模型独自修复仓库”的统一指标。
证据 5:表9,推理蒸馏的代价。 这里的实验对象是 V2.5:引入 R1 蒸馏后,MATH-500 从 74.6 到 83.2,平均回答长度从 769 到 1510。它支持准确率与回答长度共同变化,不能被引用成 V3 的独立消融,更不能证明准确率提升没有推理成本。
五、复杂配方与部署存储不能由单一成本数概括
论文最有价值的地方是把“减少每 token 运算”“减少缓存”“平衡专家”“隐藏通信”“增加训练监督”放在同一个可运行系统里。单项并非全部首创,整体结果也不能分摊成每个模块的精确贡献。
作者报告训练没有不可恢复的损失尖峰,这是一次工程运行的记录,不是对所有数据和硬件配置的稳定性证明。公开权重和推理入口降低使用门槛,但完整训练语料与工业训练设施并未以可逐项重建的形式全部提供。领域切换还可能让推理专家负载重新失衡,需要冗余专家部署等系统手段补救。
这里的分析是:真正可迁移的思想不是某个成本数字,而是先找到主要瓶颈,再检验改动有没有把代价挪到通信、缓存或额外训练阶段。选择一个看似最省 FLOPs 的模型,可能仍得到更差的端到端延迟。
六、把基础模型与GRPO连接到可验证推理训练
R1直接以V3-Base为起点研究可验证推理后训练。沿这条联系,应把预训练的MLA/MoE成本与后训练采样、长回答成本分账,不把基座一次训练数字当成完整推理模型总成本。
七、自测与答案
1. 为什么“每 token 激活 37B”不等于“只需存储 37B 参数”?
答:不同 token 会选择不同专家,全部 671B 参数仍构成可调用模型。激活量主要描述当前计算参与度,权重存储还涉及全部专家、数据类型和并行布局,通信也不由激活量单独决定。
2. 表4 中推理时移除 MTP,为什么仍能提升成绩?这是否证明免费提升?
答:额外预测损失在训练期改变主干表示,移除模块后这些参数变化仍在。它证明改善可以在相同的基础推理结构中保留;额外训练计算没有消失,因此不能称为全生命周期免费。
3. 批次级辅助损失与偏置路由达到同样验证损失,推翻了什么简单解释?
答:它反对“只要用了辅助损失就一定伤害语言建模”的单一解释。序列级约束可能过强,改成批次级约束便允许领域专门化;偏置更新只是实现这种更灵活平衡的一条路径,仍须比较负载、质量与通信成本。