084|Mixtral:用更多参数储存能力,用少数专家处理每个 token
论文:Albert Q. Jiang 等,Mixtral of Experts,2024。采用论文首版;官方实现见代码仓库。论文是较短的模型报告,预训练数据总量、完整优化配置等未披露,不能把架构可运行误称为训练可完整重建。
图表来源:Albert Q. Jiang 等,2024,原文;CC BY 4.0。本篇展示做了图形区域裁切、PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。
先接住前作的问题
Switch Transformer用稀疏专家分离容量与活跃计算,本篇沿同一家族采用Top-2前馈路由。未解问题仍是额外容量如何在实际语言任务和设备调度中产生价值;DeepSeek-V3是另一套专家与系统配方,不能编成直接复制关系。
五个前置概念
五个前置概念:MoE用多个参数分支扩展容量;路由器按输入选择分支;活跃参数描述一次前向实际用到的参数;专家并行把不同专家分布到设备;多数投票解码用多次候选提高答案选择效果并增加推理成本。
一、问题设定:扩大专家容量时,怎样只让少数分支参与每token计算
总参数决定要存多少权重,活跃参数描述单个token经过哪些分支,运行显存还包含KV、激活和通信。Mixtral只在前馈部分扩展专家,并共享注意力等组件;需要分别核算容量、路径计算和系统成本。
论文给出的数量级是约 47B 总参数、约 13B 活跃参数。不是 B,因为没有复制八套完整注意力和嵌入;也不是 B 的精确活跃量,因为共享与专家组件的比例不同。
这是无环境交互的语言预训练及后续指令/偏好微调,不是机器人式在线强化学习。路由器选择的是内部计算分支,不能把它直接当作外部动作策略;专家输出是向量,不是完整自然语言答案。
与早期 MoE 论文的关系也很具体:Mixtral 沿用稀疏路由思想,报告其在开放权重、实用语言模型规模上的效果。它不是 MoE 的发明者。其意义在架构、能力和可部署实现的组合。
二、推导Top-2归一化与局部路由梯度
令当前 token 的隐藏向量为 ,路由参数为 。先计算 8 个分数,只保留最大的两个,再做 softmax:
未被选中的 logits 视为负无穷,对应权重为零,所以无需计算这些专家。 是独立参数的 SwiGLU 前馈网络; 是组合权重。被选专家不是每段对话固定一次,也不是按任务标题永久分配,而是随 token、层和上下文变化。
Top-2 之后的归一化,也决定梯度怎样分配
设路由 logits 为 ,选中的两个专家下标组成集合 。对于 ,;未入选的权重为0。在所选集合不变的局部区域,有 。这里 在下标相等时为1,否则为0。训练不仅改变专家输出,也能通过两个专家之间的相对分数改变混合;但Top-2集合切换处不光滑,不能把这个局部导数当成对离散选择的完整可微证明。
原创教学例。 四个路由分数为 ,只取前两个时权重约为 。若两个专家输出分别是 、,混合输出约为 。如果先对全部四项做softmax,再直接丢掉后两项而不重归一化,前两权重约为0.644、0.237,和只有0.881,输出尺度也变了;它不是论文写出的同一个算子。
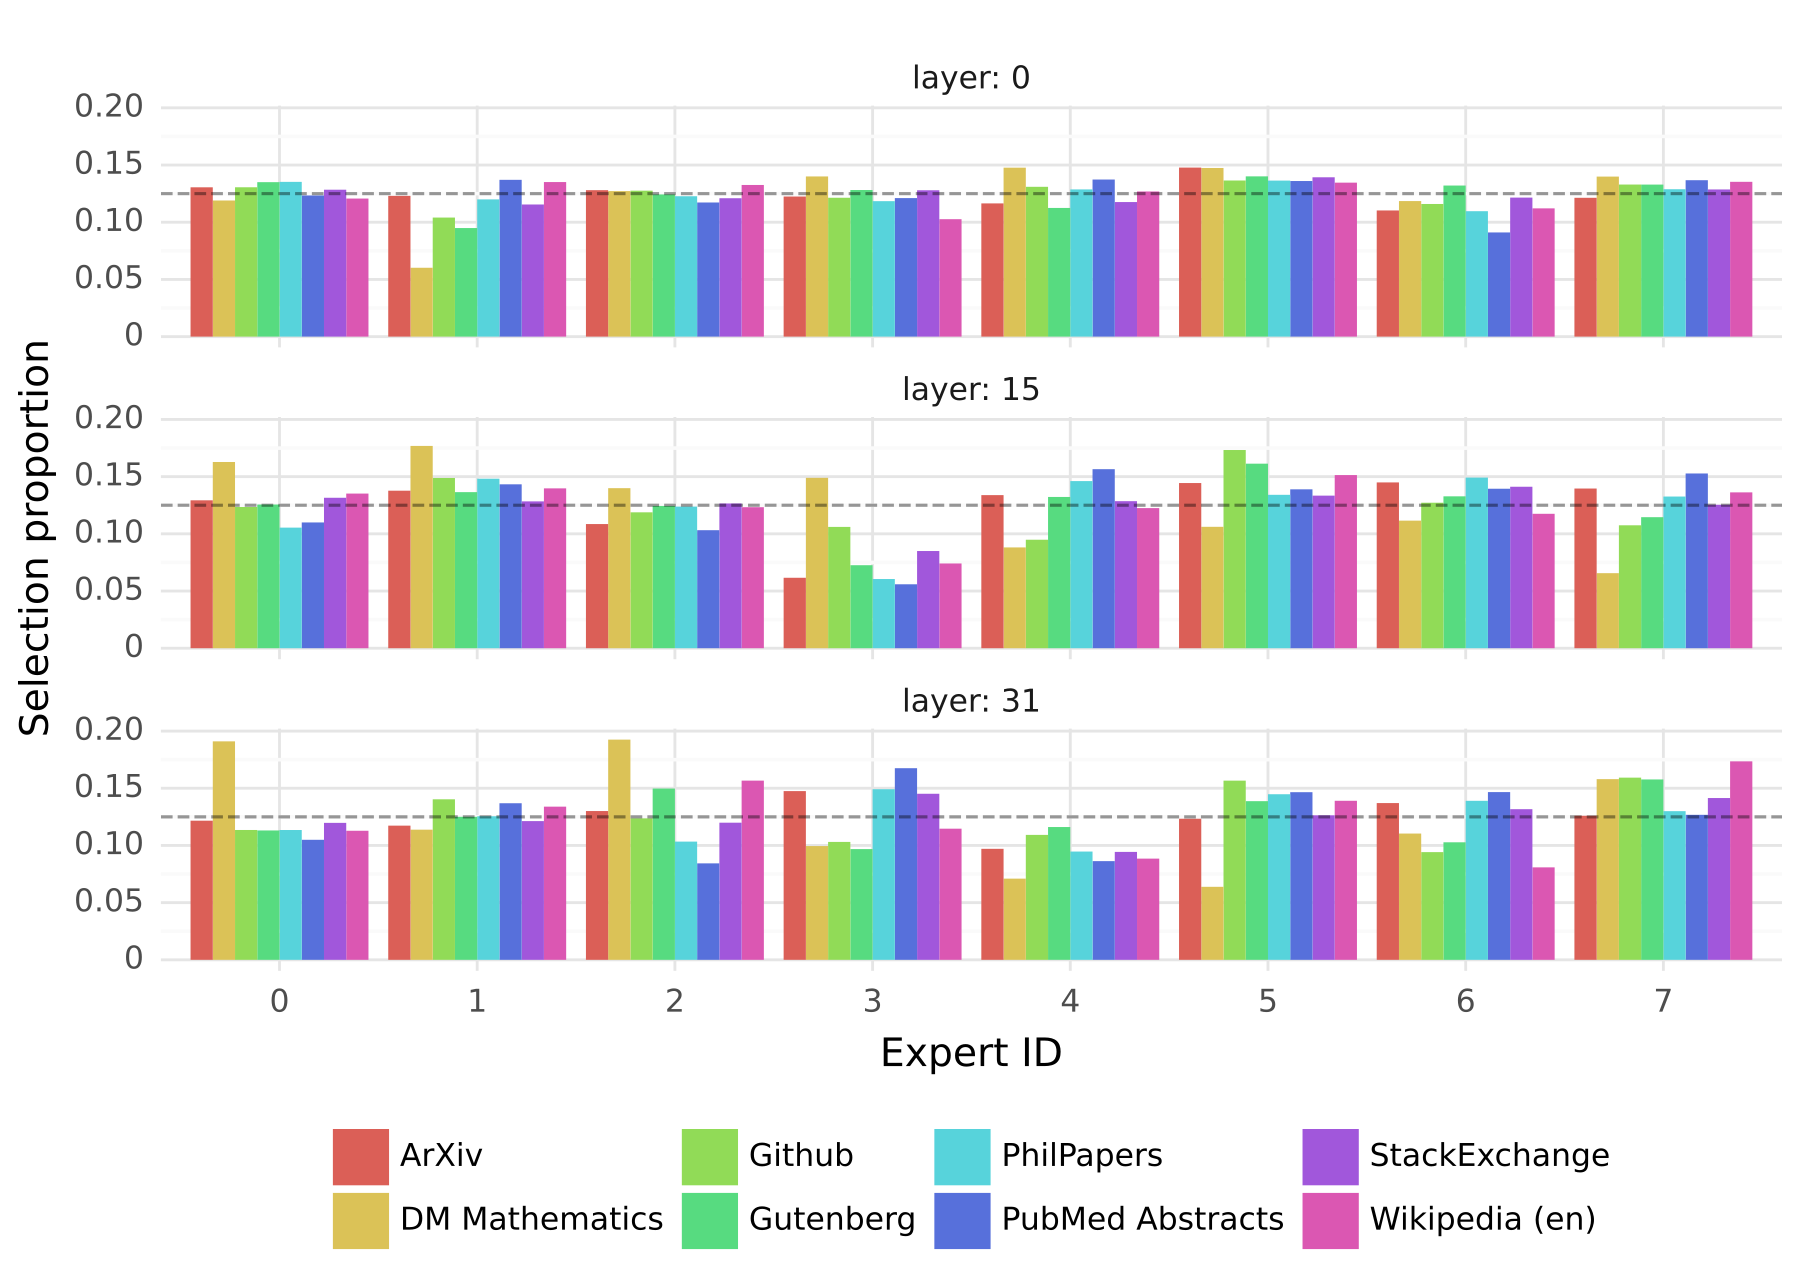
这还解释路由图的阅读边界:选中频率描述哪些分支有机会接收梯度,但不能单独告诉我们每次权重大小、实际梯度方向或专家学到的语义。原文在不同语料子集观察路由比例相近,并不等于对每个token都会做相同计算。
SwiGLU 专家可抽象为
这个形式把非线性门控与通道变换结合。不同专家有自己的矩阵,注意力子层仍负责 token 之间的交互;MoE 前馈子层在得到上下文化表示后逐 token 处理。
表1 的架构为 32 层、隐藏维度 4,096、32 个查询头、8 个 KV 头、头维度 128、专家中间维度 14,336、词表 32,000,支持 32,768 的稠密上下文。GQA 节省 KV,MoE 控制前馈活跃计算,它们的收益来自不同位置。
这段伪代码解释计算路径,不补写论文未报告的负载平衡损失、容量系数或 token 丢弃规则。MoE 训练常见某类技巧,不代表 Mixtral 报告明确采用了同一配置。
若专家分布在不同 GPU,输入要发到相应设备再取回,形成专家并行。某一批 token 集中选中少数专家时,设备负载可能失衡;如果各专家收到的 token 太少,矩阵运算也难以充分利用 GPU。稀疏 FLOPs 不自动转化为等比例墙钟收益。
指令版另外执行 SFT 和 DPO。二者改变模型行为,但论文没有给完整数据、超参数和模块消融,因此不能从指令成绩反推 DPO 独自贡献了多少。
自构算例。 假设一个模型共享部分有 3 个单位参数,每套专家跨层合计 5 个单位,则 8 专家总参数为 ,Top-2 活跃量为 。这说明总量和活跃量如何分离,不是 Mixtral 的精确参数拆分。若全部专家常驻设备,43 个单位仍要存储;不能因为一次只算 13 就只准备 13 的权重内存。
专家合批后必须恢复token身份
把两条token分别送到专家时,设备内通常按专家重排了次序。返回后应先用dispatch记录还原原token位置,再按各自门值合并;若直接按返回顺序相加,输出张量形状可能仍正确,语义却串到别的token。检查可给每个token不同标记值,并对照不分发的单机实现。
教法联系:Lilian Weng的How to Train Really Large Models on Many GPUs?。算例为本文自构。
三、按专家合批分发token并返回原位置
再设两个 token 都选择专家 1、2,另两个选择专家 7、8:系统可以按专家把 token 合批。若一整批都选择专家 1,分布式设备可能一边拥堵一边空闲。有效部署需要看路由分布和硬件,而不只是 Top-k。
输入:token 序列和当前层隐藏状态
对每个 Transformer 层:
    用共享注意力处理上下文,获得逐 token 表示
    对每个 token 计算 8 个路由 logits
    选出 Top-2 专家,将两项权重归一化
    按专家分组/分发 token,批量运行对应 SwiGLU
    将专家输出送回原 token 位置并加权相加
    完成残差等常规层操作
语言模型头产生下一 token 分布
训练时:依据语言建模目标反向传播
输出:token 分布;每 token、每层仅激活两个专家
四、分别核对解码预算、长上下文与路由分布
先核对Top1与投票、5-shot等解码口径,再看路由图;接近均匀占比只说明频率,不证明专家学科分工。
| 项目 | 论文设置与未披露部分 |
|---|---|
| 预训练 | 多语言语料,训练上下文 32K;总 token、完整数据混合、训练步数和算力未报告 |
| 主基线 | Mistral 7B、多个 LLaMA/Llama 2;作者用自己的管线重新评估 |
| 数学表2 | GSM8K:8-shot、maj@8;MATH:4-shot、maj@4,不是单次贪心准确率 |
| 代码 | HumanEval 0-shot;MBPP 3-shot,采用人工核验子集 |
| 表3 | 单独列出与 GPT-3.5 的比较,GSM8K 标注 5-shot;不能与表2 的 74.4 直接混算 |
| 多语言 | 法语、德语、西班牙语、意大利语的 ARC、HellaSwag、MMLU |
| 长上下文 | passkey 提取与 proof-pile 子集困惑度;没有覆盖所有长文推理类型 |
| 指令版 | MT-Bench 与 2023-12-22 的 Arena 快照;并非当前排行榜 |
| 随机性与预算 | 未报告所有基准重复训练/评估的完整置信区间,也未给端到端硬件实测吞吐表 |
表2 的 MATH 28.4 与 GSM8K 74.4 尤其容易被误引,因为多数投票增加了推理计算。比较不同论文的结果时,模型名字只是必要条件之一,还要核对候选数量、示范、答案解析和测试子集。
证据一|表2:数学和代码强,但不是逐项胜出。 Mixtral 与 Llama 2 70B 的 HumanEval 为 40.2 对 29.3,MATH 为 28.4 对 13.8,GSM8K 为 74.4 对 69.6,均遵循本表口径。WinoGrande 则为 77.2 对 80.4,TriviaQA 为 71.5 对 73.0。应写成“多数基准相当或更强”,不能照摘要简化成所有任务都赢。
证据二|表3、表4:更完整地限定比较条件。 表3 的 5-shot GSM8K 为 Mixtral 58.4、GPT-3.5 57.1、Llama 2 70B 53.6;MT-Bench 则为 8.30 对 GPT-3.5 的 8.32。表4 的德语 MMLU 为 71.5 对 Llama 2 70B 的 64.2,相差 7.3 个百分点。多语言增益与上采样多语言数据同时发生,不能将全部提升归给专家结构。
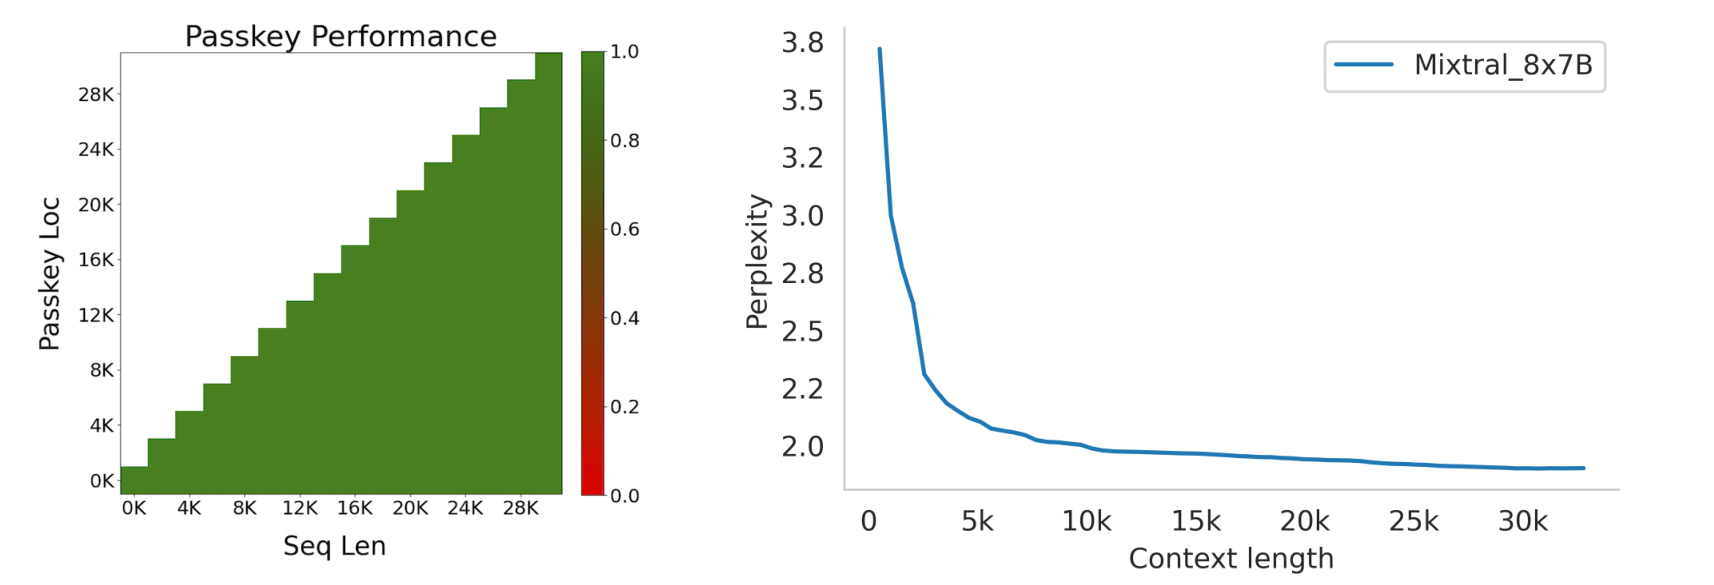
证据三|图4:长上下文提取成功,不等于复杂长文理解解决。 Passkey 实验在所测位置和长度上达到 100%,proof-pile 困惑度随上下文增长下降。前者测定位并复述指定信息,后者测平均预测损失;都没有直接测跨许多证据的复杂归纳、冲突消解或错误来源识别。它们是有价值的长上下文证据,但不是无条件可靠性证明。 Passkey 的位置—长度检索与 proof-pile 困惑度是两个任务;专家分配图的虚线表示均匀占比1/8,接近虚线只能说明使用均衡。
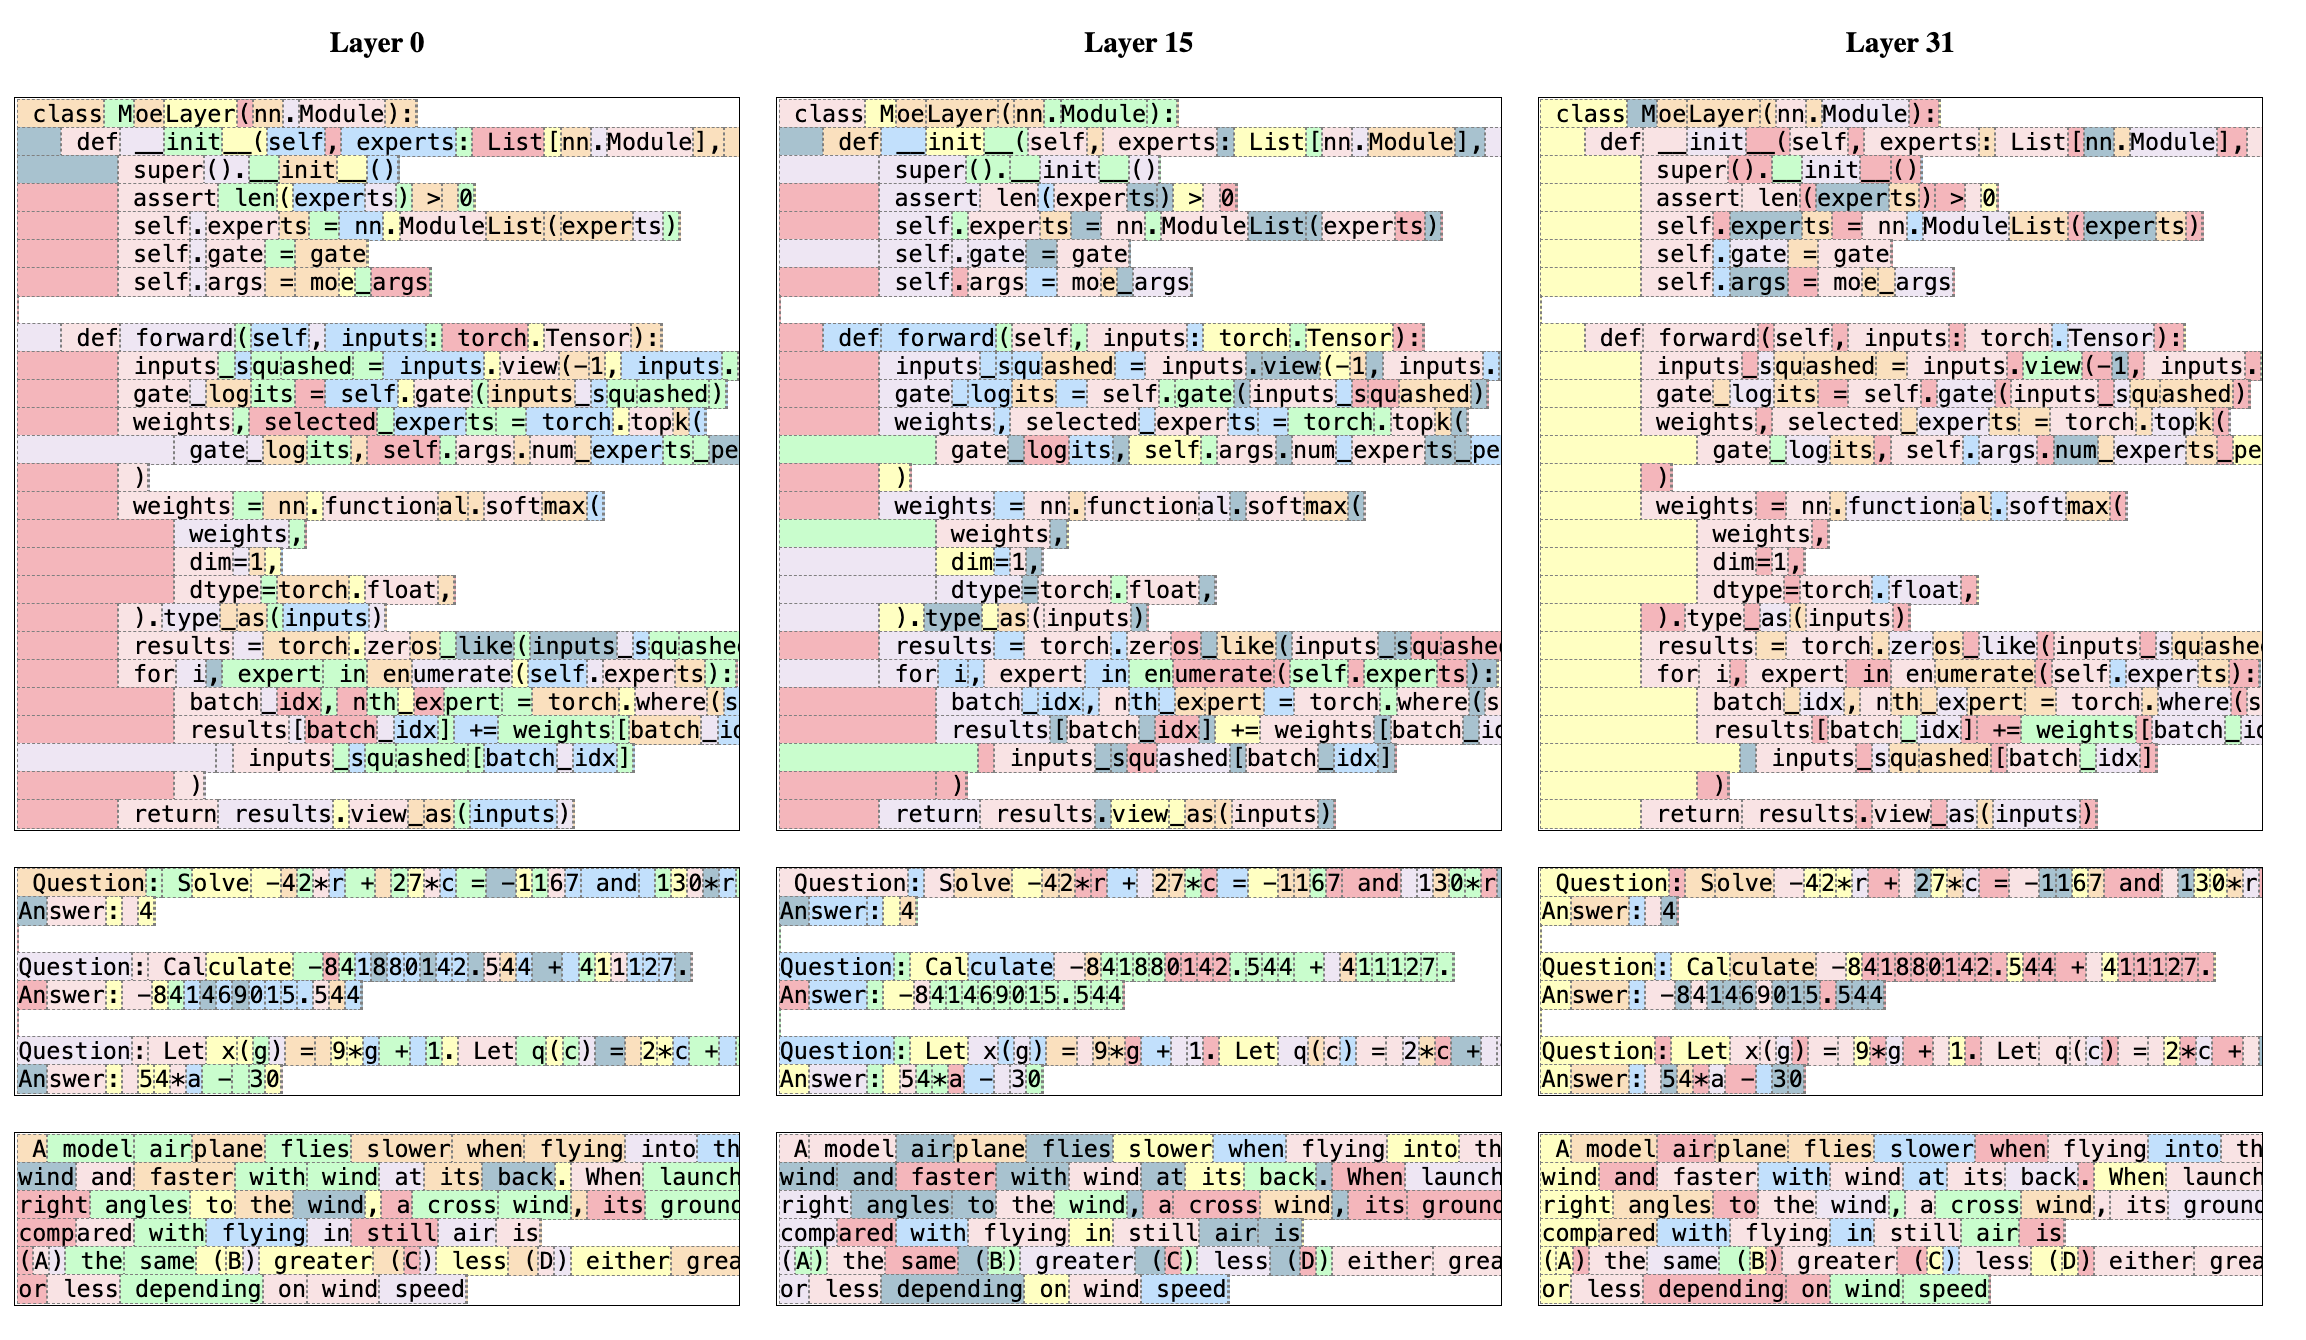
证据四|图7、图8、表5:专家并没有显现简单的学科分工。 路由分布在 arXiv、PubMed、PhilPapers 等领域较接近,作者没有观察到明显的按主题分配。代码缩进和某些词的路由表现更像语法局部模式。表5 中 arXiv 第 15 层相邻 token 第一专家相同为 27.9%,随机基线 12.5%,支持局部性;但总体频率相似不能证明专家完全没有语义功能,仍需因果干预等更细分析。
指令版 Arena 快照 Elo 1121,相比部分基线 1117 数字略高,但正文未给可在此核查的成对显著性分析。历史排名不能直接变成稳定优势,也不能同 MT-Bench 的模型评审分数混为一个“人类胜率”。
五、总权重、负载和披露不足仍限制复现
论文提供架构和权重入口,但训练配方披露程度有限,属于理解与复现之间的重要边界。
六、比较稀疏专家负载与系统协同的另一种配方
DeepSeek-V3提供负载偏置、细粒度专家与系统协同的平行发展。比较应把入选规则、权重归一、通信和训练监督逐项列开,不能把稀疏模型统一成Top-2的倍数游戏。
自测:能否避免 MoE 的三个常见误读
1. 为什么 8×7B 不是八个完整 7B 模型的集成?
答案:复制的是每层前馈专家,注意力等组件共享;每个 token 在每层由路由器选两个向量变换分支。系统没有生成八份完整答案再投票。因此总参数不是简单56B,活跃参数也不是简单14B。
2. 约13B活跃参数是否意味着与13B稠密模型相同显存和速度?
答案:不能。总专家权重仍约47B,常驻存储、缓存和路由通信都占资源;同一批次可能访问很多不同专家。活跃参数主要描述计算路径,实际速度还取决于批量、专家负载、内核和互联。
3. 为什么表2的GSM8K 74.4不能直接与表3的58.4比较出退步?
答案:二者评价协议不同,表2使用8-shot与maj@8,表3标注5-shot。示范和多候选聚合改变推理预算及答案选择。必须锁定同一设置后比较模型,否则只是把不同测量当作同一能力的变化。