037 · GShard:稀疏专家如何真正分布到数千个设备
返回目录 · 上一篇:FiD · 下一篇:BigBird
论文:Dmitry Lepikhin 等,GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding,首次公开2020,ICLR 2021。原始论文。
先接住前作的问题
稀疏MoE把总参数与单token激活分开,但专家跨设备后仍要发送、排队和返回。本篇直接延伸这一执行瓶颈,用容量限制、分组路由与自动分片把条件计算落到多语言翻译;不能从理论激活FLOPs直接推断系统费用。
五个前置概念
五个前置概念是:MoE按输入选择子网络,容量限制控制专家缓冲,负载平衡避免拥塞,SPMD用同一程序处理分片,core-years度量累计设备时间。
一、问题设定:多语言共享容量怎样跨设备执行而不被路由拥堵抵消
多语言模型既要容纳高资源语言需求,又希望低资源语言获得共享迁移。全部挤入稠密参数可能干扰,完全分开又失去共享;专家提供中间方案,但跨设备路由必须控制容量、通信与等待,才能让名义容量真正参与训练。
实际任务是从多种语言翻译成英语,输入源句,输出目标句,优化翻译负对数似然。专家不是人工指定的语言模块,也不是独立智能体;路由由数据学习,不应把某个专家的出现直接解释为语言学概念形成。
GShard 既是系统接口与编译机制,也是用于检验该系统的大模型实例。把“自动分片”与“MoE算法”混为一个概念,会难以判断后续系统是否使用相同模型,或者只是采用类似编译思路。
二、把top-2权重、容量与溢出放进同一约束
设token表示为 ,路由概率为 。候选选择分数最高的两个专家,输出简化表示为:
是专家前馈网络,是保留路由后的权重。这个式子还没有表达实际容量约束:每组token可向某个专家发送的数量有限,第二专家还采用随机路由策略,并非每个token始终运行两个专家。
若整批 个token分成 组,共有 个专家,每组每专家容量约为 。容量限制让张量尺寸可控,方便并行编译。若两个候选都已满,token在该MoE支路没有专家输出,仍通过残差传递,不能描述成从整个网络中删除了该token。
总损失由翻译损失与平衡辅助项组成:
表示平均门控概率,表示实际路由占比。后者由离散选择得到,论文使用可微概率构造代理,避免所有token拥挤到少数专家。此处只给出结构形式,具体归一化与组内计数应按算法1实现。
自构例子:一批句子大多来自高资源语言,门控把相似token集中送到专家A。即便A最擅长这些输入,容量也会溢出,其他专家却空闲。增加辅助损失可以促使分流,但过强的均衡也可能迫使不合适的专家接收token。
按局部分组核算容量,而非只看全局平均
若两组各有4个token、每专家容量2,第一组四个token都首选专家甲,第二组都首选乙,全球看起来甲乙各4次且均衡,组内仍各有2次请求超过对应容量。执行规则是在所声明的局部分组内约束容量,因此全球直方图不能替代溢出率检查。
教法联系:Lilian Weng的How to Train Really Large Models on Many GPUs?。算例为本文自构。
三、用分组和自动分片组织专家通信
输入:token批次、分组规则、专家网络、容量上限
对每组token并行:
    计算专家softmax分数,选top-2候选
    统计并计算负载平衡辅助损失
    在容量范围内接纳第一专家路由
    按第二专家权重随机决定是否尝试第二路由
    容量允许时构建dispatch与combine张量
跨设备交换token,分专家执行前馈计算
交换输出并按combine权重还原token顺序
通过残差接回骨干,优化翻译与辅助损失
编译器依据张量标注生成所需分片和集合通信
输出:可分布式训练的稀疏模型
教学算例。 N=1024、E=16、G=8,每组128个token,每专家每组16槽。若某组有40个token选同一专家,即使其他组该专家有闲置槽,也不会自动按全batch任意调度;局部分组限制了资源池。解释质量变化时,应同时看drop率、路由分布与吞吐,避免只看理论激活FLOPs。
注意力部分可以按批量分片并复制权重,庞大专家权重则分布到不同设备。计算图在这些布局之间切换,编译器插入相应通信。单程序多数据方式让每个设备运行同一程序形态,避免为每个设备手写不同大图。
自动生成并不意味着通信消失。专家调用需要all-to-all等数据交换,网络拓扑和消息大小影响效率。辅助损失改善的是负载分配,编译分片改善的是执行方式,翻译BLEU改善来自容量、共享、训练等因素,不能把三个层级的收益混算。
容量上限把路由变成有约束的资源分配
设总token数N、专家数E、分组数G,top-2路由给每组每专家约 个槽位。组内并行分派时必须检查已占槽位,溢出token可能无法通过所选专家,而沿残差继续传递。均衡辅助损失是在训练层面减少拥挤;容量上限是在执行层面确保张量大小和资源可控,两者不能互相替代。
四、同时比较BLEU、样本阈值、墙钟和设备年
按语言曲线看质量,按时间与core-years记资源,再看达到同损失的样本数。
| 项目 | 论文配置与问题 |
|---|---|
| 数据 | 内部网页挖掘平行语料,双向约250亿样本,本文到英语方向约130亿;语言资源极不均衡 |
| 模型族 | 表1改变深度12/36层及每MoE层128/512/2048专家,专家层间隔插入 |
| 训练量 | 主要质量比较使用处理1万亿token的检查点;部分损失阈值分析训练更久 |
| 基线 | 各语言单独训练的双语Transformer,以及96层稠密多语言模型 |
| 设备 | 128、512或2048 TPU v3 cores;设备数与每层专家数联动,非纯模型变量对照 |
| 指标 | BLEU及相对双语基线差值、达到损失阈值的token量、步速、墙钟天数、TPU core-years |
| 不确定性 | 巨型配置没有统一多种子置信区间;内部数据也限制第三方严格复现 |
这里处理1万亿token不是拥有1万亿条独立句对。表2统计达到某个训练损失阈值的数据量,也不等同测试质量。论文明确该处训练交叉熵不包括辅助损失,避免平衡项变化扭曲拟合速度比较。
可做一个未执行的小规模实验:固定专家总容量,改变语言混合比例与平衡权重,测每专家负载、溢出率、逐语言BLEU和通信等待。若平均BLEU改善而低资源语言下降,应报告分组结果;若溢出降低但质量恶化,说明均衡本身不是任务目标。
还应独立比较同设备数与同墙钟预算。扩大专家同时扩大设备,主要显示可扩展性;在固定硬件上换更大专家模型,则回答部署或训练预算内是否值得。两种结论都重要,但不能互相冒充。
证据一:算法1–2与§3,路由能否落地。 容量、分组和随机第二路由将不规则专家调用变成规则张量操作。它们支持可执行系统设计,但容量限制会使某些token跳过专家支路,必须结合溢出和质量观察,不能只展示平均吞吐。
证据二:图6与表3,质量和资源同时报告。 600B、2048专家、36层配置平均BLEU44.3,所列稠密96层模型36.9。600B模型用2048 cores约4天,同时消耗22.4 TPU core-years。4天是等待时间,22.4设备年是累计资源,两者都真实,不能只用前者营造低成本印象。 横轴按语言资源量从高到低排列,纵轴是相对单语模型的 BLEU 差值;趋势线经过10语言窗口平滑,不能读成每种语言的原始点值。
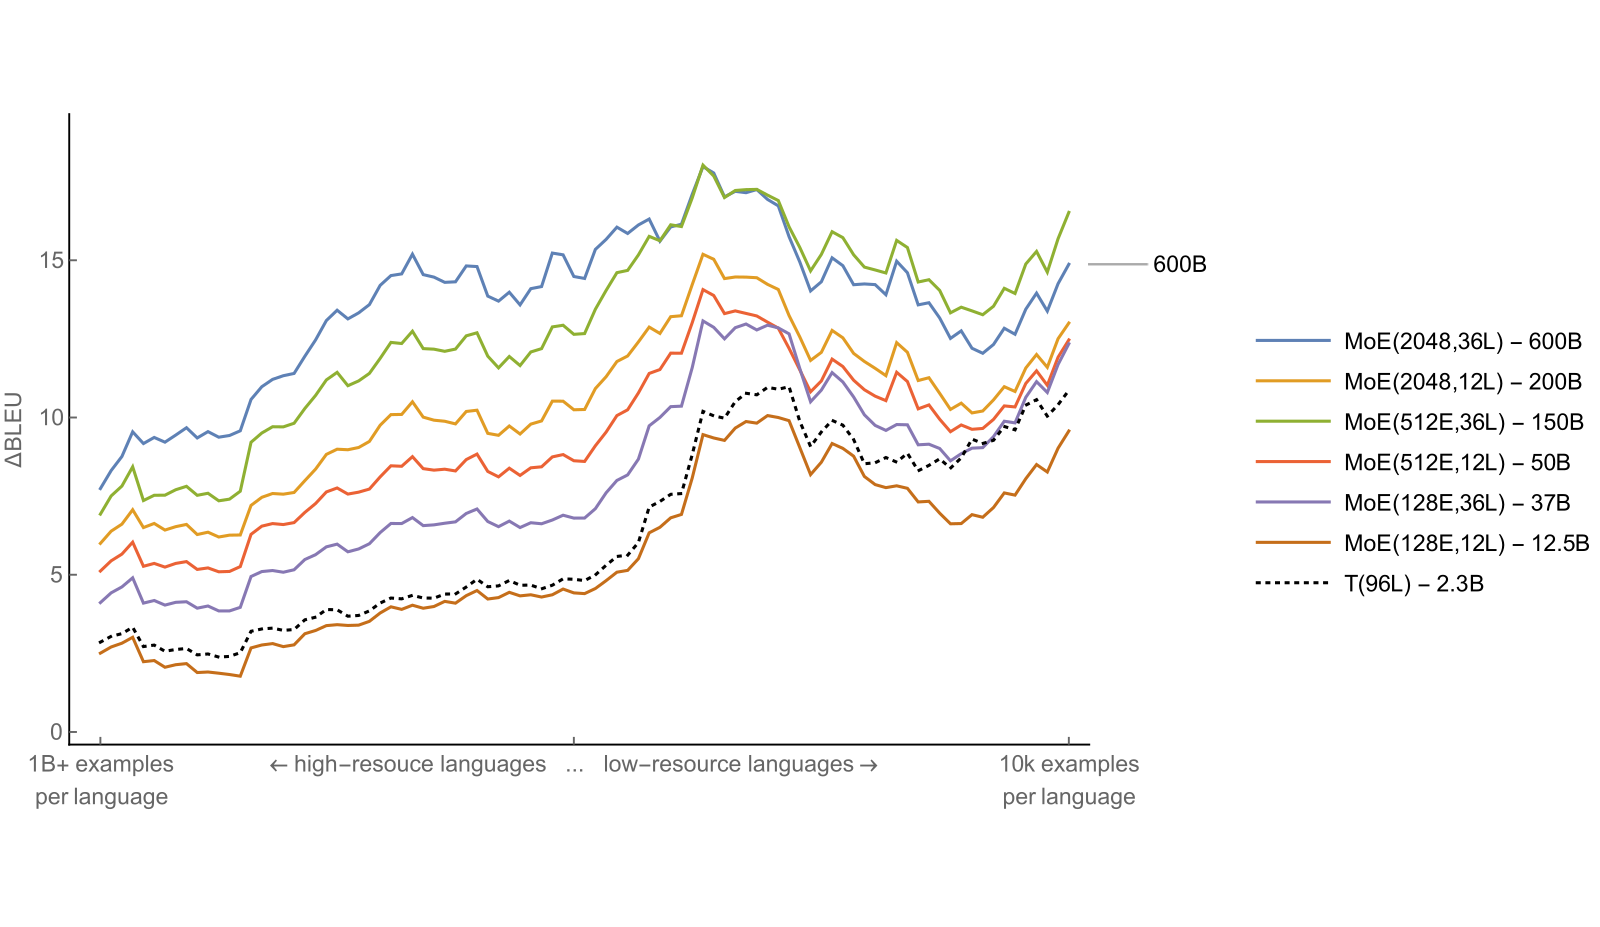
证据三:表2与表3,样本效率不等于时间效率。 128专家12层达到训练交叉熵0.7需995B tokens,36层需321B。更深模型用更少样本达到阈值,但每步工作更多。表3按固定训练量分别列时间与设备成本,正是为了避免把“更少样本”直接译成“更便宜”。
图6还将语言按数据量排序并平滑趋势,显示增加专家与增加深度的收益分布不同。作者把部分现象解释为容量瓶颈与共享迁移的取舍;这是有实验支持的机制分析,但并非对语言相互作用的完整因果证明。
§4.3披露1T模型存在数值稳定性问题,未纳入正式质量结果。它可以作为扩展能力探索,不能与600B主结果并列称为同等可靠的已验证系统。
五、局部容量与负载分配会牺牲部分token路径
代价是大集群需求、内部数据依赖、负载复杂性及极大规模稳定性。后续Switch简化路由、Mixtral探索更易使用的稀疏模型时,都可以回到这些基本约束。
六、沿简化路由与负载通信继续扩展
分片能执行更多专家,路由开销仍可重新取舍。Switch直接把激活选择缩为Top-1;Mixtral后来采用Top-2是同家族不同配方,不能从激活数单独预言质量或吞吐。
自测与参考答案
1. top-2路由意味着每个token一定执行两个专家吗?
不是。第二路由有随机接纳策略,两个候选都受容量限制。实际激活可能更少,溢出token仍通过残差继续传播。
2. 为什么4天训练不能简单称为低成本?
它使用2048个TPU cores并行,累计22.4 core-years。墙钟时间说明完成速度,设备时间更接近资源投入,两者需要同时报告。
3. 平衡损失越强是否越好?
不一定。负载均匀可改善吞吐与溢出,但可能破坏任务需要的专家分工。应联合观察逐语言质量、路由分布与等待时间,而非只优化均匀度。