036 · FiD:先分段阅读,再在解码时融合证据
返回目录 · 上一篇:GPT-3 · 下一篇:GShard
论文:Gautier Izacard、Edouard Grave,Leveraging Passage Retrieval with Generative Models for Open Domain Question Answering,首次公开2020,EACL 2021。原始论文。
先接住前作的问题
RAG在文档条件生成概率之间边缘化,但多篇证据还可以在表示层同时进入解码器。本篇组合DPR和T5式生成器,让编码阶段各读各的、生成时一起读;这是不同的融合路线,不是把RAG的候选数简单调大。
五个前置概念
五个前置概念是:双编码检索先选段落,编码器产生token表示,交叉注意力让输出读取输入,教师强制使用正确答案前缀,EM按规范化字符串判分。理解后应能辨别三种融合:拼接原文早融合、RAG概率融合、FiD解码器表示融合。
一、问题设定:一百段候选怎样共同支持答案而不先做全篇交互
检索器召回许多段落后,全部拼接会造成编码端跨段平方交互,逐篇生成再投票又可能丢失联合线索。开放域问答仍以问题和外部维基百科为输入、短答案标签为监督;本篇要把可并行的逐段读取与共同生成分开。
相较于 DPR 的抽取阅读器,FiD 不要求输出对应单个原文跨度。相较于 RAG,它不把各文档条件下的答案概率分别边缘化,而是在解码器内部融合表示。二者都结合检索与生成,却解决了不同的融合问题。
论文的主要假设是:独立编码仍能保存足够证据信息,解码器的交叉注意力能够有效利用大量候选。这个设计降低了编码阶段的跨段落计算,但也把跨文档整合责任集中到输出端。
二、推导独立编码与联合解码的不同成本
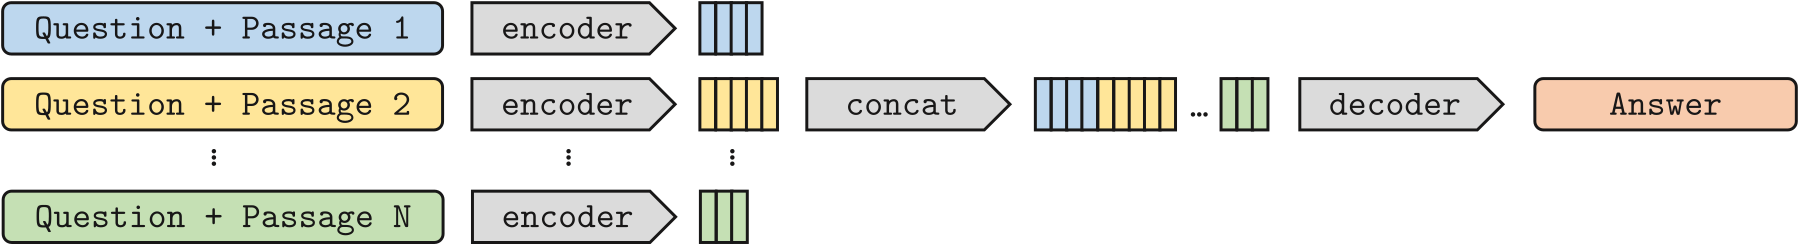
设问题为 ,检索段落为 ,每段带标题。模型将问题重复拼入每个段落输入,再用共享编码器处理:
解码器生成答案 :
是一整段token表示,不是DPR使用的单个检索向量。分号表示拼接。共享编码器不等于把每段独立训练一个模型;每段使用同一套权重,只在自注意力计算上隔离。
若每段长度约 ,独立编码的注意力配对约为 ,全部拼接则约为 。解码器仍需访问约 个位置,短答案长 时交叉注意力约为 。线性于段落数的说法假设每段与输出长度固定,并不意味着一百篇文档免费。
证据何时开始相互交流
k篇文档各长m,独立编码时self-attention的成对项约为 ;若全部拼成一个编码序列,约为 。FiD把跨文档交互延后到解码器:长t的答案查询全部km个编码位置,cross-attention约为 。省下的是编码端跨文档二次项,不是生成器完全不再为文档数量付费。问题在每篇输入中重复,也应算入m。
教学算例。 k=10、m=100时,独立编码的注意力成对项约10万,拼接编码约100万;答案长20时,还需约2万次查询—证据位置交互(均忽略层数、头和维度)。两段证据各含一个关系时,解码器能联合读取;若所需文档未被检索到,后端融合不能证明或补造那条事实。
自构问题:“哪位作家写的小说后来改编成某部电影?”段落A给出电影与小说关系,段落B给出小说作者。FiD解码时可以访问两个段落的表示,输出作者名字。编码器本身没有跨段交互,跨文档关系必须由解码端处理。
把融合发生的位置写成一个尺寸账本
自构取3篇段落,每篇4个编码位置,分别编码得到三份4×d表示;解码器交叉注意力读取拼接的12个位置。编码阶段没有12×12的跨段自注意力,解码阶段却可在同一步给来自不同段落的位置权重。减少编码交互没有删除最终读取多段证据的路径。
教法联系:Jay Alammar的The Illustrated Transformer。算例为本文自构。
三、重复问题编码候选,训练同一个证据读取解码器
输入:问题q、答案y、固定检索系统、预训练T5
    检索K个候选段落
    对每个段落构造 question / title / context 文本
    截断至指定长度,分别通过共享编码器
    沿序列维拼接全部编码输出
    解码器对拼接表示做交叉注意力
    训练时用正确答案前缀,优化答案负对数似然
    推理时贪心生成,按问答协议规范化输出
输出:生成式答案
原论文不以这个答案损失联合训练一个全新的检索器。DPR或BM25提供候选,FiD研究重点是读取方式。把后续检索器蒸馏或端到端检索改进加入此处,会混淆原始贡献。
四、用候选数和训练适配实验区分召回与融合
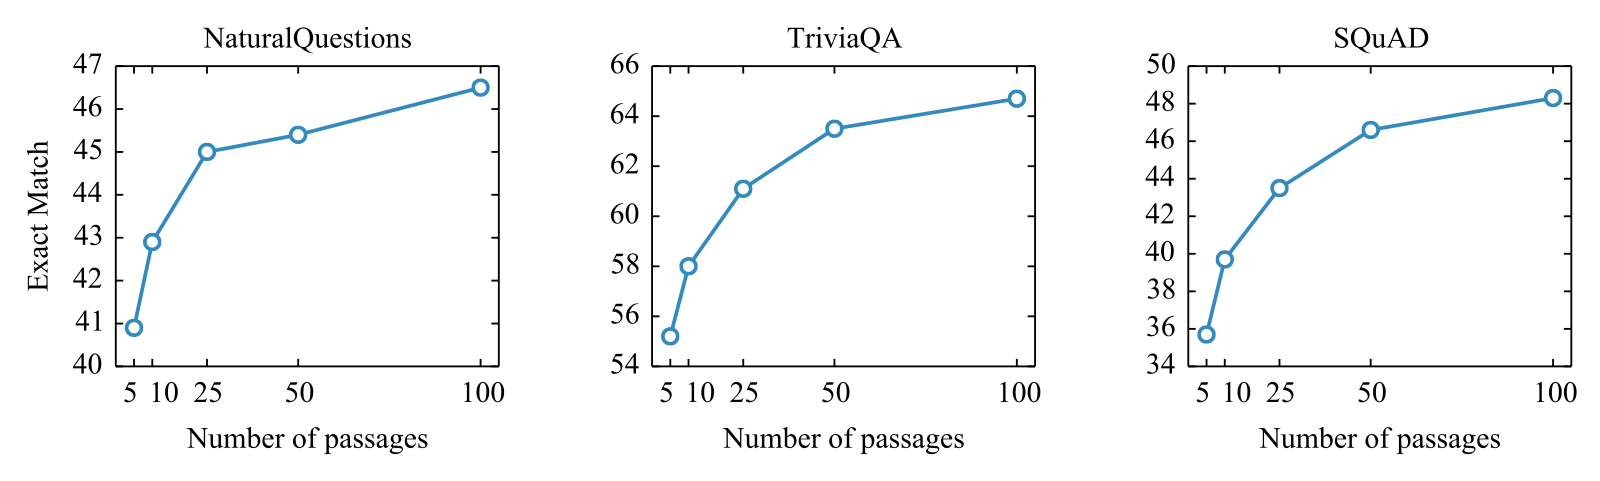
候选越多既可能提高召回也可能改善融合,要按图3与训练段数消融区分。
| 项目 | 原文设置及需要注意的条件 |
|---|---|
| 任务 | Natural Questions、TriviaQA、SQuAD Open;采用相应开放域版本与划分 |
| 知识库 | NQ/TriviaQA使用2018年12月维基百科,SQuAD使用2016年版本;100词不重叠段落 |
| 模型 | T5-base约220M、large约770M,每个任务独立微调 |
| 预算 | 10k梯度步、批量64、学习率、dropout0.1;64张32GB V100 |
| 候选 | 默认训练和测试均100段,每段输入截断250 wordpieces;NQ/TriviaQA用DPR,SQuAD用BM25 |
| 模型选择 | 每500步按验证集EM选择;生成采用贪心解码 |
| 评价与不确定性 | 规范化后EM,SQuAD也报F1;主表没有统一多种子置信区间 |
100词是文档库切块口径,250 wordpieces是模型输入截断口径,不能互换。问题与标题也进入编码序列,因此检索段落短不意味着全部输入都只有100个token。
论文更换不同任务的检索器,是依据已有观察选择可用系统,不是对所有任务使用完全相同检索条件。比较模型参数时也应加上预训练、索引、检索成本,不能把“770M模型胜过更大闭卷模型”解释成总资源必然更低。
另一项对照是把两条证据分别放进同段与不同段,保持总token数一致。若分段后明显下降,说明跨文档融合仍是瓶颈;若两种都失败,则可能是推理任务本身过难。这比单纯把K扩大到数百更能定位问题。
证据一:图2与表1,融合方式的可用性。 图2明确独立编码、联合解码结构。表1中FiD-base和large在NQ的EM分别48.2、51.4,所列RAG为44.5。结果支持这一系统配置有竞争力,但跨系统的骨干、检索数与训练不同,差值不能全部归于一种注意力连接。
证据二:图3,增加段落是否有用。 在验证集、base模型上,候选从10增加到100时,NQ与TriviaQA准确率继续改善。作者据此认为生成模型善于整合多段落证据。不过实验同时提高了相关段落被召回的机会;没有控制证据召回时,曲线不能单独证明模型进行了真正的多跳推理。
证据三:表2,训练时的候选数不能忽略。 测试固定100段,训练只用5段时NQ为37.8;额外以100段训练1000步后达到45.0。部分先少后多的方案可在147 GPU小时达到46.0,对比全程100段训练约425 GPU小时、46.5。它揭示输入分布适应与训练成本的取舍,而非证明少段训练永远无损。
表2的分数是开发集,而表1是最终测试比较;不能把46.5与51.4当成同模型、同集合的直接提升。图3改变训练与测试段落数,表2则重点研究训练候选数变化,两组实验的问题不同。
五、更多材料也会带来歧义、噪声与交叉注意力成本
如果段落C提供同名小说的另一作者,更多材料可能带来歧义。可构造未执行实验,固定必需的两条正确证据,只增加无关段、近似实体段或矛盾段,观察EM与引用支持率。这样能把“召回更多证据”和“抵抗更多噪声”分开。
注意力权重也不能直接充当证据归因。解码器关注某段落,可能只是利用其词形或格式;要确认答案依赖,应删除或替换关键事实,再观察输出变化。这里是进一步分析建议,不是原论文已经报告的忠实性保证。
限制包括候选噪声、较大训练资源、缺少直接事实保证,以及长答案时交叉注意力成本上升。
六、从联合读取走向检索决策与支持性检查
多段融合越多,证据位置与干扰越值得检查。Lost in the Middle提供控制位置的诊断;Self-RAG则在生成中判断相关与支持。编码成本下降并未自动解决这两种读者失败。
自测与参考答案
1. FiD与RAG-Token的融合有什么根本差别?
FiD的解码器一次读取所有段落表示,内部形成联合预测;RAG-Token组合各单文档条件下的下一词概率。前者是表示交互,后者是概率边缘化。
2. 更多检索段落提高EM,是否证明多跳推理更强?
不能。也可能只是更容易找到包含完整答案的单篇段落。需要固定召回并要求多个事实共同支持答案,才更接近验证多跳整合。
3. 为什么训练5段、测试100段可能不如始终100段?
解码器面对的噪声量、候选竞争和注意力分布改变了。表2显示少量多段适配能缩小差距,说明训练输入分布本身是方法的重要条件。