032 · DPR:把海量文档检索变成可学习的向量搜索
返回目录 · 上一篇:ELECTRA · 下一篇:Longformer
论文:Vladimir Karpukhin 等,Dense Passage Retrieval for Open-Domain Question Answering,EMNLP 2020。原始论文。
先接住前作的问题
REALM用最终预测收益学习检索,但检索器也可以直接利用问答配对监督。本篇沿这条平行路线,用可预计算双编码器缩小候选库,再训练阅读器;后来的RAG和FiD把它当作模块组合。
五个前置概念
五个前置概念分别是:倒排索引用词查文档,双编码器独立表示两端,内积衡量可学习匹配,批内负例复用已有编码,EM检查答案完全一致。理解这些之后,读RAG时就能分清检索表示来自哪里,以及生成器究竟在联合优化哪部分。
一、问题设定:问题与证据措辞不同,怎样仍在大库中找回答案段落
问题可能问“英格兰和爱尔兰之间是什么水域”,证据却只写“爱尔兰海”。检索器要从大段落库召回少量候选,再由阅读器提取答案跨度;不能让昂贵阅读器逐一交叉编码整部百科。本篇利用监督问答与独立编码兼顾语义匹配和索引效率。
稀疏检索 BM25 擅长精确词匹配,难以直接处理同义改写。交叉编码器把问题与段落一起送入 Transformer,能做细粒度交互,但对数千万段落逐一计算过于昂贵。DPR 以独立编码换取可索引性,再把昂贵交互留给少数候选。
因此存在两个假设:单个固定长度向量能保存足够的检索信息;训练中的相关性监督能迁移到实际查询。对于冷门型号、罕见实体或领域迁移,这些假设可能失效。DPR 不是一个保证语义理解完整的搜索引擎。
二、由双编码打分推导负例集合的学习压力
令问题编码器为 ,段落编码器为 ,打分为:
给定问题 、正段落 和负例集合 ,优化:
这个 softmax 在当前候选集合中把概率推向正段落,并不直接计算全库的归一化概率。因此负例如何取样非常关键:随机文章容易排除,含相同词却答错问题的段落更能约束决策边界。
批内负例复用同一批其他问题的正段落。若批量为 ,一次编码能构造近似 的配对分数矩阵,不需为每个问题单独编码大量新段落。论文还加入 BM25 高排名但不含答案字符串的段落作为困难负例。这种定义仍可能产生假负例,例如文本以另一种说法给出了正确答案。
检索梯度为何取决于负例集合
对某问题的正例分数 与负例分数 做softmax,归一化概率记为 ,损失 是 ,因此 ,负例梯度为 。已被模型排很低的随机负例几乎不提供信号,词面相似却不含答案的BM25负例更可能暴露错误边界。双编码器让文档可预计算,却也限制查询和文档只能在打分阶段通过低成本函数交互。
教学算例。 正例与一个负例分数为2和0时,正例概率0.881,梯度−0.119;加入分数3的困难负例后,正例概率约0.245,梯度−0.755。学习压力大幅变化;若该“负例”实际也能回答问题,强梯度便会把正确证据推远。因此更多in-batch负例不自动等于更可靠监督。
把一个batch写成检索分类题
一个batch有3个问题和各自正段落,查询与段落两端独立编码后得到3×3分数矩阵。对第1行归一化,正项是第1列,其余两列作为负例;换batch就会改变这行分母。若另一个问题的正段落也能回答当前问题,它便可能成为假负例,批内负例不是自动正确的人工标签。
教法联系:Jay Alammar的The Illustrated Word2vec。算例为本文自构。
三、预计算段落索引,再分别训练检索器与阅读器
输入:问题与正段落对、BM25负例、预训练双编码器
每个训练批次:
    编码所有问题 Q 和正段落 P
    编码每个问题对应的困难负段落 H
    对每个问题计算与批内 P、H 的内积分数
    将自己的正段落设为目标,计算候选softmax损失
    更新两个编码器
训练后:
    用段落编码器计算全库向量,建立近似内积索引
    查询到来时只编码问题,搜索top-k段落
    阅读器对候选进行交互编码并提取答案跨度
输出:候选证据和答案
检索器损失改善的是候选区分;算法机制改善的是语义匹配及计算可分解性;实验指标则分别是 top-k 检索准确率与最终 EM。三者相关,但不能互相替代。阅读器可能看到了正确证据却抽错答案,也可能证据库本来就缺少相关内容。
四、同时保留NQ收益、SQuAD退步与负例消融
召回提升需要传到EM才有系统价值,失败数据集与困难负例数量的非单调性都应保留。
| 项目 | 设置与解释 |
|---|---|
| 文档库 | §4.1将维基百科处理成21,015,324个不重叠100词段落,并加入文章标题;不是100个子词 |
| 问答集 | Natural Questions、TriviaQA、WebQuestions、CuratedTREC、SQuAD |
| 训练样本 | 表1区分原始数量与过滤后数量,例如 NQ 原始79,168、实际58,880;不能忽略过滤影响 |
| 训练预算 | 检索批量128,每问额外1个BM25负例;大数据最多40轮、小数据100轮,学习率 |
| 对照 | BM25、DPR、两者线性组合;单数据集与多数据集训练分开 |
| 指标 | top-k中是否至少有包含答案的段落;最终问答使用规范化后精确匹配 |
| 资源与重复 | §6报告8张32GB GPU;主表未提供统一跨随机种子的置信区间,不能声称所有差异显著 |
“含答案字符串”是可扩展的检索评估代理,既不保证段落真正支持答案,也可能漏掉同义表达。多数据集设置给小任务增加了监督资源,因此不能与单数据集结果当作同预算比较。
可以构造一个未执行的诊断集:一半问题做同义改写,一半只改变型号或年份,保持答案证据不变。比较BM25、DPR和混合方式的召回、阅读准确率及索引成本。若DPR只在改写题更强,就应给结论加上任务条件;若混合召回提高却EM下降,要检查候选噪声和阅读器排序,而不是马上扩大检索数量。
证据一:表2,稠密检索的收益与例外。 NQ单数据集训练时,BM25的top-20准确率59.1,DPR为78.4,绝对增加19.3个百分点。SQuAD却由68.8下降到63.2。证据支持多数所测任务的提升,同时直接否定“语义检索必然全面替代词项检索”。论文讨论SQuAD的问题构造和数据分布特殊性,这属于解释线索,不是对所有失败的完整归因。
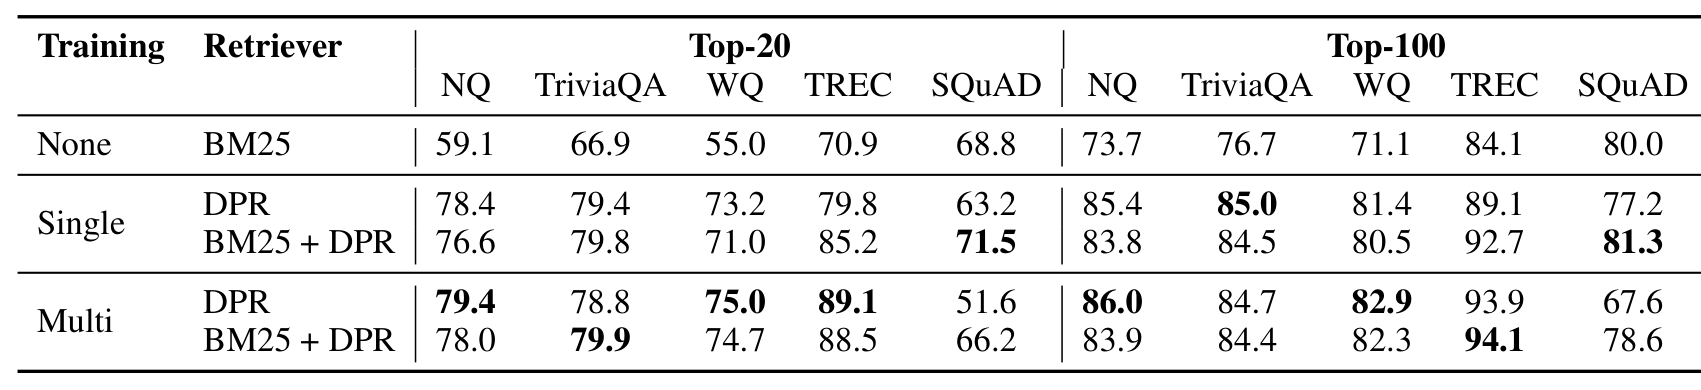
证据二:表3,负例与批内复用。 NQ开发集使用7个其他问题正段落作为负例时,非批内训练top-20为63.1,批内版本69.1;批内配置再加入困难负例能进一步改善。这个结果支持训练配对构造的重要性。表中也显示加两个困难负例并不一定好过一个,所以“负例越多越好”没有得到普遍支持。
证据三:表4,检索改善能否传到答案。 作者系统在NQ上,BM25对应最终EM32.6,DPR为41.5,增加8.9个百分点。但SQuAD同样出现退步。这说明召回与问答能力需要一起评估;表4来自其他论文的结果区块包含不同预训练和阅读器资源,不能把所有差值归因于检索器一项。
§5.4还揭示被在线延迟掩盖的成本:全库向量计算约需8张GPU运行8.8小时,索引构建另需约8.5小时,而Lucene倒排索引构建约30分钟。这些是当时特定配置的报告,不能作为今天服务延迟保证;它们说明索引刷新频繁时,总拥有成本可能改变选择。
五、假负例和精确型号会暴露向量压缩限制
自构例子:问题是“设备ZX-17的额定电压”。BM25能够紧抓型号,而稠密模型可能召回同类设备的通用说明。若题目换成“这台设备需要多大供电”,语义匹配又可能更有帮助。混合检索的价值来自错误类型不同,而不是把两个分数随便相加就必定改进。
还应检查过滤出的训练问题是什么类型。若BM25无法找到含答案正例的问题被丢弃,训练集合已经受到词项检索的选择偏差;这不推翻实验,但影响对真正低词汇重叠问题的外推。索引更新后也要保证新旧段落使用相同编码器版本,否则内积不再处于统一表示空间。
它付出的代价包括标签构建、假负例、向量存储、索引维护,以及单向量表示压缩细粒度关系的损失。
六、把可索引检索模块接入生成系统
检索到正段落后,生成器还需使用它。RAG与FiD分别讨论潜在文档混合和多段解码融合;检索召回是必要诊断,却不能代替最终答案评价。
自测与参考答案
1. 为什么不直接用交叉编码器检索全部段落?
每个新问题都需要与每个段落重新进行注意力交互,无法预计算问题无关的匹配向量。双编码器把全库工作移到离线阶段,交叉编码器适合少量候选重排。
2. 批内其他正段落一定是当前问题的负例吗?
不一定。相近问题可能共享答案证据,形成假负例。批内训练便宜且有效,但需要考虑重复问题、共享事实和数据构造带来的冲突。
3. top-20提高而最终EM下降,应先排查什么?
检查召回段落是否真正支持答案、阅读器是否能处理新候选分布、噪声是否干扰排序,以及答案字符串匹配是否夸大召回。增加候选数量不能自动解决这些问题。