034 · RAG:让生成模型在参数记忆之外查阅证据
返回目录 · 上一篇:Longformer · 下一篇:GPT-3
论文:Patrick Lewis 等,Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,NeurIPS 2020。原始论文。
先接住前作的问题
DPR能找候选,但抽取阅读器要求答案以合适跨度存在。把BART的生成接口接进来可以组合和改写,同时也扩大编造空间;本篇组合两模块,并承接REALM的潜在文档边缘化,研究最终答案怎样监督检索。
五个前置概念
五个前置概念是:潜变量代表未直接标注文档,边缘化对可能证据求和,DPR提供可索引检索,编码器—解码器生成条件文本,参数记忆与外部记忆划分知识存储位置。理解这些后,再读FiD可以看清“概率层面融合”与“表示层面融合”为什么不同。
一、问题设定:检索候选怎样支持可改写、可组合的生成答案
检索找到材料后,抽取一个文本跨度未必足以回答需要改写、组合或分类的问题。生成器可在问题与证据条件下输出答案,却也可能自由编造;本篇将检索文档作为潜变量,把不同文档支持生成的概率纳入同一训练目标。
RAG 把 BART 的参数称为参数记忆,把外部向量索引称为非参数记忆。这并不意味着外部系统没有参数:文档编码器当然是神经网络;“非参数”强调事实内容存储在可替换文档集合中,而不是全部压进生成器权重。
输入为问题或其他任务文本 ,目标输出序列为 ,外部候选文档为 。训练数据通常提供输入—输出对,而当前任务训练不要求标注应检索哪篇文档。不过检索器由有监督 DPR 初始化,因此“无需当前任务证据标签”不能改写为“从未使用检索监督”。
二、比较文档求和放在序列外还是逐token内部
检索器 根据问题向量与文档向量的内积评分。生成器 读取问题、一个文档和已有答案前缀。RAG-Sequence 的近似概率为:
这里先对每篇文档计算整段答案的概率,再加权求和。RAG-Token 则把求和放到乘积内部:
区别是潜在文档能否随输出位置变化,不是每生成一个词都必须重新向外部搜索引擎发请求。原方法基于输入检索候选,再在这些候选上组合词概率。求和与乘积一般不能交换,所以两者不是等价实现。
训练最小化正确输出的负对数边缘似然。如果某段落能帮助生成正确答案,它得到更有利的学习信号。但候选截断及近似搜索不等于对整个离散检索过程完整求导,检索遗漏仍可能让有用文档得不到机会。
求和与连乘交换会改变模型
对两token答案,Sequence计算 ;Token计算 。r为文档检索权重,a为给定该文档和相同合法前缀的目标token概率。后者展开后包含跨文档组合项,前者要求一篇文档支持整条生成路径。Token模型可逐token切换潜在文档,不代表每个token都重新调用搜索更新候选库。
教学算例。 两篇文档各占0.5,分别对两步目标给出概率 与 。Sequence答案概率为0.09,Token为 。这不是“Token一定更好”的证明:跨文档结合也可能把互相冲突的实体拼成错误答案。
自构问题:“某研究者在哪一年获得奖项?”文档A描述研究者身份,文档B给出奖项年份。Token边缘化允许不同输出位置依赖不同候选,但并不显式维护可验证的推理链,也不自动生成对应引用。
用两步输出检验文档是否能切换
两篇文档分别只支持输出的第一段和第二段时,序列级混合要求同一潜在文档解释整条序列;token级混合则可在每一步重新加权不同文档。两者即使检索概率相同,也会给联合输出不同概率。实现检查应使用这种“各自只支持一半”的反例,不能只用单篇始终占优的样本。
教法联系:Lilian Weng的Extrinsic Hallucinations in LLMs。算例为本文自构。
三、组合DPR和BART,固定检索候选与生成协议
输入:任务(x,y)、DPR查询编码器、固定文档索引、BART生成器
每次更新:
    编码x,从索引检索top-k文档
    计算候选文档的归一化检索权重
    对每篇文档分别计算条件生成概率
    按Sequence或Token定义边缘化
    计算正确答案负对数似然
    更新查询编码器和生成器;保持文档编码器与索引固定
推理:
    检索候选,采用相应概率组合与解码近似输出答案
输出:生成答案;引用忠实性需要另外评价
固定文档侧避免了训练时反复为全库重编码,这也是它与 REALM 部分训练机制的重要区别。Sequence 解码需处理跨文档的完整候选序列分数,论文给出 Thorough 与 Fast 两种近似;Token 形式更容易接入逐词解码。
四、按问答、检索训练、事实性与索引变化分别读证据
主问答表之外,还要读检索是否学习、事实性人工判断与候选数量曲线。
| 项目 | 原文设置与含义 |
|---|---|
| 知识库 | 2018年12月维基百科,约2100万个不重叠100词段落;FAISS近似内积索引 |
| 模型 | DPR检索器初始化,BART-large约400M参数生成器;训练查询端与生成器 |
| 任务 | NQ、TriviaQA、WebQuestions、CuratedTREC开放域问答,MS-MARCO生成问答、Jeopardy出题、FEVER分类 |
| 训练预算 | 附录C使用8张32GB V100,混合精度;候选数5或10,任务分别微调,不能用单个统一步数描述全部任务 |
| 推理预算 | 附录A开放域测试Token检索15篇、Sequence检索50篇;生成任务用10篇与beam4 |
| 指标 | 问答EM,生成BLEU/ROUGE及人工事实性,FEVER标签准确率;不同指标不可互换 |
| 不确定性 | 人工评价有452对生成样本;主任务表没有统一的跨种子置信区间,人工协议见附录B |
模型参数较少不等于系统资源较少。外部索引需要内存、磁盘和构建成本,多文档生成要重复条件计算。闭卷模型与开卷模型获取的信息不同;两者比较回答的是系统方案能力,不是隔离参数数量的纯粹实验。
还应分别测“检索命中但答错”和“未命中却答对”。后一类可能来自参数知识,不应自动计为检索的成功;前一类则提示阅读或整合问题。单看最终EM无法定位改进应该发生在检索器还是生成器。
证据一:表1,开放域问答。 NQ上DPR系统EM41.5,RAG-Token为44.1,RAG-Sequence为44.5。改善说明生成式读取与检索组合有价值,但两种RAG测试文档数不同,不能把0.4分差值直接解释为Sequence机制更优。TriviaQA还含两种测试口径,引用数值必须说明是哪一列。
证据二:表6,检索是否需要学习。 NQ开发集RAG-Token固定检索器为37.8,可训练检索器为43.5;Sequence为41.2与44.0。这支持让任务目标调整查询表示。FEVER上BM25方案反而更强,显示实体密集型词项匹配有优势,不能把稠密检索视为所有知识任务的默认胜者。
证据三:表4与附录B,事实性需要人工评价。 Jeopardy生成比较中,人工判断RAG更事实准确的比例42.7%,BART更好的比例7.1%。这是成对偏好比例,不是RAG的绝对事实正确率。表中还存在双方都差与无多数意见,不能把42.7%直接当作错误减少率。
证据四:§4.5索引替换与图3。 作者用82个发生变化的领导人职位问题,比较2016和2018索引,展示替换外部记忆能改变回答。该结果支持知识更新的可能性,不证明所有新事实都能可靠覆盖参数记忆。图3也显示增加文档并非对每种模型和指标都单调有益:更多候选既增加信息,也增加噪声与成本。
这张图3测的是文档数,不是年份替换。 三幅横轴都是检索候选数K;左幅为NQ答案精确匹配,中幅为答案召回率,右幅为生成的BLEU-1与ROUGE-L。中幅召回继续上升时,左幅RAG-Token的最终答案分数仍可能回落:找到更多含答案的文档,与生成器正确使用它们,是两个环节。
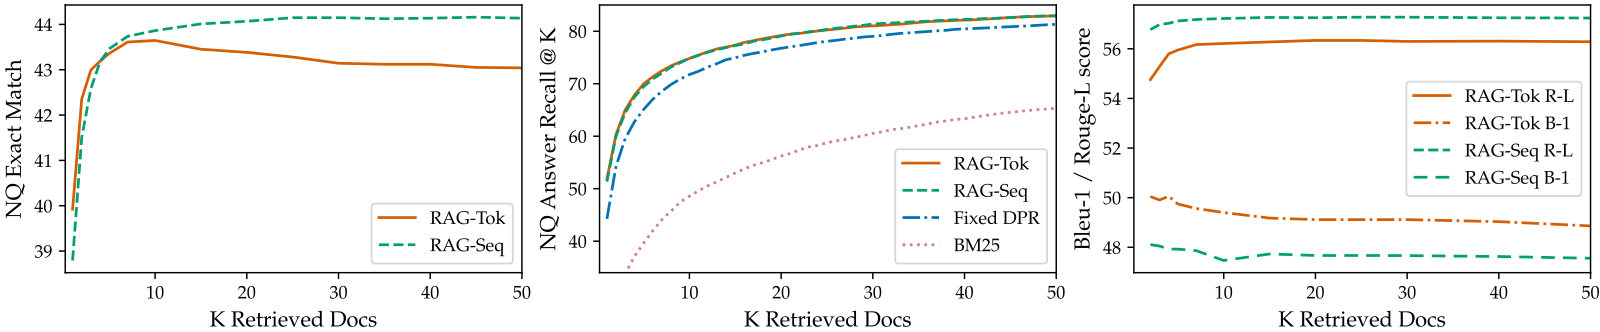
原文§4.3文字中“双方事实正确”的比例与表4出现不一致:表4是11.7%,邻近正文写17%。讨论该项时应明确依据版本与表格,不能把矛盾悄悄合并为一个确定数字。上述主要结论使用两处一致的42.7%与7.1%。
五、外部文档与参数记忆冲突时答案仍可能不忠实
如果参数记忆记着旧年份而检索给出新年份,最终答案可能仍采用旧知识。一个未执行实验可以构造可控的虚构人物事实,分别设置正确证据、过时证据、矛盾证据和无证据四种条件;测准确率、证据依赖率、错误自信以及延迟。使用虚构实体有助于减少预训练记忆干扰,但其结果仍不能完全代替真实世界测试。
它仍受知识库覆盖、索引陈旧、文档可信度、生成幻觉和推理预算限制。外部证据为核验提供了条件,却不构成自动的事实保证。
六、把本篇机制再推进一步
1. 两篇文档各支持答案的一部分,Token边缘化就一定能形成正确整体吗?
参考答案:不一定。乘积展开包含跨文档组合,但组合可能把不同实体或互相冲突的事实拼接。正文数值例只证明两个概率模型不同,不能证明Token普遍更好;需固定候选与预算,再检查跨文档一致性和最终答案支持。
七、从概率边缘化转向表示层联合读取
文档混合仍会遇到不必要检索与无支持生成。Self-RAG直接增加可学习判断;GraphRAG扩展到全库主题覆盖。前者检查使用证据的方式,后者检查取到的资料是否有代表性。
自测与参考答案
1. RAG-Token是否每个词都重新检索?
原定义不要求如此。候选由输入检索,逐词变化的是候选文档条件下的概率组合与后验依赖。把它等同实时逐词网络搜索会误读算法成本。
2. 为什么不能宣称RAG完全没有检索监督?
当前任务联合训练可仅用输入—输出对,但初始化的DPR已经使用问答相关性监督。应该区分初始化资源与当前微调所需标签。
3. 给答案附上一篇检索文档,就能保证引用忠实吗?
不能。模型可能未依赖该文档,文档也可能不支持具体句子。需要逐项证据核验、引用准确率或证据替换实验,不能用检索存在代替支持关系。