033 · Longformer:长文本不必让所有词两两相看
论文:Iz Beltagy、Matthew E. Peters、Arman Cohan,Longformer: The Long-Document Transformer,2020。原始论文。
先接住前作的问题
Transformer直接连接位置,却带来平方数量的交互;RoBERTa的强短编码器也不能仅改长度参数就读取长文。本篇直接改连接图,并研究如何迁移既有权重,留下的是可达性、训练适配与执行效率三项不同检验。
五个前置概念
五个前置概念是:自注意力按内容聚合信息,感受野描述能访问的范围,全局词提供全文连接,绝对位置嵌入区分顺序,BPC用以比特表示预测损失。掌握后可以与BigBird的随机连接、Performer的核近似分别比较,而不要都称为同一种“线性注意力”。
一、问题设定:怎样保留长文证据而不计算全部位置对
文档标签证据可能在末尾,多跳问答线索又可能跨段落。截断会丢信息,独立分块缺少跨块交流,扩大完整注意力则产生大量位置配对。本篇以局部窗口加少量全局位置保留路径,检验节省成本后哪些长文能力仍可学到。
设序列长 、隐维度 ,全注意力的配对运算通常为 ,分数矩阵为 。这不意味着整个网络只有这一项成本:前馈层、投影和激活也占资源,所以注意力变成线性后,整机速度不会自动按理论比例提升。
Longformer 属于模型架构与系统效率研究,没有环境状态、动作或奖励。输入是长序列,输出随目标而变:语言模型预测字符,预训练编码器恢复遮盖词,微调模型完成问答或分类。
二、从局部与全局边推导可达范围和复杂度
为位置 定义局部邻域 ,全局位置集合为 。普通位置能够访问 ;全局位置能够访问所有位置。用掩码表达单个注意力头:
输出为 。这个式子解释允许哪些连接;实际实现不能先生成完整 矩阵再遮盖,否则节省内存的意义就消失了。论文为局部和全局连接使用不同投影,教学式省略了这一参数区分。
若窗口大小 与全局位置数 都固定,连接数量约为 。如果把所有词设成全局位置, 随 增长,又回到了平方规模。因此“线性复杂度”有明确条件。
局部窗口叠多层后,信息可以逐步传播到更远处;全局词则提供较短路径。分类可让特殊汇总词连接全文,问答可把问题词设为全局。这不是由测试答案指定位置,不应引入答案所在段落的特权信息。论文也讨论膨胀窗口,但从 RoBERTa 迁移的配置并非所有连接变体都获益。
教学算例。 长度1024、每侧r=2、4层纯局部网络,位置500最多接触492到508附近信息;相距100的事实仍不可达。加入全局问题token后拓扑距离缩短,但若问题token把两个同名人混淆,信息虽到达仍会读错。实验应拆成“边是否允许”和“模型是否学会利用边”两个检查。
自构文档第一段说“项目负责人是林某”,最后一段说“负责人签署最终许可”。要回答谁签署,短截断可能只看到一端。局部窗口让相邻句先整合信息,问题的全局位置再从全文收集相关内容。
两层窗口的感受野不能当作一层注意力
在无全局节点、单向距离半径1的示意图中,位置5一层可接收4、5、6,两层才可能经4接到3。信息到达需经过中间表示的压缩与非线性,不能当成位置5直接对3计算原始注意力分数。全局连接改变路径长度,局部窗口叠层改变间接可达范围,二者应分别测试。
教法联系:Lilian Weng的The Transformer Family。算例为本文自构。
三、实现稀疏算子并迁移短模型的位置表示
输入:长序列x、每层窗口、任务指定的全局位置G
对每层:
    为局部和全局注意力计算所需投影
    对普通位置,仅计算窗口及全局位置的分数
    对全局位置,计算与整段序列的双向连接
    在各自允许位置上归一化并聚合value
    执行残差、归一化与前馈网络
使用任务输出头计算MLM、分类或问答损失
更新参数;在相同连接规则下评估
输出:长文本表示及任务预测
这份流程描述双向编码场景。自回归字符建模还必须限制未来信息;不能照搬双向掩码后报告语言模型困惑度,否则会泄漏预测目标。
RoBERTa 使用有限长度的可学习绝对位置嵌入。扩展到4096时,新增位置若随机初始化,会破坏已有表示。论文复制原有512个位置向量来初始化更长位置表,然后继续预训练。复制是初始化方案,训练后各位置仍可适配,不是宣称每512个词在语义上完全重复。
从旧权重迁移还受到注意力结构兼容性约束。论文提到,在这一路线中加入部分膨胀注意力反而损害表现,可能与预训练权重不兼容有关。这里“可能”是作者解释,不是已被完全隔离验证的因果结论。
可达不等于一层直接看到
若每个位置只读左右各r个邻居,堆叠L层后影响范围最多延伸Lr个位置,路径长度随距离增长。全局token在一层汇入远端信息、下一层再被其他位置读取,可提供两跳通路;但所有远处内容都经少数全局表示压缩,仍有容量与选择瓶颈。论文把全局注意力双向加入,并为其设置独立投影,不能仅在局部mask中随便多开一个位置就称完整复现。
四、分别读内存曲线、字符建模与位置初始化消融
同样连接可有不同内核速度,字符BPC与编码器MLM口径也应分开。
| 项目 | 原文设置与比较目的 |
|---|---|
| 字符建模 | text8、enwik8,以BPC评价;小模型与大模型分组,不能跨组直接比较 |
| 编码器预训练 | 从RoBERTa继续训练,序列4096,批量64,65k次更新;最大学习率,预热500步 |
| 理解任务 | WikiHop、TriviaQA、HotpotQA、OntoNotes、IMDB、Hyperpartisan等,长短分布不同 |
| 基线 | 全注意力模型、其他长序列模型、RoBERTa及初始化消融 |
| 系统指标 | 图1比较时间与内存,同时区分循环、分块向量化、自定义CUDA实现 |
| 任务指标 | 语言建模BPC越低越好;理解任务使用各自准确率或F1,不能与BPC合并平均 |
| 不确定性 | 主表未统一报告所有配置的多种子置信区间;小差异不自动等于稳定优势 |
表6列出任务上下文长度分布。例如TriviaQA的平均长度与长尾都明显超过短编码器常见上限。评价长模型时应同时报告截断比例,否则很难分清收益来自新结构还是单纯保留了更多有效证据。
一个公平版本要控制答案证据是否被截断:先比较所有模型都能容纳的短样本,再比较真正需要长上下文的样本;同时区分同长度计算成本与各自最大长度任务效果。否则两个不同问题会混成一个结论。
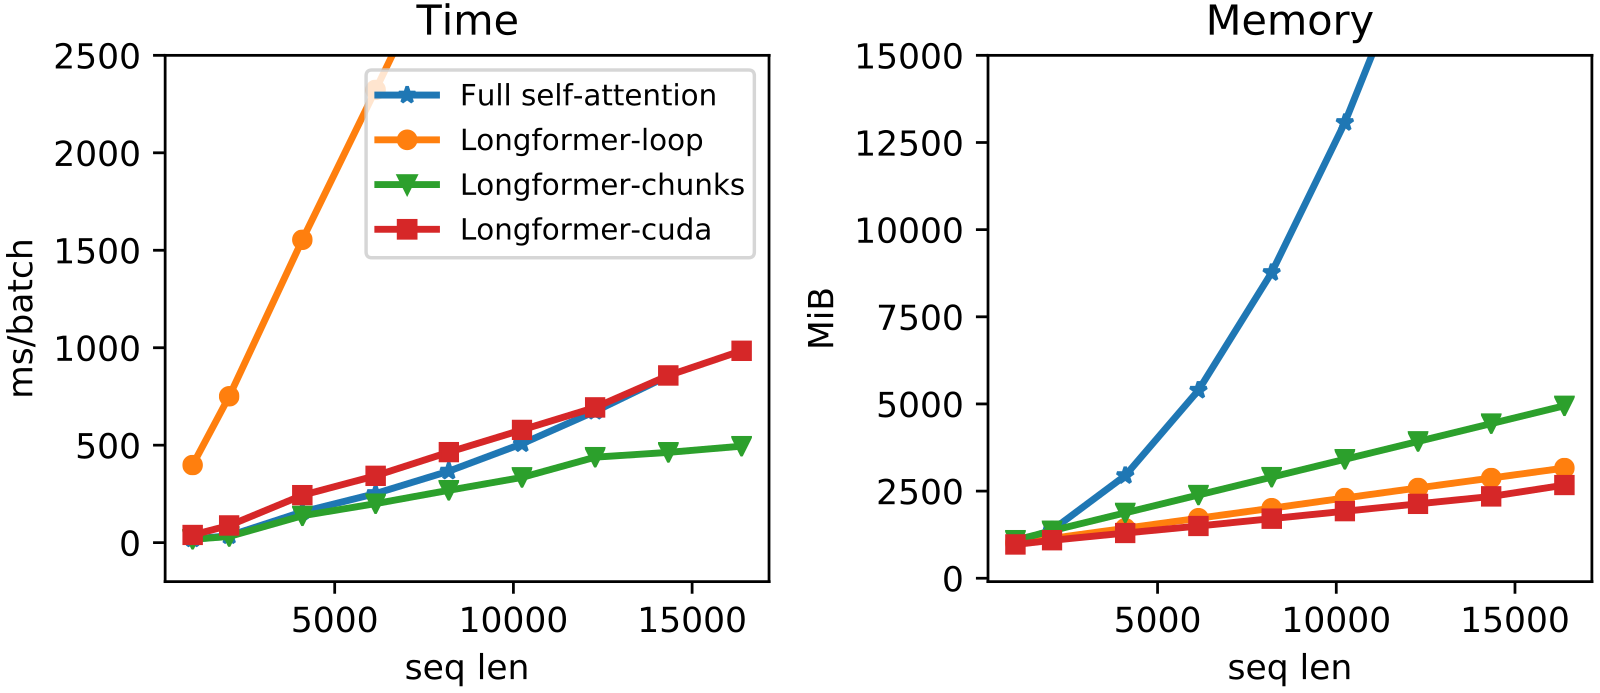
证据一:图1与§3.2,理论连接怎样落到系统。 不同稀疏实现的速度不同,图中分块向量化实现最快;这说明运算图稀疏不等于硬件利用率高。图支持长序列时的内存扩展优势,但不能证明任何长度、任何设备都比高优化的全注意力快。 图中还区分 loop、chunk 和 CUDA 实现。相同稀疏连接模式可以有不同运行时间,内存的线性趋势不能单独预测哪种内核最快。
证据二:表2与表3,建模能力并未因稀疏连接消失。 小模型在text8和enwik8测试BPC分别1.10、1.00。表3大模型enwik8为0.99,与部分类似规模稀疏模型相当,而更大模型可以更好。证据支持效率与建模质量之间可取得有用平衡,不支持它在所有参数预算下支配其他方法。
证据三:表5,位置初始化和继续训练不可省略。 base配置扩展后随机位置初始化的MLM BPC为10.299,复制位置嵌入后降至1.957;继续2k步为1.753、65k步为1.705。这组对照清楚表明,把输入长度参数改大不等于得到可用长模型。这里的BPC是该MLM评估口径,不能与字符自回归表2的BPC直接横比。
作者报告更长输入上的多类任务收益,但任务不同,全局连接策略也不同。因此最严谨的概括是“提供了可迁移的长文本编码方法”,而不是“稀疏注意力在任何任务上更准确”。
五、有连接路径仍可能读错关系或压缩细节
但如果几十处都出现同名人物,全局汇总仍可能混淆关系。连接存在只保证信息有传播路径,不保证优化学会正确选择。可以把证据距离逐步拉大并插入干扰段,观察准确率、显存和延迟。这是自构实验方案,未运行时不能画出虚构的退化曲线。
局限包括全局位置设计、长程细节压缩、预训练分布适配,以及稀疏核的工程复杂性。它节省配对成本,却不解决数据是否可信或答案是否忠实的问题。
六、比较稀疏图、随机核近似与精确IO优化
稀疏边让长输入可计算,位置利用仍要实测。BigBird增加随机与全局连接的结构分析,Lost in the Middle则控制证据位置检验读者。它们分别回答可达性与实际使用问题。
自测与参考答案
1. 把全注意力矩阵算完再遮掉大部分元素,能获得论文的内存收益吗?
不能。完整矩阵已经占用平方内存;必须在实际计算与存储上只处理允许的连接,或用相应分块实现避免完整展开。
2. 全局位置越来越多时,复杂度会怎样?
全局连接为,若随长度线性增长,就再次成为平方量级。固定少量全局位置是线性扩展结论的重要前提。
3. 证据在同一篇长文中,就一定能答对吗?
不一定。可访问性、有效利用和正确推理是不同条件。位置训练不足、干扰内容以及信息压缩都可能造成失败,必须用距离与干扰实验检验。