077|Lost in the Middle:上下文装得下,不代表每个位置都用得好
论文:Nelson F. Liu 等,Lost in the Middle: How Language Models Use Long Contexts,首次公开于2023年。论文、正文 v3、作者项目。它是一篇诊断与评测论文,不提出一个已经解决长上下文问题的新训练算法。
怎样把“位置效应”与题目难度分离?
最有解释力的单位是同一道题在不同证据位置上的配对结果。设第 道题的前部、中部条件答对指示量分别为 ,则平均配对差为
是题目数。它测的是这组受控输入上的位置影响,不是任意长上下文的通用衰减率。若给差值做不确定性估计,应以题目为单位保留配对抽样;把同题不同位置当成完全独立样本会丢掉相关性。这是由论文受控位置实验引出的复现建议,不是声称原文实施了这里列出的统计流程。
还要分清文档序号与 token 位置:第 5 篇文档不一定处在上下文正中。长度不同的干扰文档会改变真实偏移,单纯重排编号不能保证控制住 token 距离。
先接住前作的问题
Longformer改善长序列可计算性,RoPE改变位置匹配方式,都未保证窗口中每处证据被同样使用。本篇是评测路线,控制相关文档位置;RAG即使检索成功也会遭遇这一读者瓶颈。
五个前置概念
五个概念:上下文窗口是可输入容量;位置敏感性是内容不变时排列导致的表现变化;检索召回衡量所取文档是否包含答案;读者准确率衡量模型是否输出答案;困难负例是与问题相关却不提供目标答案的干扰材料。
一、问题设定:答案已经进入窗口,模型能否同样使用各个位置
若检索器总把相关结果放最前,普通平均分难以揭示模型依赖开头的程度。这里保持问题、答案和证据内容不变,移动正确文档并控制干扰量,用位置轴区分“能装入”和“能可靠使用”。
论文使用 NaturalQuestions-Open 的2655个问题,选择长答案是段落的样本。每组上下文包含一个来自标注的答案段落和若干不含标注答案的检索段落。干扰项由在 MS-MARCO 上微调的 Contriever 检索,因此比随机无关文本更难。
这不是多跳问答:设计目标是让一个文档足以提供答案,其他文档增加查找和筛选难度。模型不需要环境动作、奖励或参数更新;输入是文档与问题,输出是文本答案,实验测量在固定生成策略下的正确率。
作者还构造随机 UUID 的键值查找。模型看到JSON后,返回指定key对应的value。UUID减少常识和语言语义的影响,便于研究基本复制检索;但自然问答还涉及语义匹配,因此通过键值测试不等于通过长文档理解。
二、把位置效应写成配对评测而不是长度标签
用教学记号定义 :总文档数为 、正确文档位于 时的准确率。可以构造位置差:
这是便于理解的指标表达,不是论文训练损失。理想的位置稳健性意味着 小,但还必须看绝对准确率;所有位置都答错也有很小的位置差。
自构例子,未运行: 一套设备记录中只有一条写着“B型阀门最大温度为120°C”,其余记录多次出现A型阀门的180°C。问题问B型上限。把正确记录从开头移到中间,内容与答案没有变化;若输出变成180°C,就说明模型利用发生了变化。这个实验还应加入型号交换和随机数字版本,减少模型凭熟悉数字猜测的可能。
把位置对照做成同题配对而非换题均值
为每题保存相同文档集合的前、中、后三个排列,逐题记录对错变化,再汇总配对差。若前部条件用了容易题、中部条件用了难题,即使均值差很大也无法归因位置。文档总量与顺序随机种子应一并固定,随后才能另开总长度实验。
三、固定内容、证据与干扰,再单独移动位置
输入:带答案问题、固定模型、文档数列表 K、位置列表 P
for each question:
    relevant = annotated_answer_paragraph(question)
    distractors = retrieve_passages_excluding_annotated_answers(question)
    for k in K:
        selected_distractors = fixed_top_k_minus_1(distractors)
        for position in valid_positions(P, k):
            context = insert(relevant, selected_distractors, position)
            assert full_prompt_fits_model_context
            prediction = greedy_generate(context, question)
            score = contains_any_annotated_answer(prediction)
            record(question, k, position, token_count, score)
report accuracy curves and best/worst positions
需要固定同一问题的干扰项,再移动正确段落,否则内容差异会混入位置效应。扩大 时增加干扰,不改变答案。位置用文档序号控制,真实token距离仍受段落长度影响,因此作者另给token统计。
论文讨论重排序与裁剪作为潜在改进方向,但没有交付一个在所有应用上验证过的最佳排列规则。
自构配对账本。 五道题在前部条件的结果为 ,中部为 ,两者准确率分别为 60% 和 40%,配对差为 20 个百分点。但实际上两题由对变错、一题由错变对,位置效应并非每题都单调。进一步实验可固定总长 4000 token,把相同证据放在约 5%、50%、95% 处,再单独改变总长;否则“更长”和“更靠中间”同时变化,就无法判断是哪一个因素产生差异。
四、联合读取位置曲线、扩容对照与检索饱和
同长度内的前中后对照才隔离位置;随后看扩容、查询放置和多文档检索,分别排查其它解释。
| 维度 | 原文设定 |
|---|---|
| 主问答 | 2655个NaturalQuestions问题;10、20、30篇文档;一个答案段落,其余检索干扰 |
| 对照 | closed-book不提供文档;oracle仅提供正确段落;两者帮助识别上下文的净影响 |
| 主模型 | MPT30B-Instruct、LongChat13B16K、GPT-3.5-Turbo0613及16K版、Claude1.3及100K版 |
| 生成 | 贪心解码;没有把采样多次取最好作为默认 |
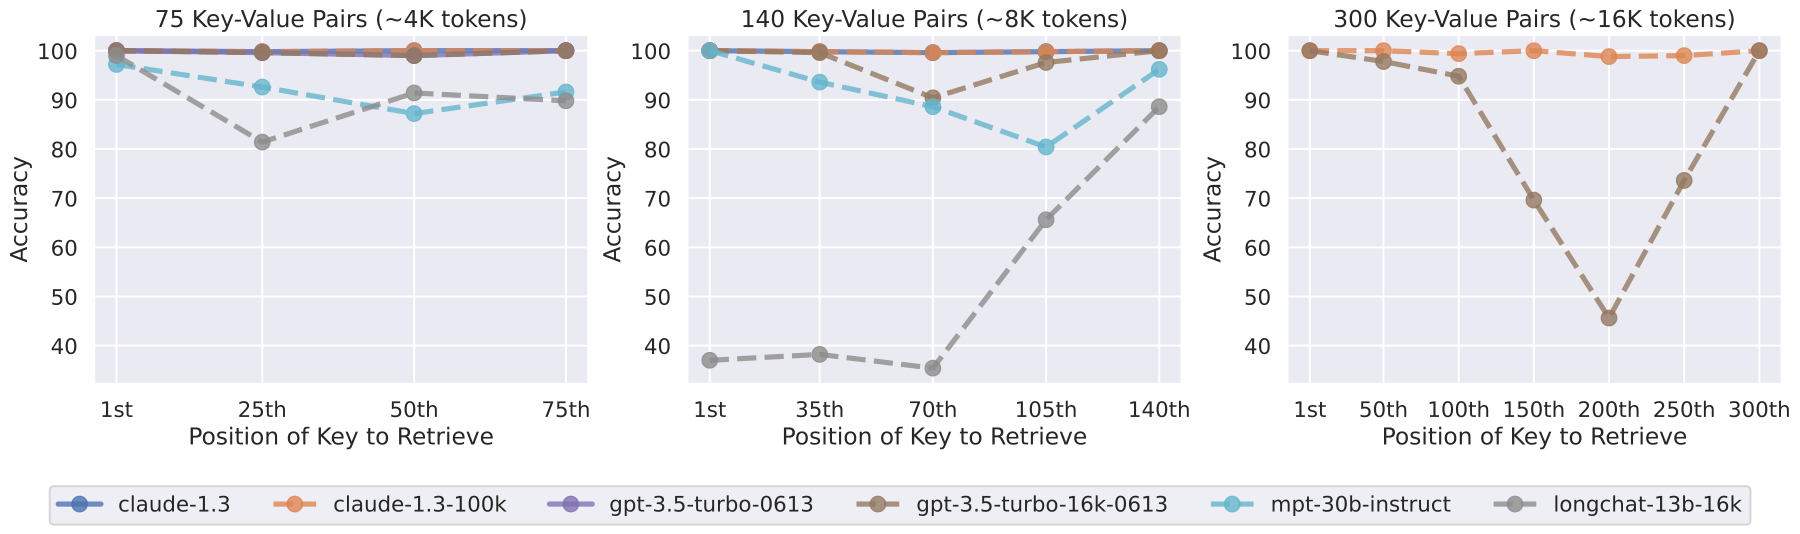
| 键值任务 | 75、140、300对随机唯一UUID,设置各500样本;只评可容纳长度的模型配置 |
| 架构分析 | Flan-T5-XXL与Flan-UL2,比较训练长度内外的位置效果 |
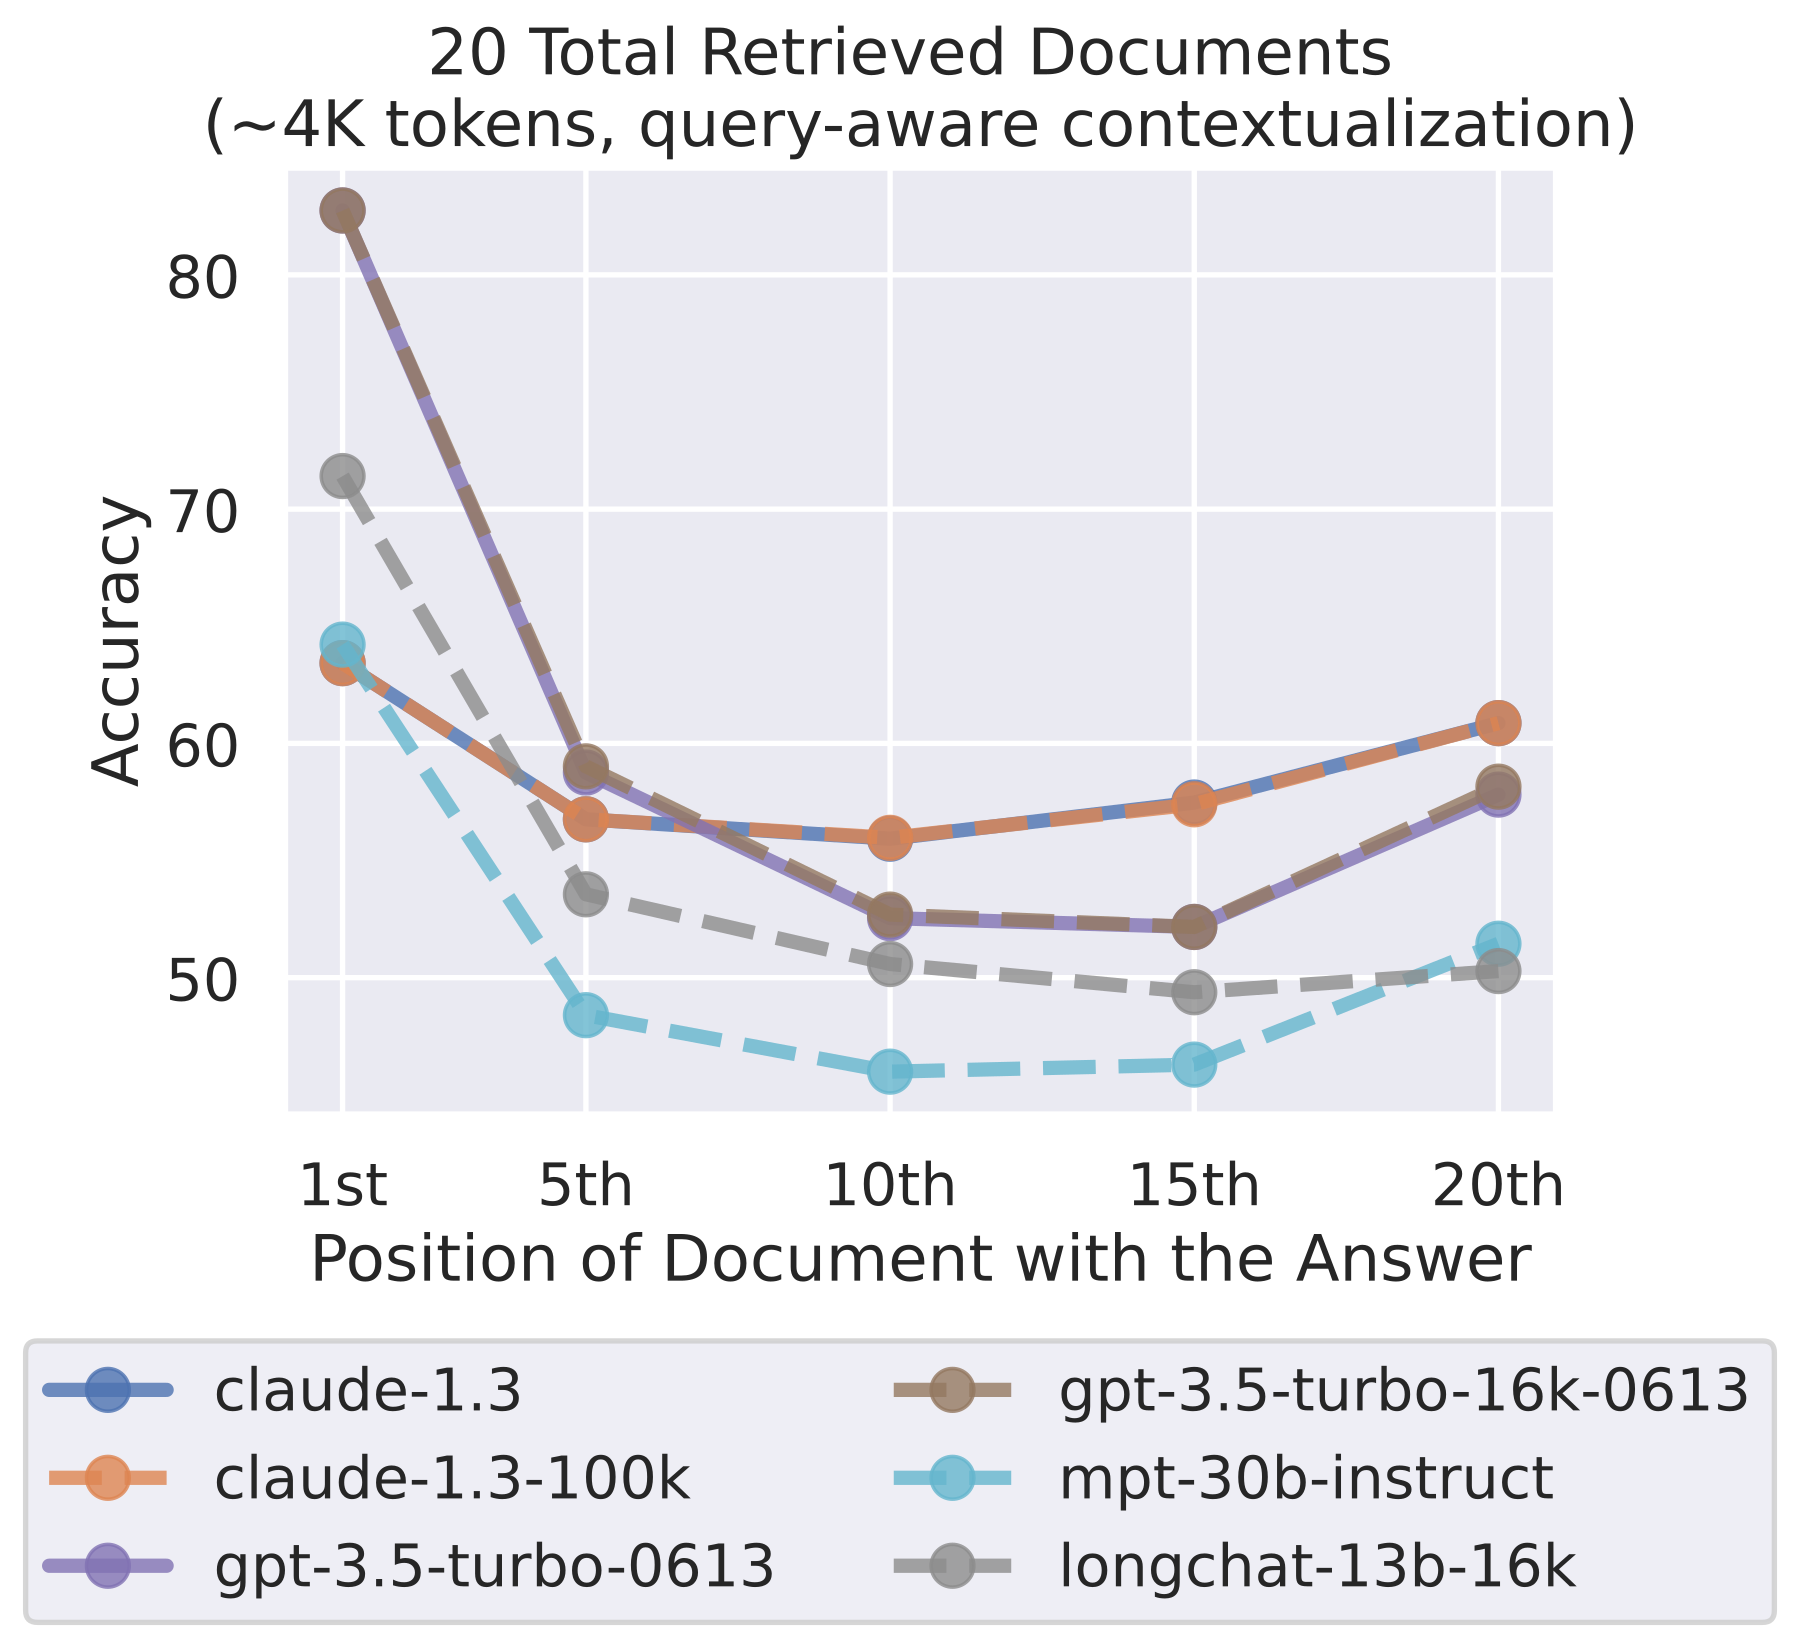
| 查询位置 | 原默认问题在材料后;实验把问题放到材料前后,检查查询感知表示 |
| 补充 | GPT-4的20文档500题子集;Llama2评测因token长度丢弃20题,保留2635题 |
| 准确率定义 | 输出包含任一标注答案,不是严格完整答案exact match,也不是人工判定所有断言真实 |
| 不确定性与成本 | 样本量明确,但未对所有位置提供完整重复API调用区间;不能把token长度标准差当准确率置信区间 |
20篇文档对 GPT-3.5 分词平均约2946.2token,最大3920;30篇平均4419.2,超出4K版本容量。因此30文档表使用16K版本,不能把超过窗口造成的截断和窗口内部利用失败混为一谈。
干扰文档“不含标注答案”也不绝对等于“没有任何合理答案”。时效性与问句歧义可能使检索文档包含另一个合理答案。附录A用无歧义子集重复分析,结论相近;这个检查提高了可信度,但不会令标注变成无误差真值。
证据一:附录表6与主图5,位置改变导致下降。 GPT-3.5在20文档中第一位75.8%、第十位53.8%、末位63.2%,最佳到最低差22.0个百分点,由表值相减。closed-book为56.1%,所以中间条件甚至比不提供文档低2.3个百分点。它支持干扰与位置可能损害使用证据的能力,不证明相关文档没有任何贡献,因为模型也可能被其他材料误导。 位置曲线横轴是证据在输入中的位置,数值越小越靠前;比较中间与两端时,要固定总文档数与任务,避免把长度变化当作纯位置效应。
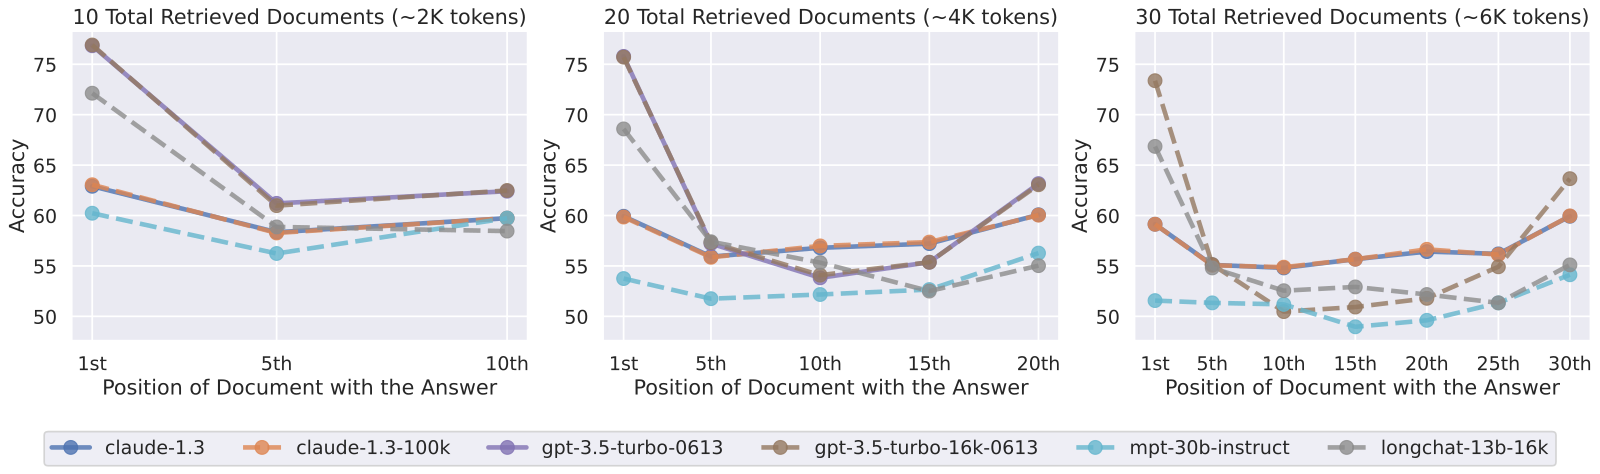
证据二:表1和附录表6,扩容不自动提升利用。 GPT-3.5原版与16K版在20文档首位分别75.8/75.7,中间53.8/54.1;oracle分别88.3/88.6。可容纳相同输入时曲线非常接近。证据范围是这对模型和这些输入,不是所有长上下文训练方法都无效。
证据三:图7、图9与§4.2,简单检索和自然问答不同。 把查询放到材料前后,GPT-3.5-16K在300键值对任务达到完美表现,而原设置最低45.6%;自然问答的位置趋势却没有显著解决。它排除了“前面重复问题总能修好长文档理解”的过度结论,也说明模型需要在何时知道查找目标会影响行为。
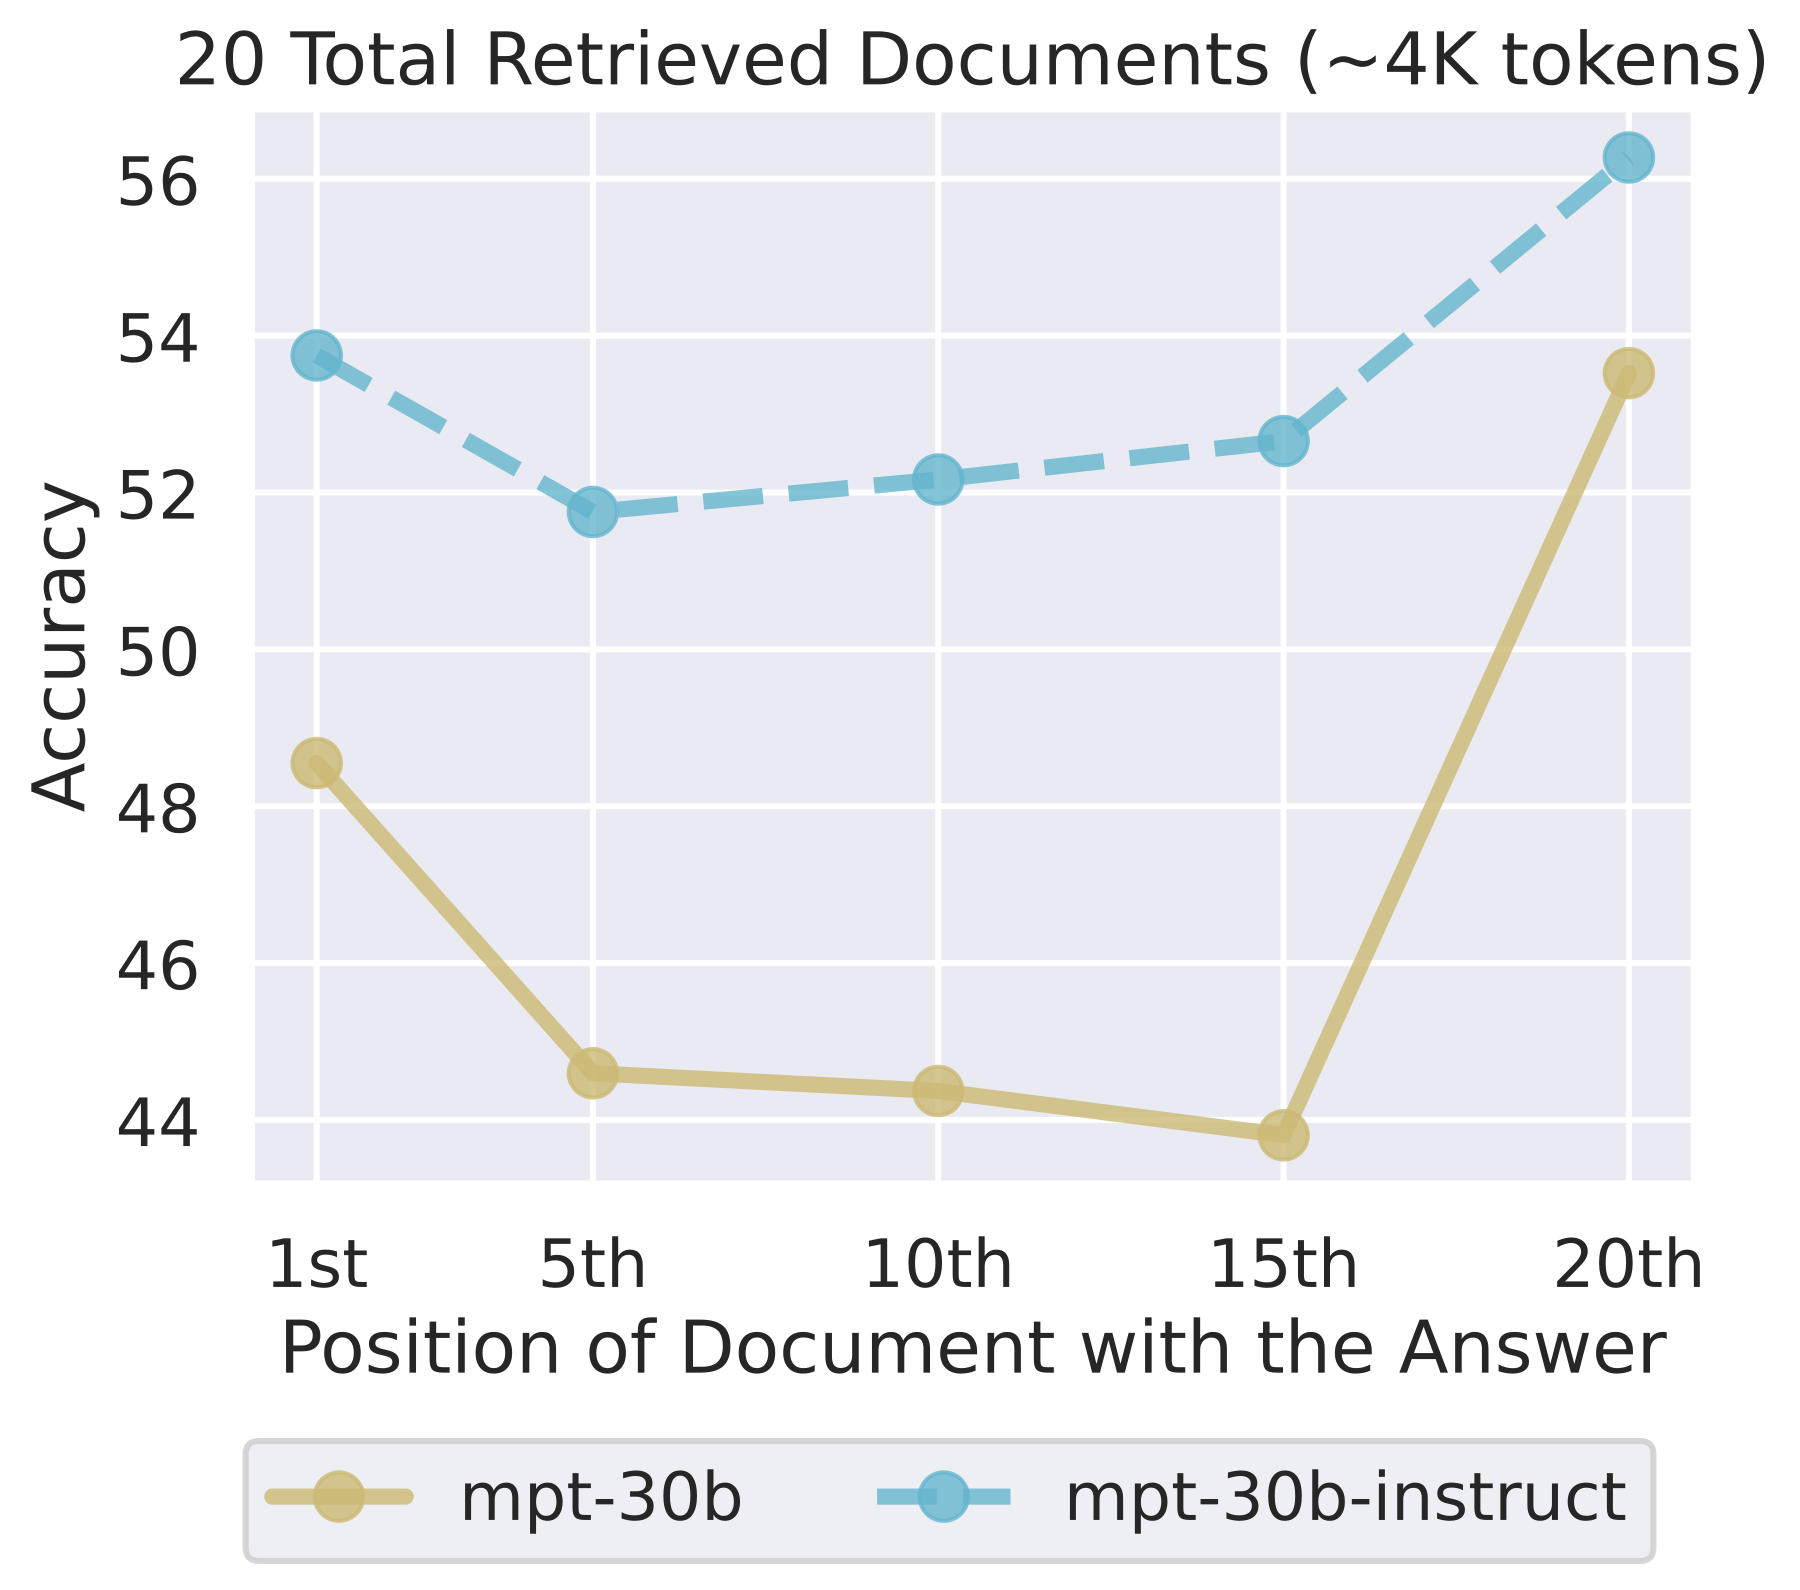
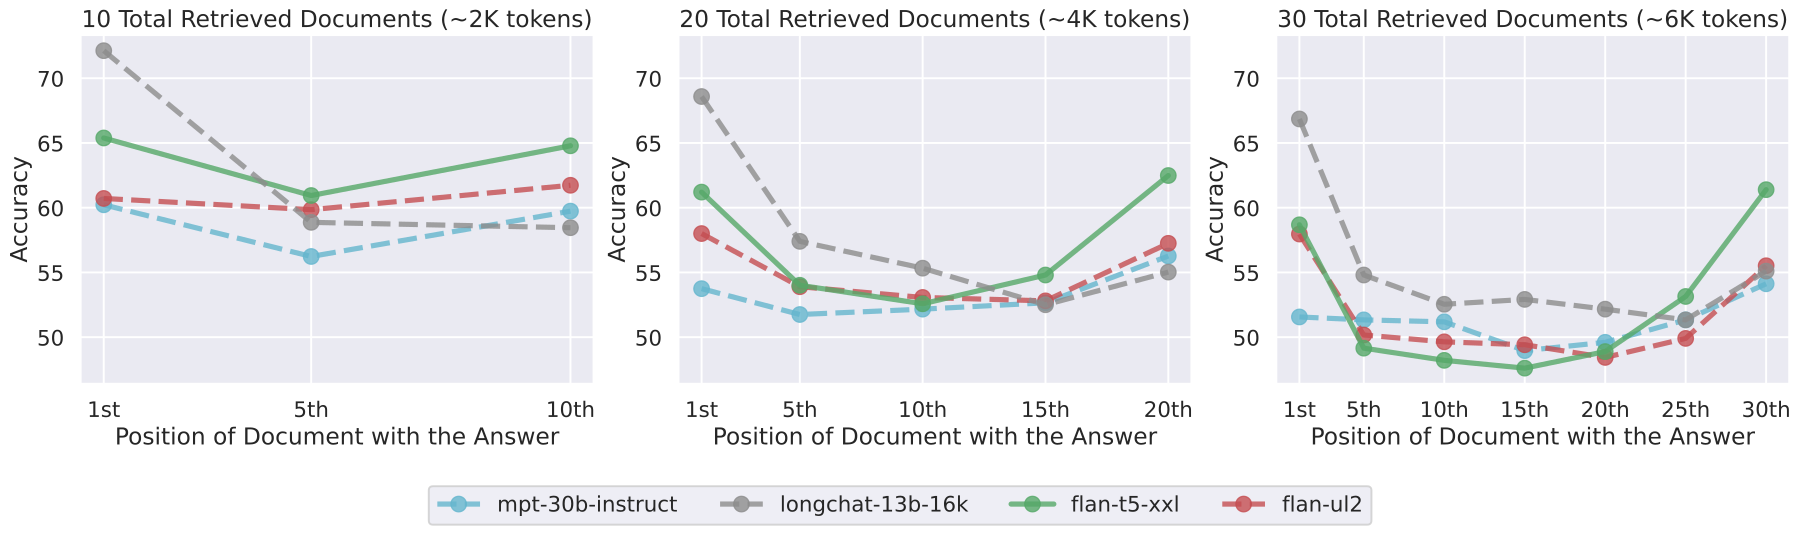
证据四:图8、图10与附录E,成因不唯一。 Flan-UL2在2048训练长度内最佳与最差差1.9个百分点,超出后开始出现中部下降;MPT基础模型和指令模型都有相关趋势。Llama2-7B主要偏向结尾,13B和70B才呈明显两端优势。因此不能把现象只归因于指令微调,也不能声称所有模型曲线必然严格U形。
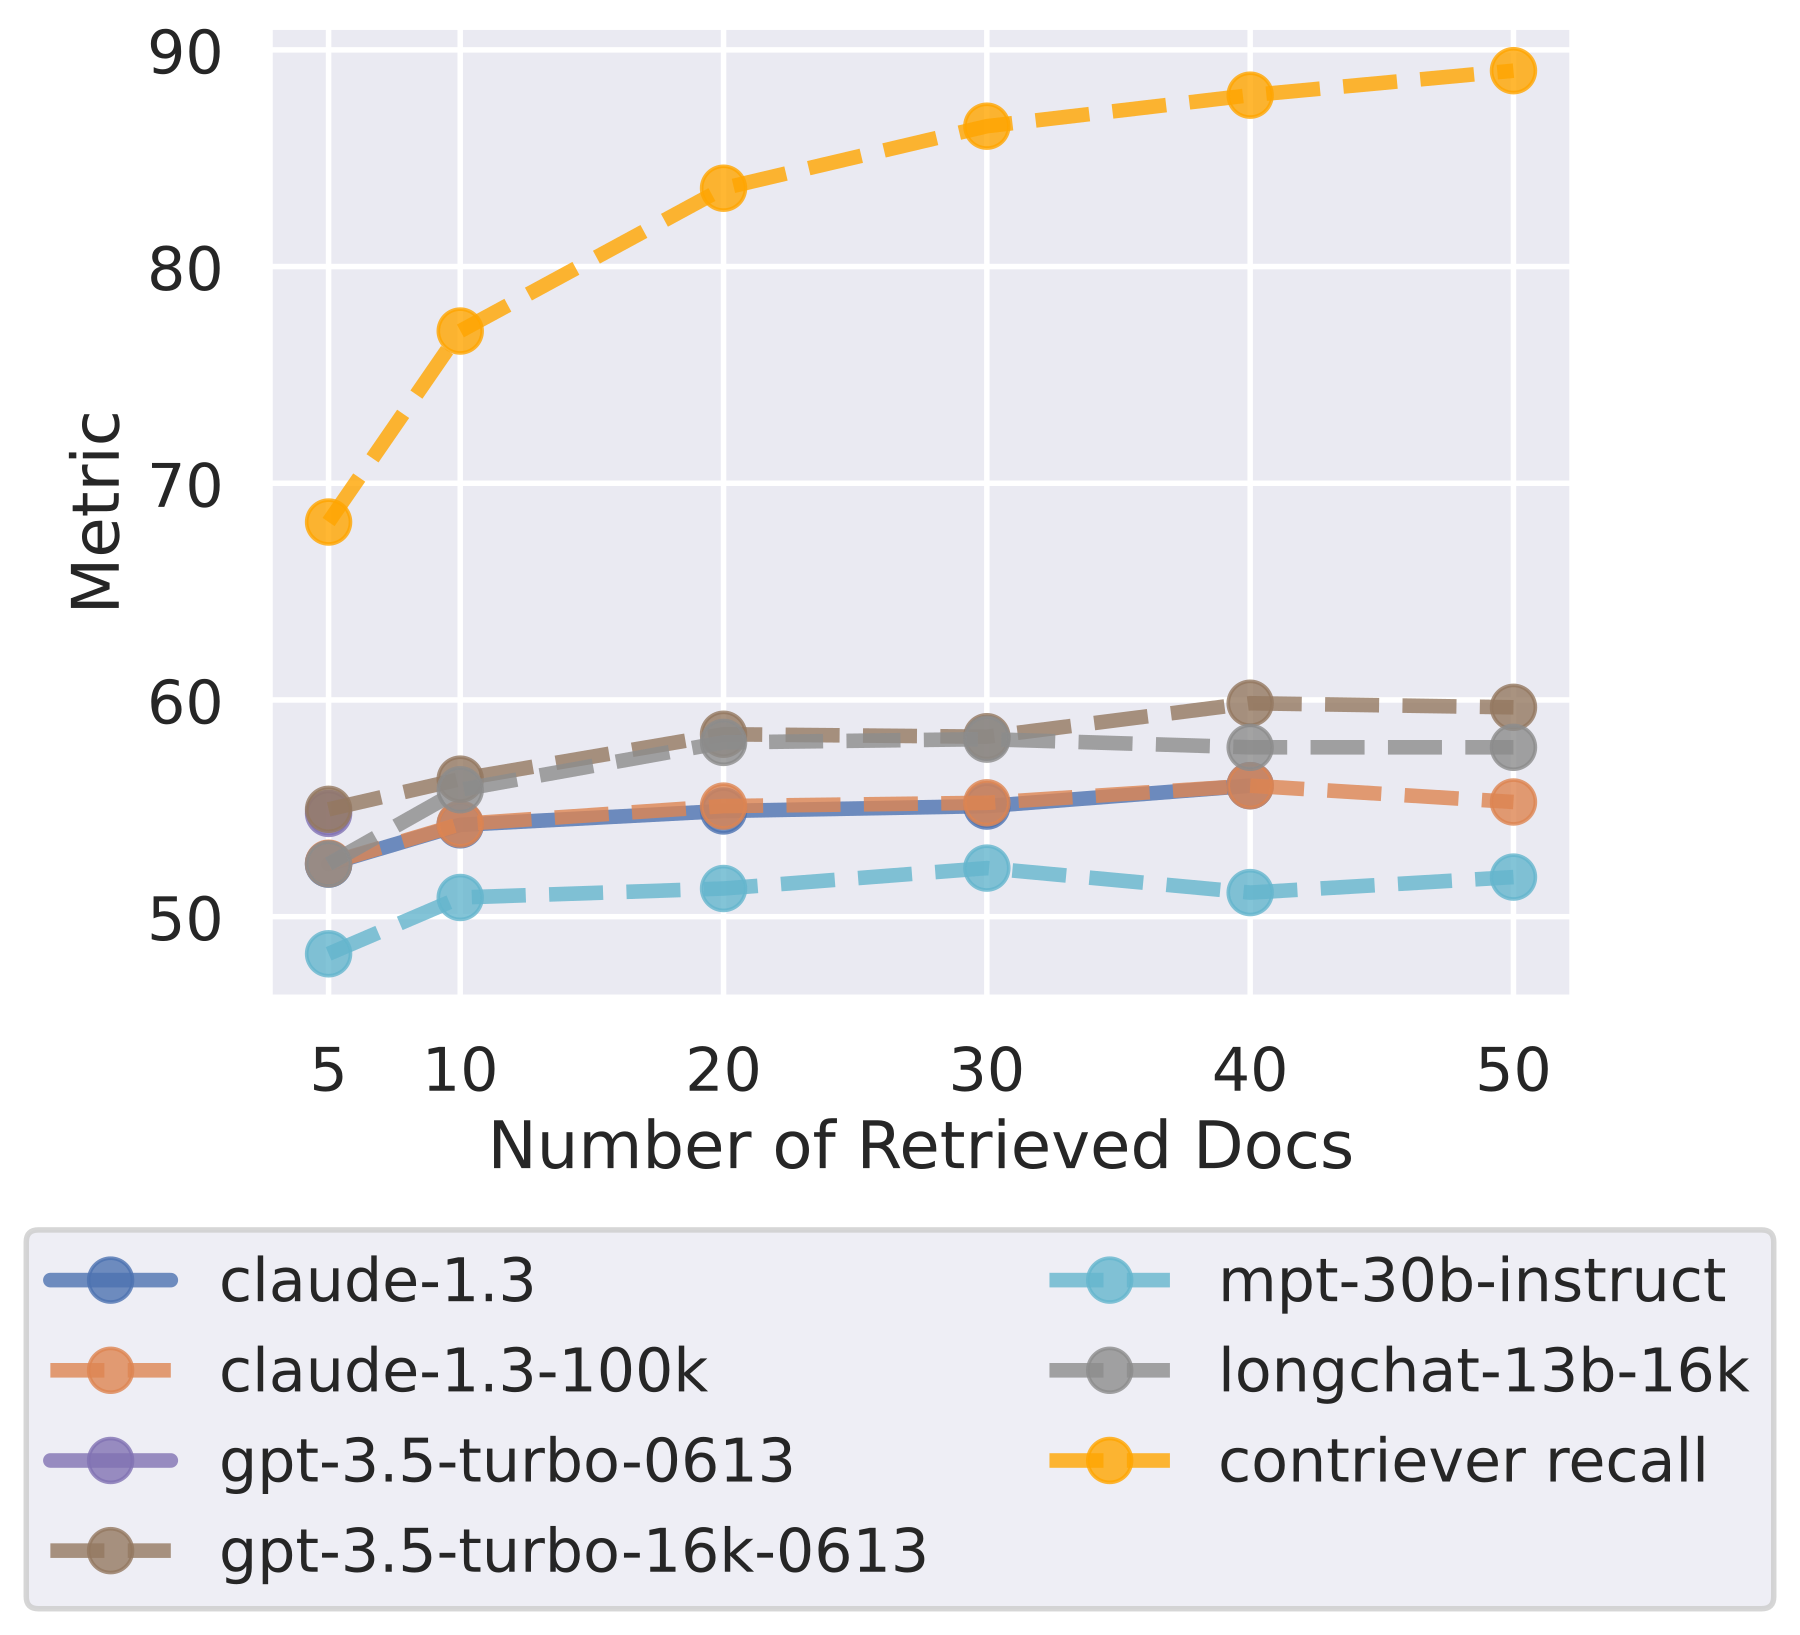
证据五:图11,更多检索不等于更多正确答案。 检索召回随文档数增加,但读者成绩先趋于饱和;从20增至50篇,GPT-3.5仅约提高1.5个百分点,Claude约1个百分点。它说明端到端收益受读者限制,不能只追求Recall@k。不过新增材料也可能对特定问题很有价值,平均饱和不意味着应对每道题都硬性只取20篇。
附录B/C还将干扰改成随机文档、打乱排序并告知顺序随机,仍观察到位置问题。这削弱了“只是检索结果默认排序先验”的单一解释,但没有直接定位到哪层注意力或哪种位置编码。
五、单证据诊断不能代表全部长上下文推理
它特别适合检验RAG读者,因为检索召回高并不保证生成器读取可靠。
作者提供的是初步机制分析,没有证明人类记忆与Transformer有同样成因。U形曲线与心理学序列位置效应相似,只是现象类比。架构差异也伴随训练差异,不能据此把双向编码器视为唯一解决方案。
进一步分析包括:答案包含指标可能奖励同时列出多个候选;UUID测试忽略语义综合;单证据问答不覆盖跨段推理;贪心解码不代表所有预算策略;更换当前模型后需要重新测量,而不是沿用历史百分比。
若要改善系统,可以比较检索重排序、相关片段压缩和按问题动态选文档数,但压缩可能丢失关键限定,重排序也可能把错误证据放到显眼位置。必须同时测答案、引用和证据覆盖,不能只看最终流畅度。
六、把证据放置与检索召回、读者准确率联测
把诊断带回RAG或FiD:先看证据是否召回,再改变相同证据的位置,最后检查答案是否受支持。这样能区分检索漏失、位置使用和生成误读,而非统称长上下文差。
自测与答案
1. 为什么“所有位置准确率都一样”仍不足以证明长上下文能力强?
答案:可能所有位置都答错。需要同时看绝对准确率、位置差、oracle单文档成绩以及无文档成绩;位置稳定性只是可靠使用上下文的必要检查之一。
2. 为什么相关材料已经检索到,最终问答还可能不提高?
答案:读者可能没有定位到它、被相似干扰误导,或者找到证据后仍解释错误。检索召回只保证候选集合覆盖,不保证选择、理解和输出。增加k同时提高覆盖与干扰,需要测两者的净影响。
3. 重复问题修好了UUID检索,为什么不能宣称已经解决“中间遗失”?
答案:UUID任务主要是精确匹配和复制,自然问答还涉及语义对应、歧义与证据选择。原文同一改动对自然问答帮助有限。必须在目标任务上测试,并保留位置、长度和干扰复杂度等维度。