090|GraphRAG:当问题问的是整个资料库,检索几段相似文本还够吗
论文:Darren Edge 等,From Local to Global: A GraphRAG Approach to Query-Focused Summarization,首次公开于 2024。本文依据2025 年修订的 v2,包括新增的声明数量与多样性评估;实现见官方仓库。版本中的实验范围与当前软件全部功能不等同。
图表来源:Darren Edge 等,2024,原文;CC BY 4.0。本篇展示做了图形区域裁切,图中数据与标签未改动。
先接住前作的问题
RAG擅长找局部事实,最相似几段却未必代表资料库的共识与分歧。本篇直接扩展检索问题范围,以社区摘要组织全局主题;Self-RAG检查逐句支持性,是不同的可靠性轴。
五个前置概念
五个前置概念:向量检索按表示相似度找片段;实体对齐判断不同提及是否指向同一对象;社区发现寻找连接紧密的节点组;map-reduce先局部处理再合并;相对胜率表示评估者偏好一方的比例,不是事实准确率。
一、问题设定:局部相关片段怎样扩展为全库观点覆盖
询问公司成立时间可依赖少数片段,询问一批访谈的监管分歧则需要覆盖多方观点和例外。相似度检索没有代表性保证,本篇用图与层级摘要组织跨文档信息,并必须验证图相对无图全局处理究竟增加多少价值。
这是文档问答和面向查询的摘要任务,不是强化学习。模型没有通过环境奖励训练;图也不是可学习的环境动力学模型。输入是资料库与查询,输出是有来源关联的综合回答,系统的新工作主要在索引和推理流程。
作者使用“global sensemaking”强调全局理解。这个任务定义很重要,因为论文的评价问题本来就要求全局覆盖。若实际任务是精确日期、代码行或法律条款定位,不能直接套用这里的相对胜率。
二、用实体社区组织两次压缩并核算统计分母
1. 文本分块与元素抽取
语言模型从每块文本抽取实体、关系和相关声明,并生成描述。抽取结果保留与原文的联系,之后将多次出现的元素聚合。
原实验的实体对齐使用精确字符串匹配。因此同名异物可能被合并,别名可能被拆开。作者认为很多重复节点会聚到相近社区,但这不是普遍保证,更不是已经完成严格实体消歧。
关系在多处出现会影响边权。频繁出现的关系有更大组织作用,却不意味着它更真实;转载、重复报道或偏置语料也会提高频次。
2. Leiden 社区与层次摘要
系统递归进行社区划分。每一层覆盖图中的节点,再向下细分出更具体的主题。它按社区聚合实体、边和声明,生成报告式摘要;高层如果放不下全部原始描述,就用子社区摘要代替。
这里“覆盖所有节点”仅指已抽取的图节点。若某个细节在最初抽取时丢失,完整社区覆盖也不会让它回来;若摘要压缩抹掉了少数观点,后续 map-reduce 同样无法无中生有恢复证据。
3. Map-reduce 回答查询
选择社区层级后,将摘要打乱并打包进多个上下文。各包独立生成与查询相关的局部回答,并自评帮助程度,零分的回答被过滤。其余按评分排序,放入最终窗口,由模型合成全局回答。
随机打乱的作用是分散相关信息,避免它恰好挤在一个窗口而被忽略;它不是随机抽掉大部分资料。局部评分也不是经过训练的、校准良好的置信度,不能把 90 分解释为事实正确概率 90%。
下面是教学抽象。对社区集合 ,预处理生成摘要 ,查询 到来时产生局部答案与评分:
这是系统流程表达,不是原文的新损失函数。 控制抽象粒度,预算决定最终能保留多少局部答案。系统优化的是面向问题的信息组织;实验改善的指标是回答全面性、多样性等,而不是训练交叉熵下降。
高层摘要更少、更便宜,也更容易丢失细节。低层摘要更多,可能覆盖具体观点,却需要更多查询计算。这是可调的索引粒度,而不是一个所有任务共用的固定最佳层级。
两次压缩,为什么“遍历全部社区”仍可能漏掉少数观点?
从原文到社区摘要是第一次压缩,从局部答案到最终窗口是第二次压缩。设三个社区分别含80、15、5份文档,最后每个社区只贡献一份摘要。如果综合时把三份摘要等量对待,就容易把小社区观点看成三分之一的意见;但80/15/5也不能直接当成人群比例,因为文档可能重复、作者可能反复发言。这是原创教学例,说明覆盖单位和统计分母必须先定义。
反过来,若小社区关于某项风险的局部答案自评分较低而未进入最终窗口,第一阶段完整遍历也不会阻止该风险消失。原文 §3.1.6 使用帮助度排序、按预算纳入局部回答,因此最终可追溯性需要检查“哪条陈述来自哪个局部答案、哪个社区、哪些原文”,不能只检查曾经建立过覆盖全图的分区。
索引何时值得摊销? 令一次建索引费用为 ,GraphRAG单次查询费用为 ,无图全局摘要费用为 ,同一索引复用 次。仅比较这些费用时,GraphRAG更省的条件是 ,即在 时 。自构取 个同一计价单位,至少167次查询才跨过收支点。该数值不是论文报价,还未计数据更新、索引重建和质量差异。
所以表2的查询上下文压缩说明“重复问全局问题”可能划算;它不意味着给一个不断更新的资料库只问一次问题也必然节省。原文TS无图基线尤其重要,因为它同时检验全局处理本身能带来多少收益。
假设资料库有 100 次访谈,30 次谈隐私监管、20 次谈开源、10 次谈两者冲突,其余话题分散。查询“技术领导者对开放与监管的主要分歧是什么”时,向量检索可能集中找到措辞最接近的 5 次访谈,却漏掉另一阵营。
社区摘要可以分别保留隐私、开源和交叉讨论,再生成综合比较。但如果抽取器把“反对全面开放”错误归成“支持全面开放”,多层汇总会放大而非修正这个错误。因此好答案应把趋势、相反观点和具体来源分开,而非仅列出更多论点。
追溯链应从最终论断回到原句
一条最终结论先对应某个局部答案,再对应社区摘要,最后才回到原文。若只核对“社区摘要确实这么说”,无法发现第一次压缩已把“部分受访者”变成“所有人”。可逐级保留支持片段与限定词;全面性评委偏爱长答案,也不能替代这条逐声明核查链。
教法联系:Lilian Weng的Extrinsic Hallucinations in LLMs。算例为本文自构。
三、离线建图摘要,再按预算汇总局部回答
离线输入:文档库
将文档切块,抽取实体、关系、声明及来源
合并重复元素,建立加权实体图
递归划分图社区
从底向上生成社区摘要;必要时用子社区摘要压缩内容
保存图、元素来源和各层摘要

在线输入:问题、选定社区层级、上下文预算
打乱该层摘要并打包为多个上下文
并行生成每包的局部答案及帮助评分
过滤零分答案,按评分排序
将预算允许的局部答案汇入最终上下文
生成全局回答及来源关联
四、保留无图全局基线以分离覆盖与图的收益
热图先比较全局与局部,再比较图方法与无图TS;查询token压缩、声明数量和事实准确性是不同测量。
| 项目 | 原文设置 | 要检验的假设 |
|---|---|---|
| 访谈资料 | 1669 个约 600-token 块,100-token 重叠,约百万 token | 跨访谈主题和观点的综合 |
| 新闻资料 | 3197 个同类块,约 170 万 token;涵盖 2013–2023 多类新闻 | 不同主题文档中的全局总结 |
| 问题 | 每库 5 类用户×5 个任务×5 个问题,共 125 题 | 问题由资料库描述及使用情境生成,偏向整体理解 |
| 对照 | C0–C3 四层社区摘要;TS 原文分治摘要;SS 向量检索 | 图组织相对全文处理和局部检索分别有什么贡献 |
| 窗口 | 摘要、局部回答与最终回答统一 8K | 单次上下文容量相同;总调用次数与输入量不同 |
| 评估 | 全面性、多样性、赋能、直接性;每对问题比较重复 5 次 | 相对回答偏好,而非人工金标准准确率 |
| 后续检验 | Claimify 抽取 47075 条回答内去重声明,按 ROUGE-L 距离聚类 | 用声明数和簇数补充主观评判 |
依据 §3–5。访谈图包含 8564 节点、20691 边,新闻图包含 15754 节点、19520 边。访谈索引报告耗时 281 分钟,运行于 16GB RAM 的虚拟机并调用 GPT-4 Turbo API;这个时间包含外部服务条件,不能当作纯本地 CPU 算法复杂度。
相同 8K 窗口只控制每次调用容量。GraphRAG 和 TS 会多次调用模型,SS 主要将检索内容塞进一次回答窗口,因此它们不是总算力严格匹配的实验。图索引费用还能被多次查询摊销,但不能从每次查询输入量中直接忽略。
证据一:图2、附录表6,全局方法优于局部检索的覆盖。 各全局方法对 SS 的全面性胜率在访谈为 72–83%、新闻为 72–80%,多样性也占优。这些区间包括无图 TS,支持“全局处理重要”,不能全部记在图的账上。SS 在直接性上更强,赋能指标则结果混合。 热图中每格是行方法胜过列方法的比例;对角50%是展示用参考值,不是实际完成了自我对比实验。四种评判指标应分别读。
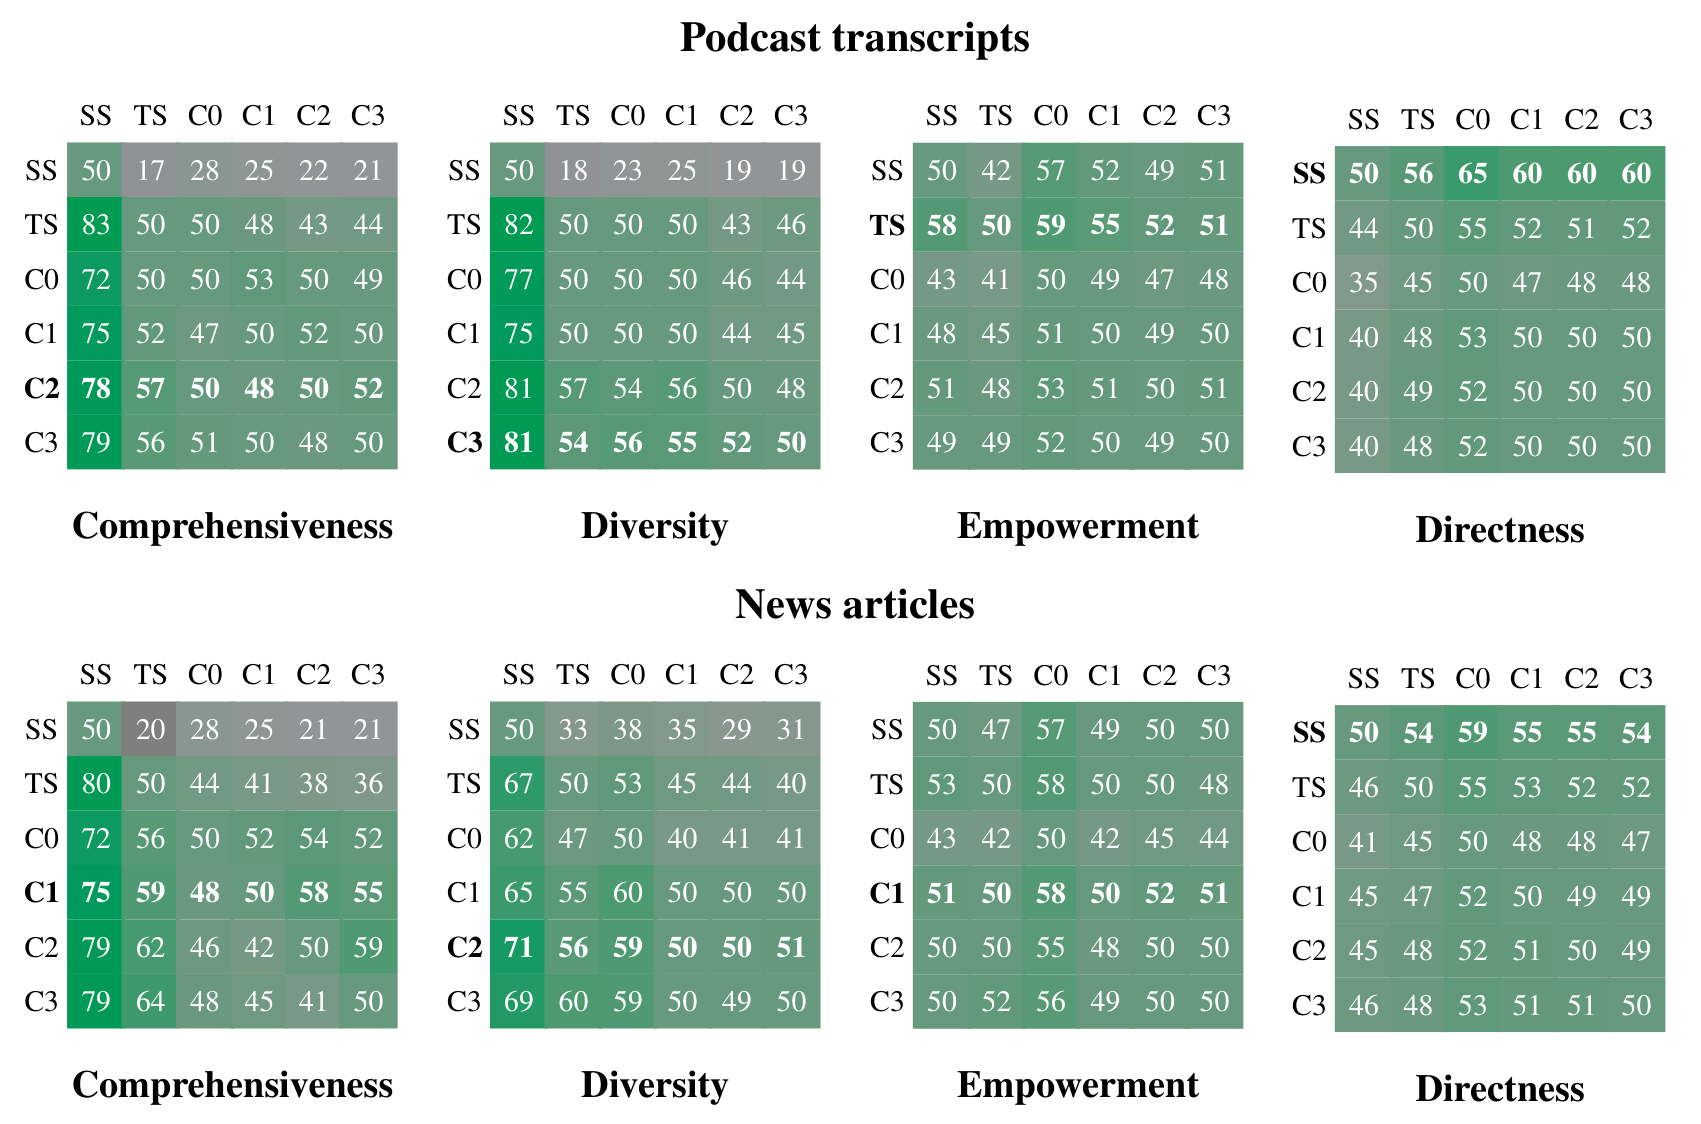
证据二:图2,图相对全文摘要的额外增益较小。 访谈中间层与新闻低层相对 TS 的全面性胜率分别为 57% 和 64%,多样性为 57% 和 60%。这支持社区组织可能有帮助,但远小于对局部 SS 的差距。根层摘要通常更省,却不是所有质量指标的赢家。
证据三:表2,压缩索引降低查询处理量。 访谈 C0 摘要共 26657 token,对比 TS 的 1014611;新闻 C0 为 39770,对比 1707694。按表中数值计算,分别约为原文输入规模的 2.63% 和 2.33%,减少约 97.4% 和 97.7%。这只是所统计的上下文单元 token,不能写成包含建图与输出费用的总成本下降 97%。
证据四:表3、表4,替代指标支持部分结论,也收窄部分结论。 新闻 C0 平均 34.18 条声明,SS 为 25.23;访谈 C2 为 32.46,SS 为 26.50。声明更多与“全面”一致,但并未逐条证明正确。多样性聚类在新闻上依阈值变化;§5.2 还说明全局图方法相互之间、以及它们与 TS 之间没有显著的声明指标差异。
证据五:§5.2,评估器一致性是有条件的。 非平局子集里,LLM 偏好与声明指标的一致比例为全面性 78%、多样性约 69–70%;这些子集仅占全部比较的 33% 和 39%。不能把条件一致率误写成所有答案比较上的一致率。
五、压缩遗漏、索引更新和事实核查仍限制可靠性
它不同于单纯从知识图谱检索三元组,也不同于查询时沿图不断搜索的代理。
建图和层次摘要产生额外费用,更新文档还可能要求更新实体、社区与摘要。长期稳定、多次查询的资料库更容易摊销成本;只问一次或资料高速变化时,是否划算需要重新计量。这是系统成本分析,论文未给出对所有工作负载的盈亏平衡点。
事实性是未充分完成的验证。声明抽取回答中的可验证断言,并不自动核对它们是否与原文一致。声明更多可能是覆盖更好,也可能是增加了错误陈述。作者在 §6.1 明确把生成虚构内容的比较列为进一步工作。
使用语言模型生成问题和判分,可能偏向它擅长的回答风格。重复五次评判减少部分随机性,却不会消除系统性长度偏好、提示偏好或共同知识错误。直接性作为对照有意义,但不能替代长度匹配或人工来源审计。
社区划分也偏向图中连接明显的主题,罕见但关键的孤立事件可能在摘要中弱化。频率不是重要性,更不是真实性。对于决策场景,仍需要回到具体原文,检查时间、否定、冲突和少数观点。
六、让全局覆盖与逐条来源支持共同成立
全局覆盖之外,回看Self-RAG的逐句支持与DeepVerifier的事后查证。社区图可以组织来源,却不能替每条最终声明提供真值或自动发现压缩遗漏。
自测:能否选择正确的比较对象
1. GraphRAG 比向量 RAG 全面,是否证明知识图谱本身不可替代?
不能。无图 TS 也对整个资料库做 map-reduce,在全面性和多样性上同样明显优于 SS。隔离图的作用应比较 C0–C3 与 TS,并同时报告索引、查询总量和质量。论文支持图组织加压缩有价值,不支持所有收益都来自图。
2. C0 查询上下文减少约 97%,为什么不能宣布系统总费用减少 97%?
该比例比较的是摘要与原文上下文单元的 token 数,不包含全部建图、摘要生成、局部回答输出、最终回答和更新费用。总费用还取决于查询次数、模型价格与缓存。只有固定工作负载并把全部阶段计入,才能比较系统总成本。
3. 回答包含更多声明和更多声明簇,是否意味着更值得信赖?
不一定。这些指标反映内容量和表达差异,没有自动验证声明真实性。应回溯引用原文检查支持关系、矛盾和时间范围,并区分有证据的概括与推断。丰富、全面、正确是相关但不同的评价维度。